NvidiaのGR00T 2、人間の動画からロボットが手作業を学ぶ
NvidiaのGR00T 2は人間の動画の手の動きをロボットに移す。訓練なしで成功率40%、5回の実演で95%。ただし実用化への壁はまだ大きい。
Nvidiaは米テキサス州オースティンで開かれたロボット学習の国際会議CoRLで、ロボット向け基盤モデルの第2世代となるGR00T 2を発表した。このモデルは業界の中核的な課題を和らげることを狙っている。これまでロボットが新しい手作業を覚えるには、人間が何時間も遠隔操作するのが一般的だった。The Decoderによると、この遠隔操作(テレオペレーション)は費用が高く、時間がかかり、得られるデータも特定のロボット機種にしか使えない。GR00T 2は代わりに人間の動画に頼る。
動画で未来を予測するモデル
Nvidiaによると、GR00T 2は「ワールド・アクション・モデル」と呼ばれるタイプだ。前世代のGR00T 1と異なり、カメラ画像と言語指示をそのままモーターの動きに変換するのではない。次の動作と、直後の未来を映した短い動画を同時に計算する。つまり、たとえばアームが物をつかむとき、カメラ映像がどう変化するはずかを予測する。Nvidiaの研究報告書によれば、1つの拡散トランスフォーマーが未来の動画と動作のまとまりを一緒に処理し、ロボットごとの小さなモジュールが計画をモーター指令に変換する。
この動画予測を通じて、モデルは異なるロボットの形状の間で動作の流れを移せるとされる。Nvidiaは、平行グリッパー、5本指のハンド、ヒューマノイドで動くとしている。The Decoderによると、学習は1000個を超えるGB300チップのクラスターで行われた。Nvidiaによれば、学習データは次の3種類で構成される。
- 頭部カメラで撮影した、人間の作業を一人称視点で記録した動画40万2730時間
- 手持ちのUMIグリッパーによる、2897タスクにわたる実演1万184時間
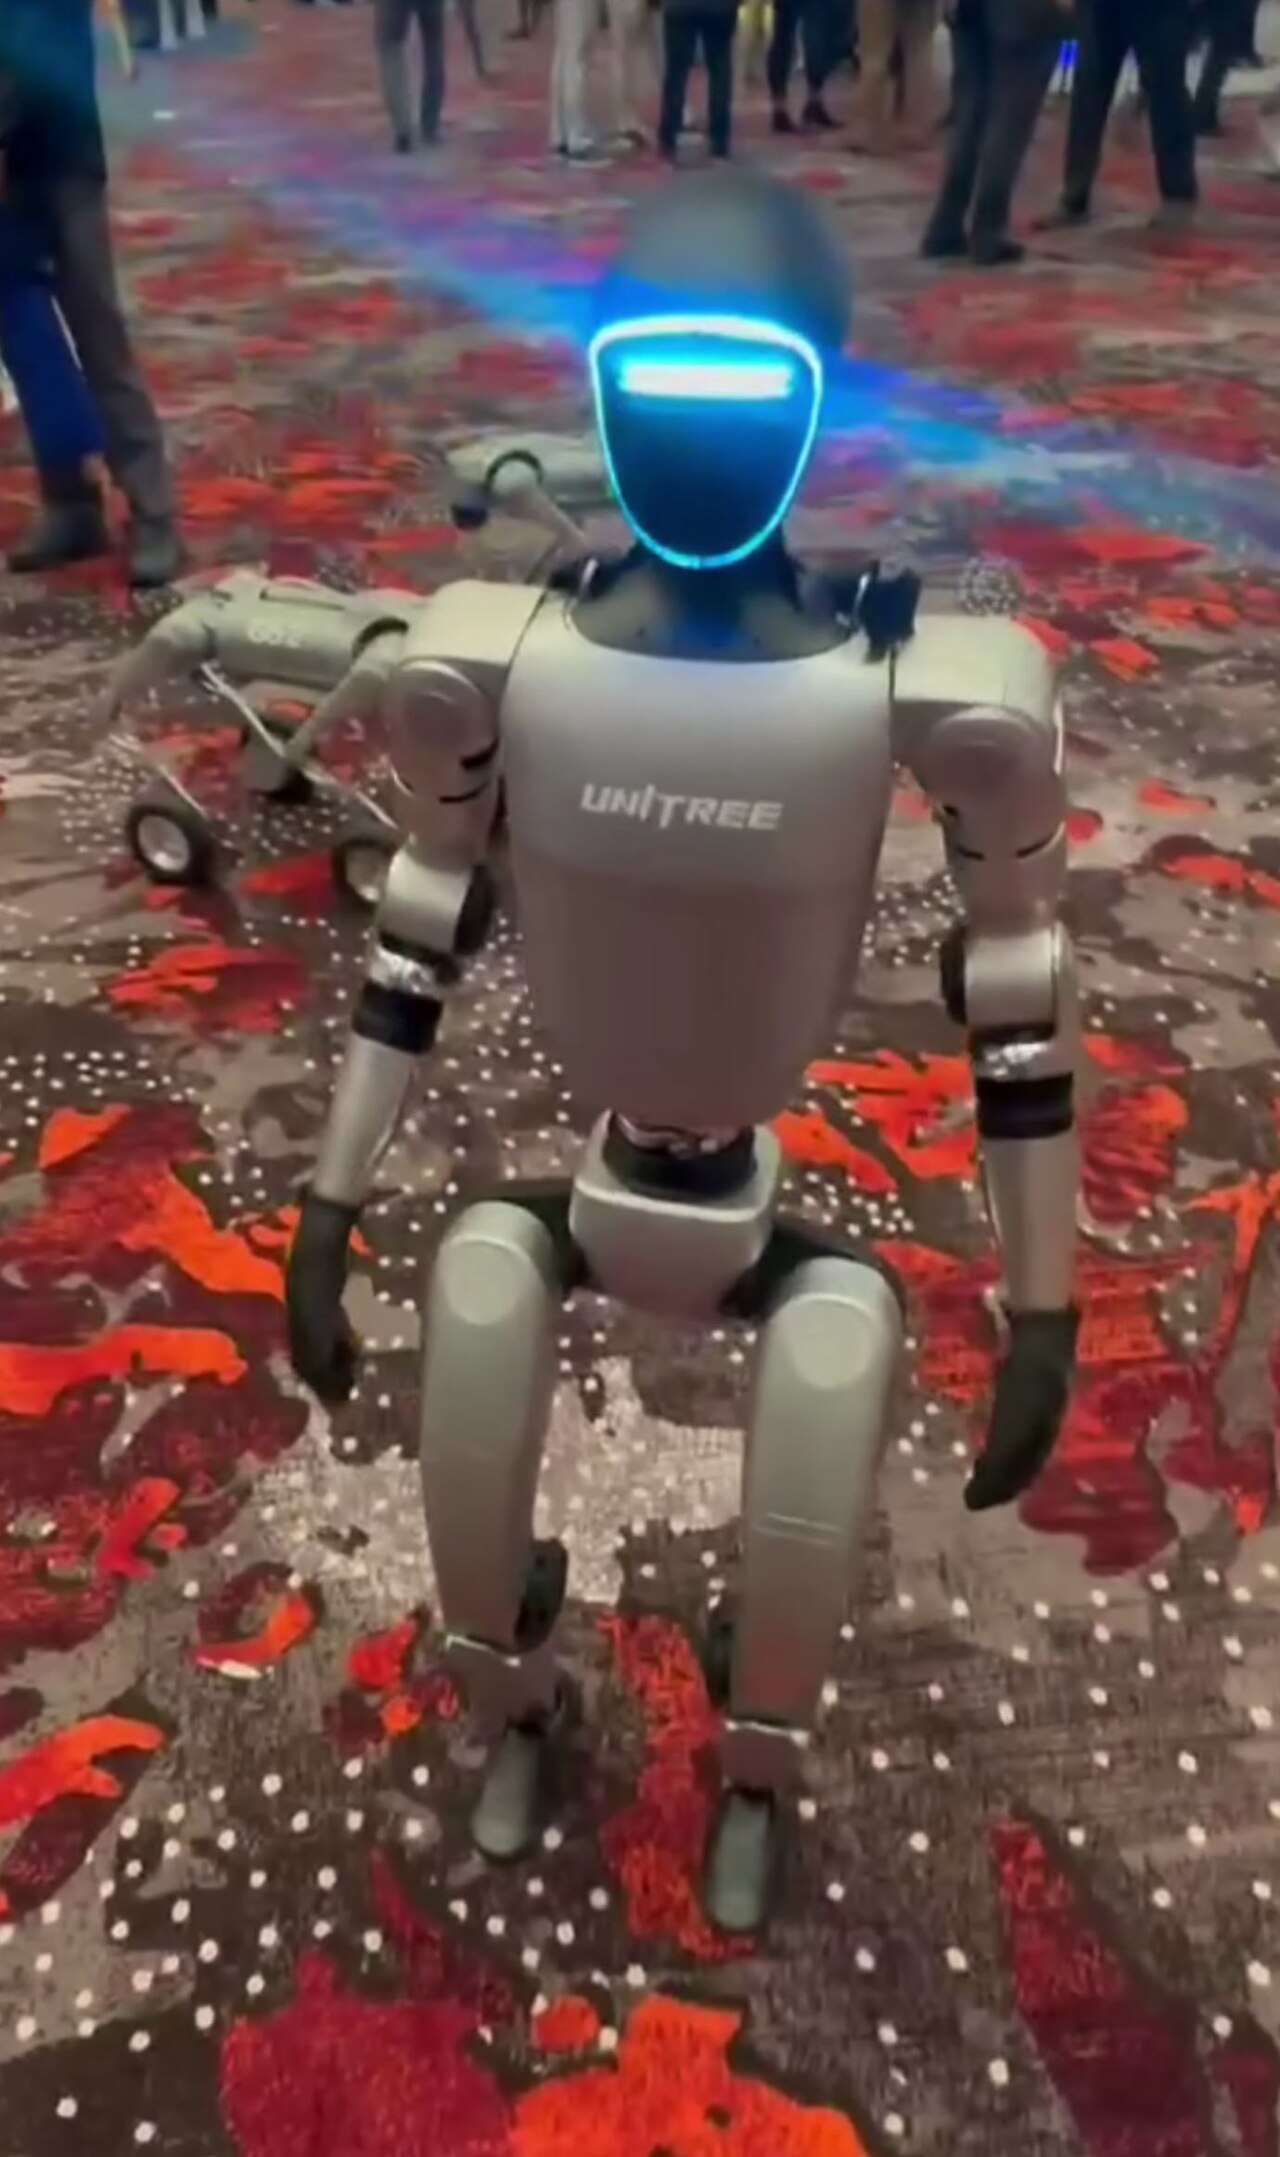
- 平行グリッパーのアーム、SharpaとWujiのハンド、ヒューマノイドUnitree G1などのロボット遠隔操作データ2万3500時間
Nvidiaによると、人間の動画のうち10万時間はHuman-1M-100Kの名称でHugging Faceに公開されている。The Robot Reportは、GR00T 2をオープンな最先端のワールド・アクション・モデルと説明している。モデルの重みの正確なライセンス条件は、今回読んだ資料では確認していない。
数字が示すもの、示さないもの
結果はすべて実験室での試験とNvidia自身によるもので、独立した検証はまだ行われていない。対象ロボットが一度も練習したことのない50タスクで、Nvidiaによればロボットでの実演なしに40%が成功した。タスクごとに1回の実演を加えると成功率は71%に上がり、5回の実演(ロボットデータは合計3分未満)で95%に達した。Nvidiaによれば、RTX 5090グラフィックスカード1枚での30分の微調整で足りる。
人間の動画だけから学ぶ点はとくに注目される。The Decoderによると、5本指の手を2つ持つロボットは、これらの作業のために遠隔操作されることなく、マッチに火をつけ、バナナを切り、荷物をベルトコンベヤーに投げ入れることができた。成功率はタスクによって10〜80%の間で大きくぶれた。Nvidiaによれば、人間がデータグローブ、専用の手持ちグリッパー、指の外骨格で動きを見せれば足りる。ハンマーで打つ1本の動画から、シミュレーションを経由して釘を打つことも学習したという。
2つのSharpa製ハンドを使う細かな作業では、Nvidiaは、GB300メモリモジュールの装着で成功率85%、おもちゃのトラックの組み立てで65%としている。実機での強化学習により、接触の多い3つの差し込み作業は88〜96%に向上した。
指揮者であり、ブレーキでもある言語モデル
長い組み立て作業では、NvidiaはGR00T 2を上位のAI言語モデルと組み合わせ、言語モデルがインターフェース経由でソフトウェアを呼び出す。The Decoderによると、たとえばOpenAIのGPT-6 Astraが使える。言語モデルは作業を手順に分け、カメラ画像上でつかむ位置に印を付け、部品が落ちたときには補助プログラムを起動する。Nvidiaによれば、これにより3種類のおもちゃそれぞれを、100回連続のうち少なくとも97回で完成させた。The Decoderによると、修正役の言語モデルと追加の後訓練がない場合、おもちゃの車の組み立ては100回中23回しか成功しなかった。色付きのつかみ位置の印を使うと、指示に従う割合は92%で、タスク指示だけの場合の40%を上回った。
代償は速度だ。The Decoderによると、ごみの仕分けではロボットは平均7秒以上も計画モデルを待つため、時間の約3分の1は止まっていた。そこでNvidiaは二足歩行ロボット向けに軽量版のGR00T 2 Turboを開発した。Nvidiaによれば、1回の予測に124ミリ秒で、Unitree G1搭載のコンピューターJetson Thor上で直接動く。ロボットは48回の試行すべてでポップコーンをすくい、93%の試行でテーブルを片付けた。足元のタオルで液体を拭く作業は、The Decoderによると、約半数の試行でしか成功しなかった。
実用化に向けて残る課題
- モデルは触覚のための直接のセンサーデータをまだ処理しない。
- 半分しか締まっていないネジなどの細かな失敗を見逃すことがある。
- 成功率のばらつきが大きく、多くのタスクで95%を大きく下回る。
- RoboCasa365、RoboLab、RoboDojo、MolmoSpacesなどのベンチマークで上位3位に入ったという点は、Nvidia自身の主張である。
発表時、Nvidiaはモデルを試している提携先を挙げた。The Robot Reportによると、Foxconnはサーバー製造の工場自動化に使い、Siemensは産業用途での評価を進め、Nexuniはランドリー向けに試している。NvidiaはあわせてIsaac Lab 3.0として、シミュレーションでロボットを訓練するオープンソースのフレームワークの新版も公開した。
日本企業にとっての意味
日本の製造業や物流企業にとって、GR00T 2はまだスイッチを入れればすぐ使える製品ではないが、一つの兆候ではある。ロボットの教え方が、高価な遠隔操作から、動画と少数の実演へ移る可能性がある。これは当編集部の見立てであり、Nvidiaの発言ではない。現実的なのは、バリエーションが多く、つかみ損ねても損失が小さく、成功率が95%を下回っても許容できる作業での小規模な試験導入だ。従業員の動画を訓練素材にしたい企業は、早い段階で個人情報保護の担当者や従業員代表を巻き込むべきだろう。実験室の数字は、自社の部品と自社の現場で確認できて初めて信頼できる。
出典
- GR00T 2 zeigt Nvidias neuen Kurs bei KI-Modellen für RoboterThe Decoder · 2026年11月10日
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and AdaptationNVIDIA Research (GEAR) · 2026年11月10日
- NVIDIA launches GR00T 2 and Isaac Lab 3.0 at CoRLThe Robot Report · 2026年11月10日