Nvidia GR00T 2: los robots aprenden gestos con vídeo humano
GR00T 2 de Nvidia traslada gestos de vídeos humanos a robots: 40 % de éxito sin entrenar, 95 % tras cinco demos. Los límites siguen siendo grandes.
En la conferencia de robótica CoRL, celebrada en Austin (Texas), Nvidia presentó GR00T 2, la segunda generación de su modelo de base para robots. El modelo pretende aliviar un problema central del sector: hasta ahora, los robots aprenden gestos nuevos sobre todo porque personas los manejan a distancia durante horas. Según The Decoder, esta teleoperación es cara, lenta y genera datos que solo sirven para un modelo de robot concreto. GR00T 2 apuesta en cambio por vídeos de personas.
Un modelo que predice el futuro en vídeo
Según Nvidia, GR00T 2 es un llamado modelo mundo-acción. A diferencia de la generación anterior, GR00T 1, no traduce directamente imágenes de cámara y órdenes de lenguaje en movimientos de motor. Calcula a la vez el siguiente movimiento y un breve vídeo del futuro inmediato. Es decir, predice cómo debería cambiar la imagen de la cámara cuando una pinza recoge un objeto, por ejemplo. Según el informe de investigación de Nvidia, un único transformador de difusión procesa conjuntamente el vídeo futuro y el bloque de acciones, y pequeños módulos propios de cada robot traducen el plan en órdenes de motor.
Gracias a esta predicción de vídeo, el modelo debería poder transferir secuencias de movimiento entre cuerpos de robot distintos. Nvidia afirma que funciona con pinzas paralelas, manos de cinco dedos y humanoides. Según The Decoder, el entrenamiento se hizo en un clúster de más de mil chips GB300. Según Nvidia, la mezcla de entrenamiento consta de tres tipos de datos:
- 402.730 horas de vídeo egocéntrico de personas trabajando, grabado con cámaras en la cabeza
- 10.184 horas de demostraciones con una pinza UMI de mano en 2.897 tareas
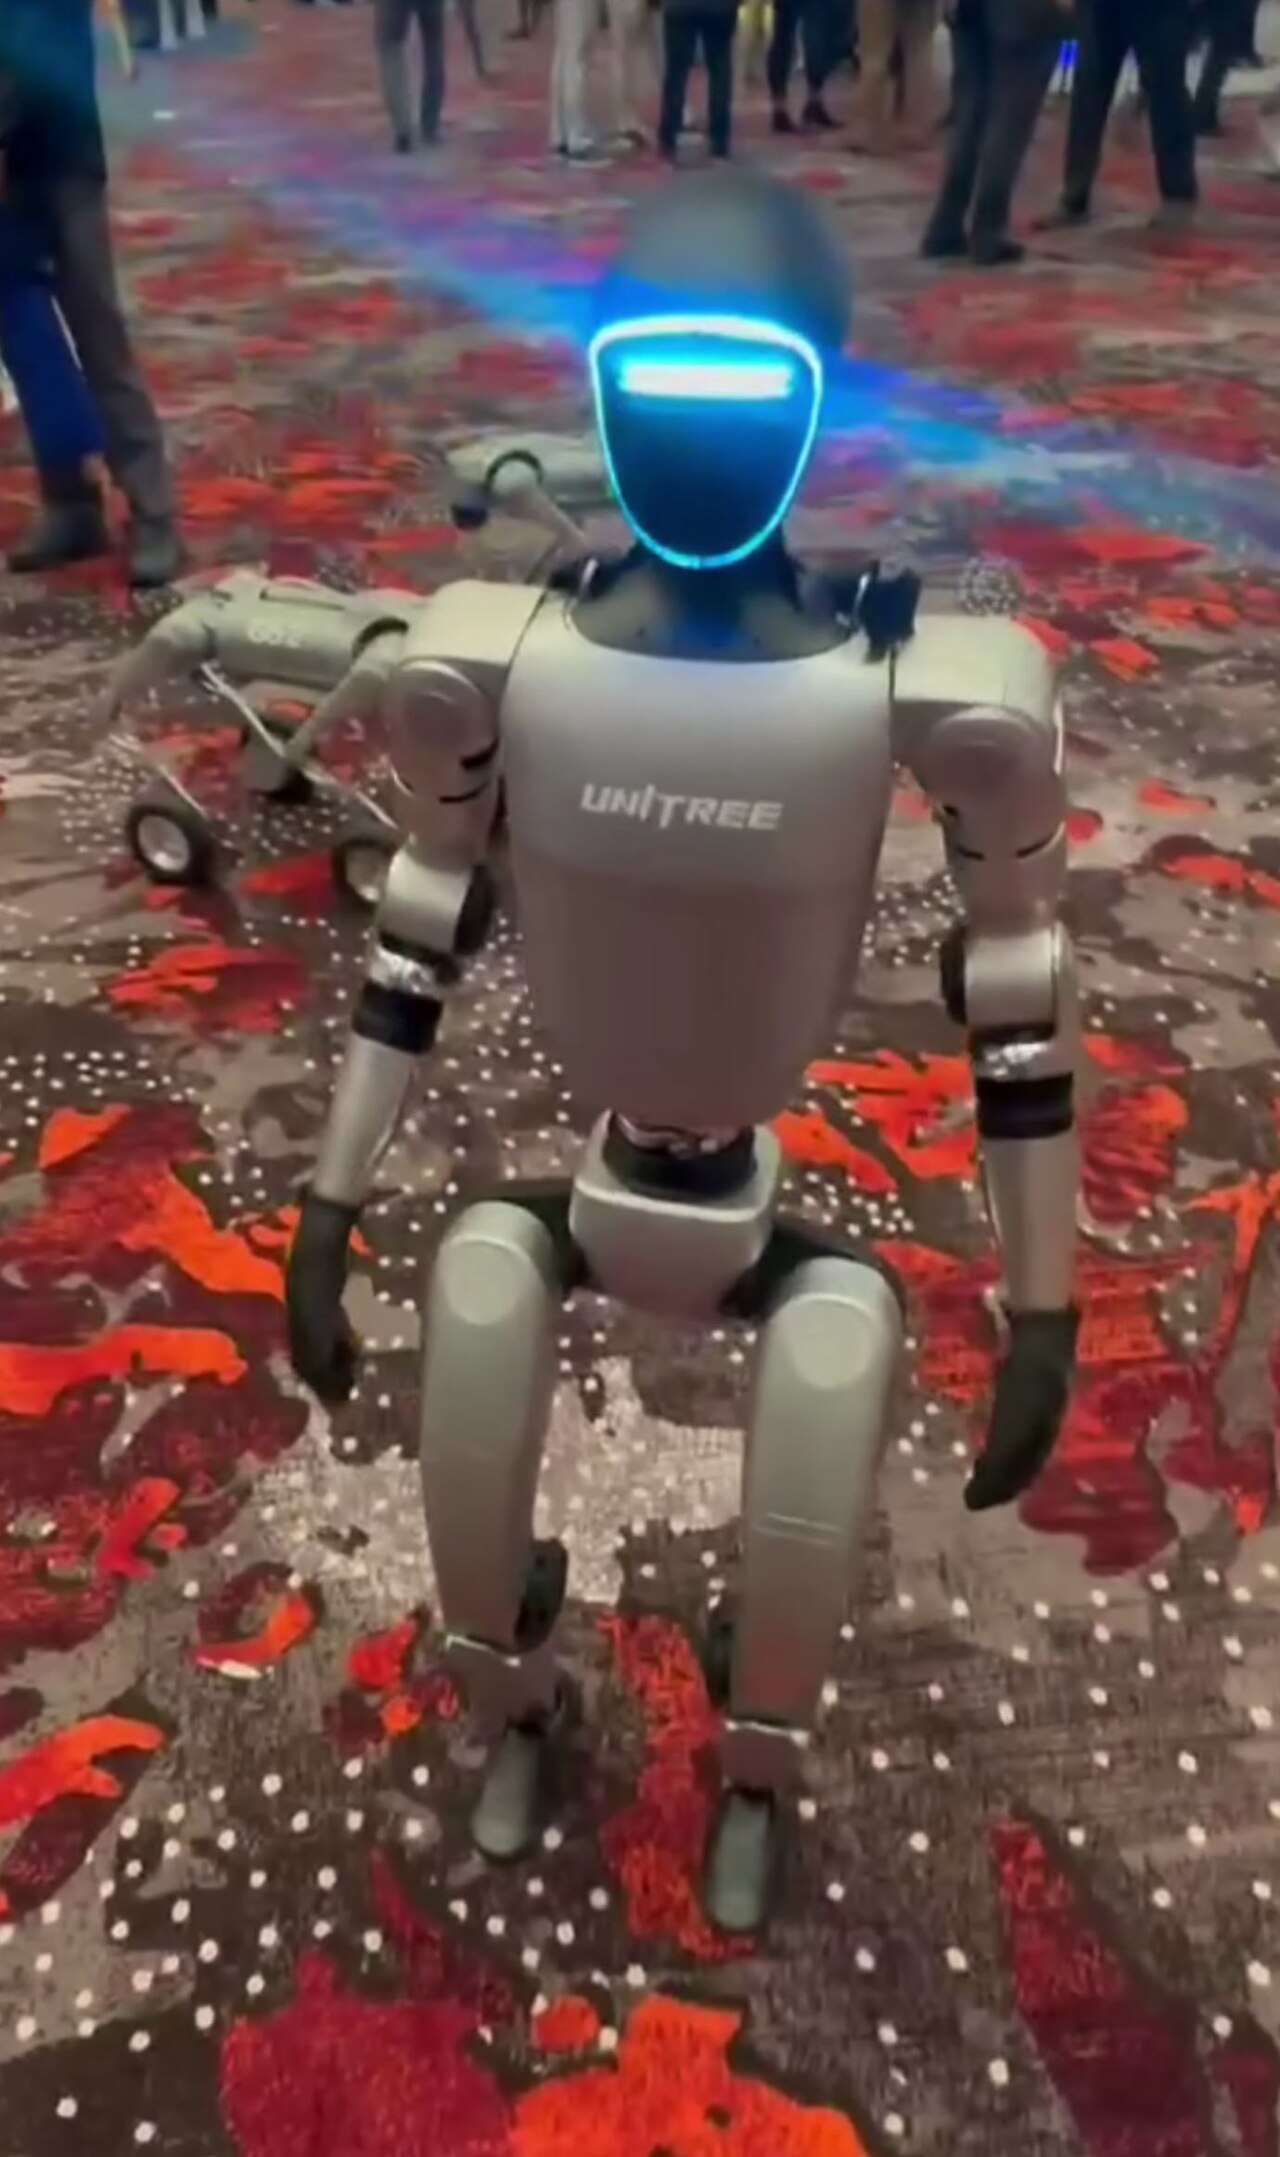
- 23.500 horas de datos de teleoperación de robots, incluidos brazos con pinzas paralelas, manos de Sharpa y Wuji y el humanoide Unitree G1
Según Nvidia, 100.000 horas del vídeo humano están disponibles abiertamente en Hugging Face con el nombre Human-1M-100K. The Robot Report describe GR00T 2 como un modelo mundo-acción abierto de vanguardia. En las fuentes leídas no hemos comprobado las condiciones exactas de licencia de los pesos del modelo.
Qué muestran las cifras y qué no
Todos los resultados proceden de pruebas de laboratorio y de la propia Nvidia; hasta ahora ninguno ha sido verificado de forma independiente. En 50 tareas que el robot de destino nunca había practicado, según Nvidia el 40 % salió bien sin ninguna demostración en el robot. Con una demostración por tarea, la tasa subió al 71 %, y con cinco demostraciones, menos de tres minutos de datos de robot en total, al 95 %. Según Nvidia, basta un ajuste fino de 30 minutos en una sola tarjeta gráfica RTX 5090.
Aprender solo a partir de vídeo humano es especialmente llamativo. Según The Decoder, un robot con dos manos de cinco dedos pudo encender una cerilla, cortar un plátano o lanzar paquetes a una cinta transportadora sin haber sido teleoperado para esas tareas. Las tasas de éxito oscilaron entre el 10 y el 80 % según la tarea. Según Nvidia, basta con que una persona muestre los movimientos con guantes de datos, pinzas manuales especiales o un exoesqueleto de dedos. A partir de un único vídeo de un martillazo, el sistema aprendió además a clavar clavos, pasando por una simulación.
En tareas de motricidad fina con dos manos Sharpa, Nvidia indica un 85 % de éxito al colocar módulos de memoria GB300 y un 65 % al montar un camión de juguete. El aprendizaje por refuerzo en el robot real elevó tres tareas de inserción con mucho contacto a entre el 88 y el 96 %.
Un modelo de lenguaje como director de orquesta y como freno
Para montajes más largos, Nvidia combina GR00T 2 con un modelo de lenguaje de nivel superior que llama al software mediante una interfaz. Según The Decoder, podría ser por ejemplo GPT-6 Astra de OpenAI. El modelo de lenguaje divide la tarea en pasos, marca puntos de agarre en la imagen de la cámara y lanza rutinas de ayuda cuando cae una pieza. Según Nvidia, el robot completó así cada uno de tres juguetes en al menos 97 de 100 ejecuciones seguidas. Sin el modelo de lenguaje corrector y sin entrenamiento adicional, el montaje del coche de juguete solo salió bien en 23 de 100 casos, según The Decoder. Con marcas de agarre de colores, el robot siguió las instrucciones en el 92 % de los casos, frente al 40 % con la sola instrucción de la tarea.
El precio es la velocidad: al clasificar basura, el robot estuvo parado aproximadamente un tercio del tiempo, según The Decoder, porque debía esperar de media más de siete segundos al modelo de planificación. Para robots bípedos, Nvidia ha desarrollado por eso la variante reducida GR00T 2 Turbo. Según Nvidia, necesita 124 milisegundos por predicción y funciona directamente en el ordenador de a bordo Jetson Thor del Unitree G1. El robot sirvió palomitas en los 48 intentos y despejó una mesa en el 93 % de los intentos. Limpiar un líquido con una toalla bajo el pie solo funcionó en cerca de la mitad de los intentos, según The Decoder.
Obstáculos abiertos para el uso real
- El modelo aún no procesa datos directos de sensores para el sentido del tacto.
- A veces pasa por alto errores finos, como tornillos a medio enroscar.
- Las tasas de éxito fluctúan mucho y en muchas tareas quedan muy por debajo del 95 %.
- Los puestos entre los tres mejores en benchmarks como RoboCasa365, RoboLab, RoboDojo y MolmoSpaces son una afirmación de Nvidia.
En el lanzamiento, Nvidia cita socios que prueban el modelo: según The Robot Report, Foxconn lo aplica a la automatización de fábrica para la fabricación de servidores, Siemens lo evalúa para casos de uso industriales y Nexuni lo prueba para lavandería. Con Isaac Lab 3.0, Nvidia presentó además una nueva versión de su framework de código abierto para entrenar robots en simulación.
Qué cambia para las empresas en España
Para fabricantes y operadores logísticos españoles, GR00T 2 todavía no es un producto para enchufar, pero sí una señal: el aprendizaje de los robots podría pasar de la costosa teleoperación a vídeos y unas pocas demostraciones. Es nuestra valoración, no una declaración de Nvidia. Lo razonable es un piloto pequeño en una tarea con muchas variantes, donde un agarre fallido cueste poco y una tasa inferior al 95 % sea tolerable. Las empresas que quieran usar vídeos de sus empleados como material de entrenamiento deberían implicar pronto al delegado de protección de datos y a la representación de los trabajadores. Las cifras de laboratorio solo son fiables cuando se confirman con sus propias piezas y en su propia planta.
Fuentes
- GR00T 2 zeigt Nvidias neuen Kurs bei KI-Modellen für RoboterThe Decoder · 10 de noviembre de 2026
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and AdaptationNVIDIA Research (GEAR) · 10 de noviembre de 2026
- NVIDIA launches GR00T 2 and Isaac Lab 3.0 at CoRLThe Robot Report · 10 de noviembre de 2026