Nvidia GR00T 2: Roboter lernen Handgriffe aus Menschenvideos
Nvidias GR00T 2 überträgt Handgriffe aus Menschenvideos auf Roboter: 40 Prozent Erfolg ohne Training, 95 Prozent nach fünf Demos. Die Grenzen bleiben groß.
Nvidia hat auf der Robotikkonferenz CoRL in Austin (Texas) GR00T 2 vorgestellt, die zweite Generation seines Basismodells für Roboter. Das Modell soll ein Kernproblem der Branche entschärfen: Roboter lernen neue Handgriffe bislang meist, indem Menschen sie stundenlang fernsteuern. Laut The Decoder ist diese sogenannte Teleoperation teuer, langsam und liefert Daten, die jeweils nur für ein bestimmtes Robotermodell taugen. GR00T 2 setzt stattdessen auf Videos von Menschen.
Ein Modell, das die Zukunft im Video vorhersagt
Nach Angaben von Nvidia ist GR00T 2 ein sogenanntes Welt-Aktions-Modell. Anders als die Vorgängergeneration GR00T 1 übersetzt es Kamerabilder und Sprachbefehle nicht direkt in Motorbewegungen, sondern berechnet gleichzeitig die nächste Bewegung und ein kurzes Video der unmittelbaren Zukunft. Es sagt also voraus, wie sich das Kamerabild verändern müsste, wenn ein Greifarm beispielsweise ein Objekt aufnimmt. Laut dem Forschungsbericht von Nvidia arbeitet dafür ein einziger Diffusions-Transformer, der Zukunftsvideo und Bewegungsabschnitt gemeinsam berechnet; kleine Zusatzmodule je Roboter übersetzen den Plan in Motorbefehle.
Über diese Videovorhersage soll das Modell Bewegungsabläufe zwischen unterschiedlichen Bauformen übertragen können. Laut Nvidia läuft es auf Parallelgreifern, Händen mit fünf Fingern und Humanoiden. Das Training fand laut The Decoder auf einem Cluster mit über tausend GB300-Chips statt. Die Trainingsmischung besteht nach Nvidia aus drei Datenarten:
- 402.730 Stunden egozentrische Videos von Menschen bei der Arbeit, aufgenommen mit Kopfkameras
- 10.184 Stunden Demonstrationen mit einem handgehaltenen UMI-Greifer über 2.897 Aufgaben
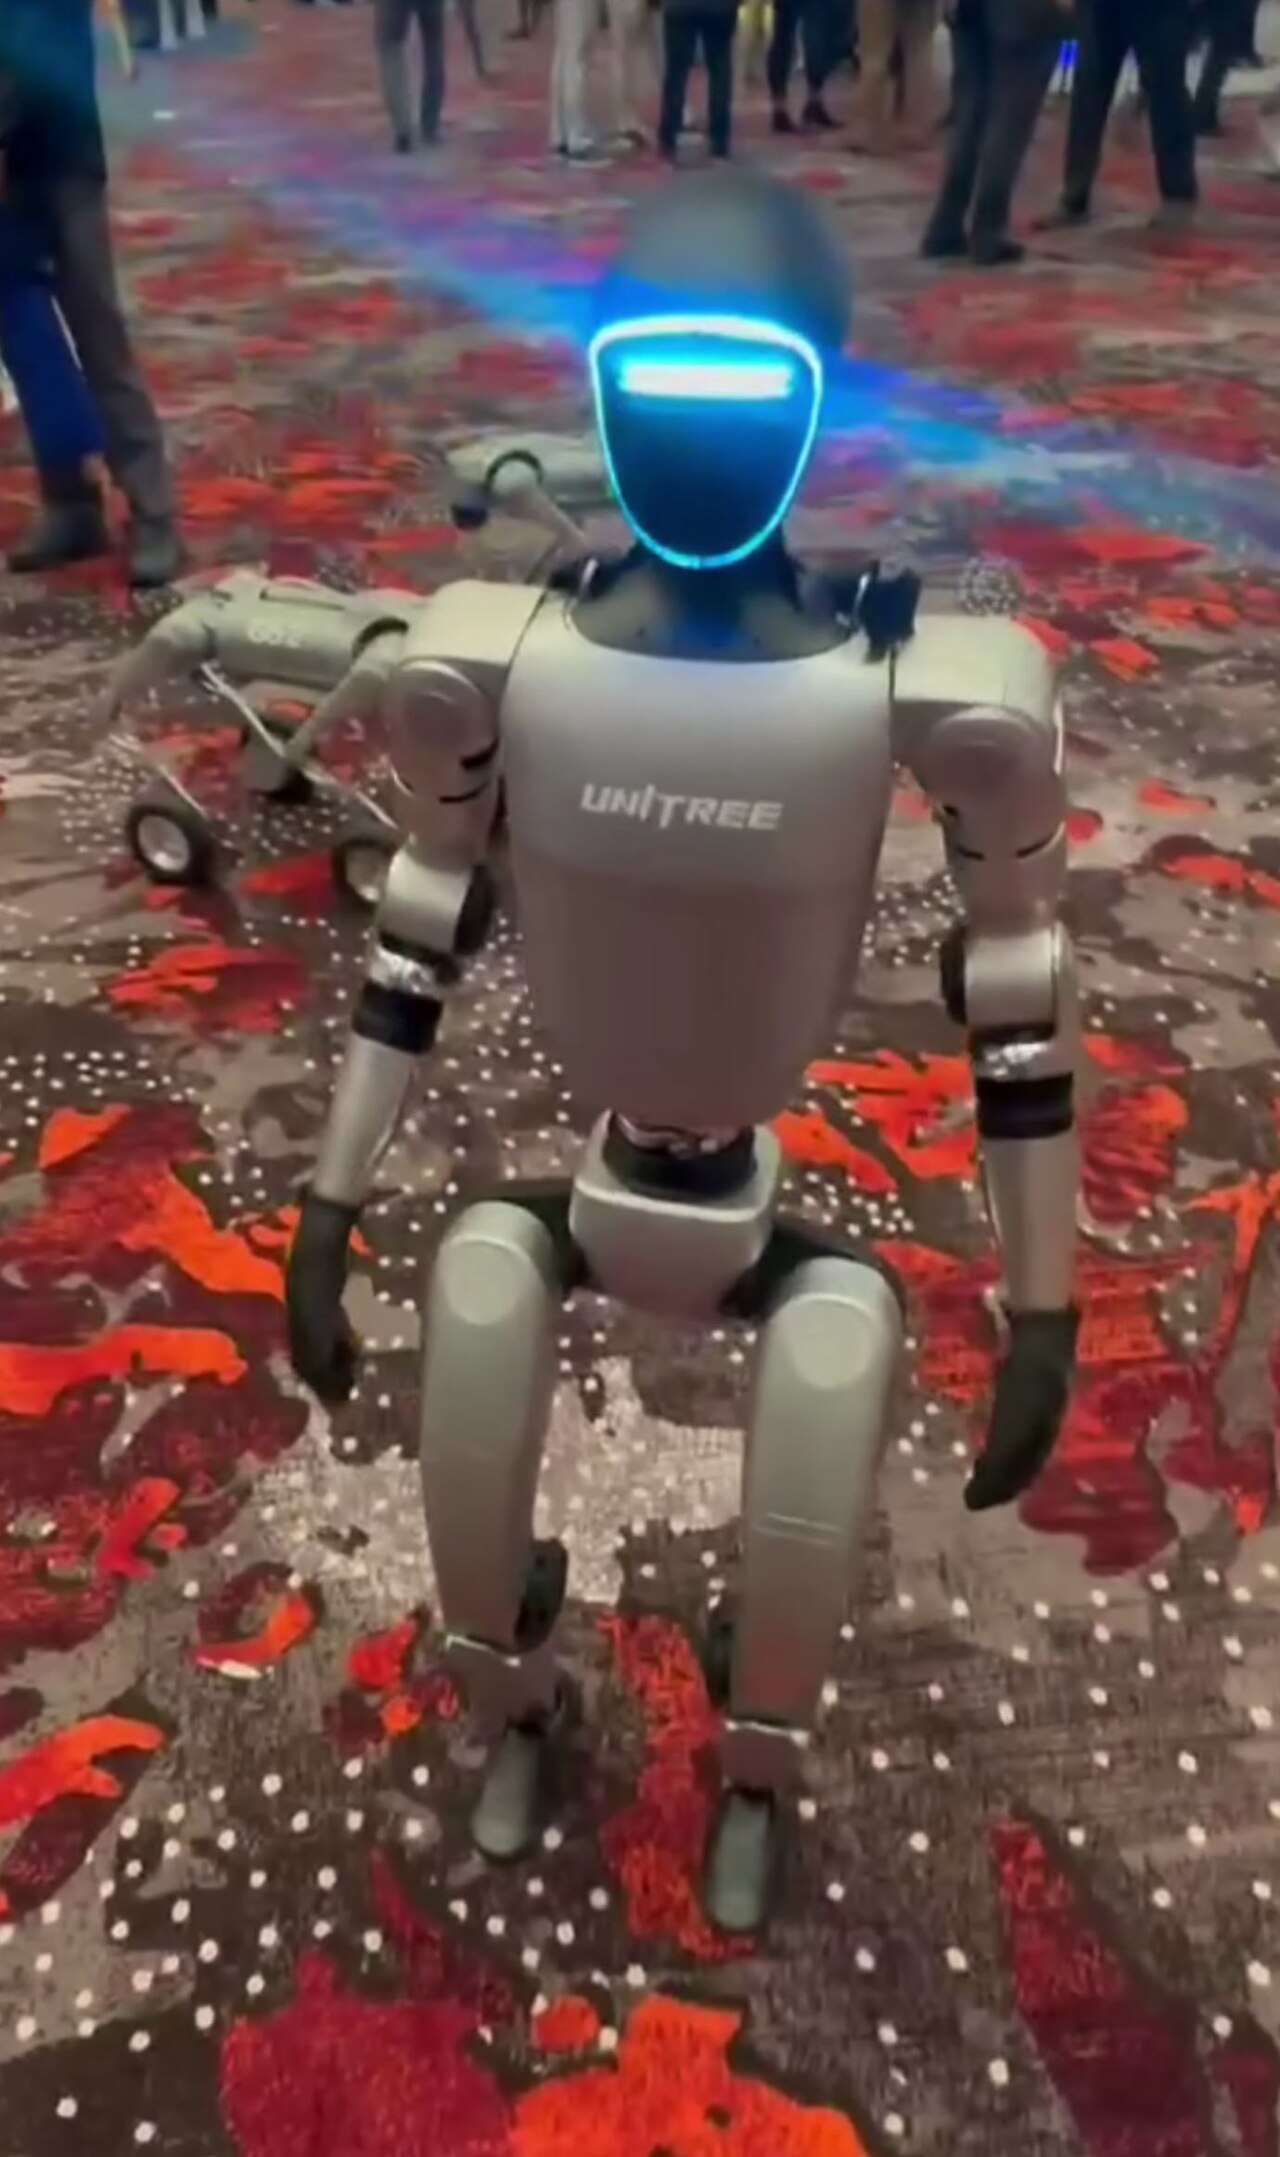
- 23.500 Stunden Teleoperationsdaten von Robotern, darunter Arme mit Parallelgreifern, Hände von Sharpa und Wuji sowie der Humanoide Unitree G1
100.000 Stunden der Menschenvideos stehen laut Nvidia unter dem Namen Human-1M-100K offen auf Hugging Face bereit. The Robot Report beschreibt GR00T 2 als offenes Weltaktionsmodell der Spitzenklasse. Die genauen Lizenzbedingungen für die Modellgewichte haben wir in den gelesenen Quellen nicht geprüft.
Was die Zahlen zeigen – und was nicht
Alle Ergebnisse stammen aus Laborversuchen und von Nvidia selbst; unabhängig überprüft sind sie bislang nicht. Auf 50 Aufgaben, die der Zielroboter nie selbst geübt hatte, gelangen laut Nvidia 40 Prozent ohne jede Demonstration auf dem Roboter. Mit einer Demonstration pro Aufgabe stieg die Quote auf 71 Prozent, mit fünf Demonstrationen – zusammen unter drei Minuten Roboterdaten – auf 95 Prozent. Dafür genügt laut Nvidia ein 30-minütiges Feintuning auf einer einzelnen Grafikkarte vom Typ RTX 5090.
Besonders bemerkenswert ist das Lernen allein aus Menschenvideos. Ein Roboter mit zwei Fünf-Finger-Händen konnte laut The Decoder ein Streichholz anzünden, eine Banane schneiden oder Pakete auf ein Förderband werfen, ohne dafür ferngesteuert worden zu sein. Die Erfolgsquoten schwankten je nach Aufgabe zwischen 10 und 80 Prozent. Nach Nvidia genügt es, wenn ein Mensch die Handgriffe mit Datenhandschuhen, speziellen Handgreifern oder einem Finger-Exoskelett vormacht. Aus einem einzelnen Video eines Hammerschlags lernte das System über den Umweg einer Simulation zudem, Nägel einzuschlagen.
Bei feinmotorischen Aufgaben mit zwei Sharpa-Händen nennt Nvidia 85 Prozent Erfolg beim Einsetzen von GB300-Speichermodulen und 65 Prozent beim Zusammenbau eines Spielzeuglasters. Verstärkendes Lernen am echten Gerät hob drei Steckaufgaben mit engem Kontakt auf 88 bis 96 Prozent.
Sprachmodell als Dirigent – und als Bremse
Für längere Montagearbeiten kombiniert Nvidia GR00T 2 mit einem übergeordneten KI-Sprachmodell, das die Software über eine Schnittstelle aufruft. Laut The Decoder kann das etwa OpenAIs GPT-6 Astra sein. Das Sprachmodell zerlegt die Aufgabe in Schritte, markiert Greifpunkte im Kamerabild und startet Hilfsprogramme, wenn ein Bauteil herunterfällt. Nach Nvidia schloss der Roboter so je drei Spielzeugmodelle in mindestens 97 von 100 Durchgängen hintereinander ab. Ohne das korrigierende Sprachmodell und zusätzliches Nachtraining gelang der Zusammenbau des Spielzeugautos laut The Decoder nur in 23 von 100 Fällen. Mit farbigen Greifmarkierungen folgte der Roboter den Anweisungen in 92 Prozent der Fälle, gegenüber 40 Prozent mit der reinen Aufgabenanweisung.
Der Preis ist Tempo: Beim Müllsortieren stand der Roboter laut The Decoder rund ein Drittel der Zeit still, weil er im Schnitt über sieben Sekunden auf das Planungsmodell warten musste. Für zweibeinige Roboter hat Nvidia deshalb die abgespeckte Variante GR00T 2 Turbo entwickelt. Sie braucht laut Nvidia 124 Millisekunden pro Vorhersage und läuft direkt auf dem Bordrechner Jetson Thor des Unitree G1. Der Roboter schöpfte in allen 48 Versuchen Popcorn und räumte in 93 Prozent der Versuche einen Tisch ab. Flüssigkeit mit einem Handtuch unter dem Fuß aufzuwischen gelang laut The Decoder nur in knapp der Hälfte der Fälle.
Offene Hürden für den Praxiseinsatz
- Das Modell verarbeitet bislang keine direkten Sensordaten für den Tastsinn.
- Es übersieht mitunter feine Fehler wie halb eingedrehte Schrauben.
- Die Erfolgsquoten schwanken stark und liegen bei vielen Aufgaben weit unter 95 Prozent.
- Die Platzierungen unter den drei besten Modellen in Benchmarks wie RoboCasa365, RoboLab, RoboDojo und MolmoSpaces sind eine Behauptung von Nvidia.
Zum Start nennt Nvidia Partner, die das Modell testen: Foxconn wendet es laut The Robot Report in der Fabrikautomatisierung für die Serverfertigung an, Siemens prüft es für industrielle Einsatzfälle, Nexuni testet es für Wäschereien. Mit Isaac Lab 3.0 stellte Nvidia zugleich eine neue Version seines quelloffenen Frameworks für Roboter-Training in der Simulation vor.
Was das für Unternehmen in Deutschland ändert
Für Fertiger und Logistiker in Deutschland ist GR00T 2 noch kein Produkt zum Einschalten, aber ein Signal: Das Anlernen von Robotern könnte sich von teurer Fernsteuerung hin zu Videos und wenigen Demonstrationen verschieben. Das ist unsere Einschätzung, keine Aussage von Nvidia. Sinnvoll ist ein kleiner Pilot an einer Aufgabe mit hoher Variantenvielfalt, bei der Fehlgriffe wenig kosten und eine Quote unter 95 Prozent tragbar ist. Wer Videos von Beschäftigten als Trainingsmaterial nutzen will, sollte früh Datenschutz und Betriebsrat einbinden. Die Zahlen aus dem Labor sind erst dann belastbar, wenn sie an eigenen Teilen und in der eigenen Halle bestätigt sind.
Quellen
- GR00T 2 zeigt Nvidias neuen Kurs bei KI-Modellen für RoboterThe Decoder · 10. November 2026
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and AdaptationNVIDIA Research (GEAR) · 10. November 2026
- NVIDIA launches GR00T 2 and Isaac Lab 3.0 at CoRLThe Robot Report · 10. November 2026