Nvidia GR00T 2 : les robots apprennent via des vidéos humaines
GR00T 2 de Nvidia transfère les gestes de vidéos humaines aux robots : 40 % de réussite sans entraînement, 95 % après cinq démos. Les limites restent grandes.
Lors de la conférence de robotique CoRL à Austin (Texas), Nvidia a dévoilé GR00T 2, la deuxième génération de son modèle de fondation pour robots. Le modèle doit atténuer un problème central du secteur : jusqu'ici, les robots apprennent surtout de nouveaux gestes parce que des humains les pilotent à distance pendant des heures. Selon The Decoder, cette téléopération est coûteuse, lente et produit des données qui ne valent que pour un modèle de robot précis. GR00T 2 mise à la place sur des vidéos d'humains.
Un modèle qui prédit l'avenir en vidéo
Selon Nvidia, GR00T 2 est un modèle dit monde-action. Contrairement à la génération précédente, GR00T 1, il ne traduit pas directement les images de caméra et les ordres en langage en mouvements moteurs. Il calcule en même temps le prochain mouvement et une courte vidéo du futur immédiat. Autrement dit, il prédit comment l'image de la caméra devrait changer lorsqu'une pince saisit un objet, par exemple. D'après le rapport de recherche de Nvidia, un seul transformeur de diffusion traite ensemble la vidéo future et le segment d'actions, et de petits modules propres à chaque robot traduisent le plan en commandes moteurs.
Grâce à cette prédiction vidéo, le modèle est censé transférer des enchaînements de mouvements entre des morphologies différentes. Nvidia indique qu'il fonctionne sur des pinces parallèles, des mains à cinq doigts et des humanoïdes. Selon The Decoder, l'entraînement s'est déroulé sur un cluster de plus de mille puces GB300. D'après Nvidia, le mélange d'entraînement comprend trois types de données :
- 402 730 heures de vidéos égocentriques de personnes au travail, filmées avec des caméras sur la tête
- 10 184 heures de démonstrations avec une pince UMI tenue à la main, sur 2 897 tâches
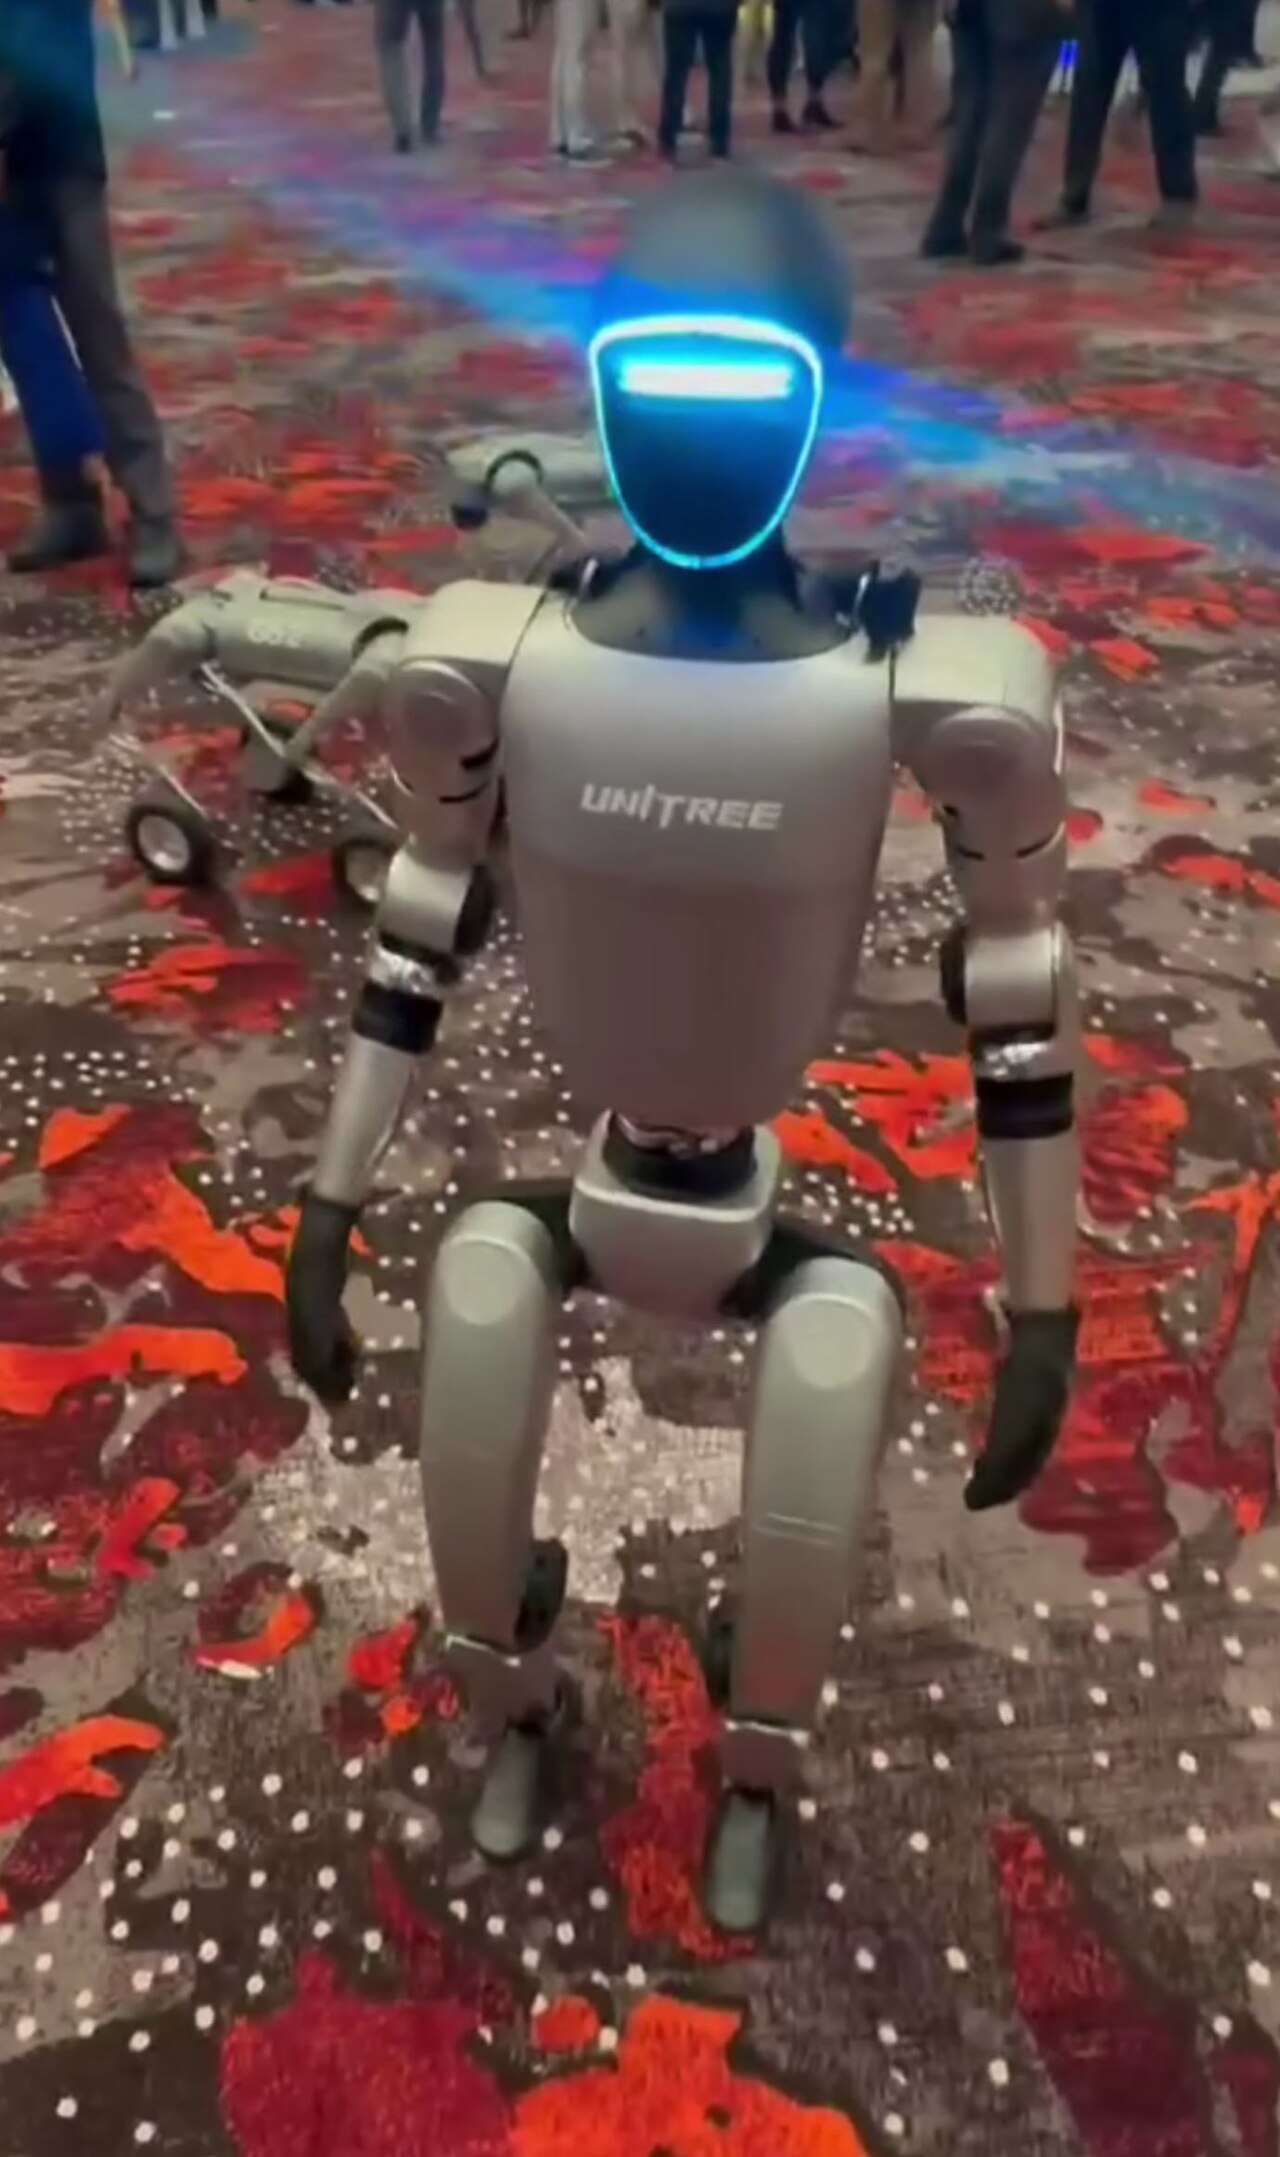
- 23 500 heures de données de téléopération de robots, dont des bras à pinces parallèles, des mains Sharpa et Wuji ainsi que l'humanoïde Unitree G1
Selon Nvidia, 100 000 heures de ces vidéos humaines sont accessibles librement sur Hugging Face sous le nom Human-1M-100K. The Robot Report décrit GR00T 2 comme un modèle monde-action ouvert de pointe. Nous n'avons pas vérifié les conditions de licence exactes des poids du modèle dans les sources lues.
Ce que montrent les chiffres, et ce qu'ils ne montrent pas
Tous les résultats viennent d'expériences en laboratoire et de Nvidia elle-même ; aucun n'a été vérifié de manière indépendante à ce stade. Sur 50 tâches que le robot cible n'avait jamais pratiquées, 40 % ont réussi sans aucune démonstration sur le robot, selon Nvidia. Avec une démonstration par tâche, le taux monte à 71 % ; avec cinq démonstrations, soit moins de trois minutes de données robot au total, il atteint 95 %. Selon Nvidia, un réglage fin de 30 minutes sur une seule carte graphique RTX 5090 suffit.
L'apprentissage à partir de vidéos humaines seules est particulièrement notable. Selon The Decoder, un robot à deux mains à cinq doigts a pu allumer une allumette, couper une banane ou lancer des colis sur un tapis roulant sans avoir été téléopéré pour ces tâches. Les taux de réussite variaient de 10 à 80 % selon la tâche. D'après Nvidia, il suffit qu'une personne montre les gestes avec des gants de données, des pinces manuelles spéciales ou un exosquelette de doigts. À partir d'une seule vidéo d'un coup de marteau, le système a aussi appris à enfoncer des clous, en passant par une simulation.
Pour les tâches de précision avec deux mains Sharpa, Nvidia indique 85 % de réussite pour l'insertion de modules mémoire GB300 et 65 % pour l'assemblage d'un camion jouet. L'apprentissage par renforcement sur le robot réel a porté trois tâches d'insertion à fort contact entre 88 et 96 %.
Un modèle de langage comme chef d'orchestre, et comme frein
Pour les montages plus longs, Nvidia associe GR00T 2 à un modèle de langage de niveau supérieur qui appelle le logiciel via une interface. Selon The Decoder, il peut s'agir par exemple de GPT-6 Astra d'OpenAI. Le modèle de langage découpe la tâche en étapes, marque les points de saisie dans l'image de la caméra et lance des routines d'aide quand une pièce tombe. D'après Nvidia, le robot a ainsi terminé chacun de trois jouets lors d'au moins 97 essais consécutifs sur 100. Sans le modèle de langage correcteur et sans entraînement complémentaire, l'assemblage de la voiture jouet n'a réussi que 23 fois sur 100, selon The Decoder. Avec des marqueurs de saisie colorés, le robot a suivi les instructions dans 92 % des cas, contre 40 % avec la seule consigne de tâche.
Le prix à payer est la vitesse : lors du tri de déchets, le robot est resté immobile environ un tiers du temps, selon The Decoder, car il devait attendre en moyenne plus de sept secondes le modèle de planification. Pour les robots bipèdes, Nvidia a donc conçu la variante allégée GR00T 2 Turbo. Selon Nvidia, elle demande 124 millisecondes par prédiction et tourne directement sur l'ordinateur embarqué Jetson Thor de l'Unitree G1. Le robot a servi du pop-corn lors des 48 essais et débarrassé une table dans 93 % des essais. Essuyer un liquide avec une serviette sous le pied n'a fonctionné que dans environ la moitié des tentatives, selon The Decoder.
Des obstacles encore ouverts pour l'usage réel
- Le modèle ne traite pas encore de données directes de capteurs pour le toucher.
- Il passe parfois à côté d'erreurs fines, comme des vis à moitié vissées.
- Les taux de réussite fluctuent beaucoup et restent très loin de 95 % pour de nombreuses tâches.
- Les places parmi les trois meilleurs modèles sur des benchmarks comme RoboCasa365, RoboLab, RoboDojo et MolmoSpaces sont une affirmation de Nvidia.
Au lancement, Nvidia cite des partenaires qui testent le modèle : selon The Robot Report, Foxconn l'applique à l'automatisation d'usine pour la fabrication de serveurs, Siemens l'évalue pour des cas d'usage industriels et Nexuni le teste pour la blanchisserie. Avec Isaac Lab 3.0, Nvidia a aussi présenté une nouvelle version de son framework open source d'entraînement de robots en simulation.
Ce que ça change pour les entreprises en France
Pour les industriels et logisticiens français, GR00T 2 n'est pas encore un produit à brancher, mais c'est un signal : l'apprentissage des robots pourrait passer de la téléopération coûteuse aux vidéos et à quelques démonstrations. C'est notre analyse, pas une déclaration de Nvidia. Un petit pilote sur une tâche à fortes variantes est raisonnable, là où une saisie ratée coûte peu et où un taux inférieur à 95 % reste acceptable. Les entreprises qui veulent utiliser des vidéos de salariés comme matière d'entraînement devraient associer tôt le délégué à la protection des données et les représentants du personnel. Les chiffres de laboratoire ne deviennent fiables qu'une fois confirmés sur vos propres pièces et dans votre propre atelier.
Sources
- GR00T 2 zeigt Nvidias neuen Kurs bei KI-Modellen für RoboterThe Decoder · 10 novembre 2026
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and AdaptationNVIDIA Research (GEAR) · 10 novembre 2026
- NVIDIA launches GR00T 2 and Isaac Lab 3.0 at CoRLThe Robot Report · 10 novembre 2026