إنفيديا GR00T 2: الروبوتات تتعلم المهارات اليدوية من فيديو البشر
نموذج GR00T 2 من إنفيديا ينقل مهارات اليد من فيديوهات البشر إلى الروبوتات: نجاح 40% دون تدريب و95% بعد خمس تجارب. والقيود ما زالت كبيرة.
كشفت إنفيديا في مؤتمر الروبوتات CoRL في أوستن بولاية تكساس عن GR00T 2، الجيل الثاني من نموذجها الأساسي للروبوتات. يهدف النموذج إلى تخفيف مشكلة محورية في القطاع: فالروبوتات تتعلم المهارات اليدوية الجديدة غالبًا لأن أشخاصًا يتحكمون بها عن بُعد لساعات طويلة. وبحسب موقع The Decoder، فإن هذا ما يُعرف بالتشغيل عن بُعد مكلف وبطيء وينتج بيانات لا تصلح إلا لطراز روبوت بعينه. أما GR00T 2 فيعتمد بدلًا من ذلك على فيديوهات للبشر.
نموذج يتنبأ بالمستقبل على شكل فيديو
بحسب إنفيديا، GR00T 2 هو ما يسمى نموذج العالم والفعل. وخلافًا للجيل السابق GR00T 1، لا يترجم صور الكاميرا والأوامر اللغوية مباشرة إلى حركات محركات. بل يحسب في الوقت نفسه الحركة التالية ومقطع فيديو قصيرًا للمستقبل القريب. أي أنه يتنبأ بكيف ينبغي أن تتغير صورة الكاميرا حين تلتقط ذراع قابضة جسمًا مثلًا. وبحسب تقرير إنفيديا البحثي، يعالج محوّل انتشار واحد الفيديو المستقبلي وكتلة الأفعال معًا، وتترجم وحدات صغيرة خاصة بكل روبوت الخطة إلى أوامر للمحركات.
من خلال هذا التنبؤ بالفيديو، يُفترض أن ينقل النموذج تسلسلات الحركة بين أجسام روبوتية مختلفة. وتقول إنفيديا إنه يعمل على قابضات متوازية وأيدٍ بخمسة أصابع وروبوتات شبيهة بالبشر. وبحسب The Decoder، جرى التدريب على عنقود يضم أكثر من ألف شريحة GB300. ووفق إنفيديا، يتكون خليط التدريب من ثلاثة أنواع من البيانات:
- 402,730 ساعة من الفيديو من منظور الشخص الأول لأشخاص أثناء العمل، مسجلة بكاميرات مثبتة على الرأس
- 10,184 ساعة من العروض التوضيحية بقابض UMI محمول باليد عبر 2,897 مهمة
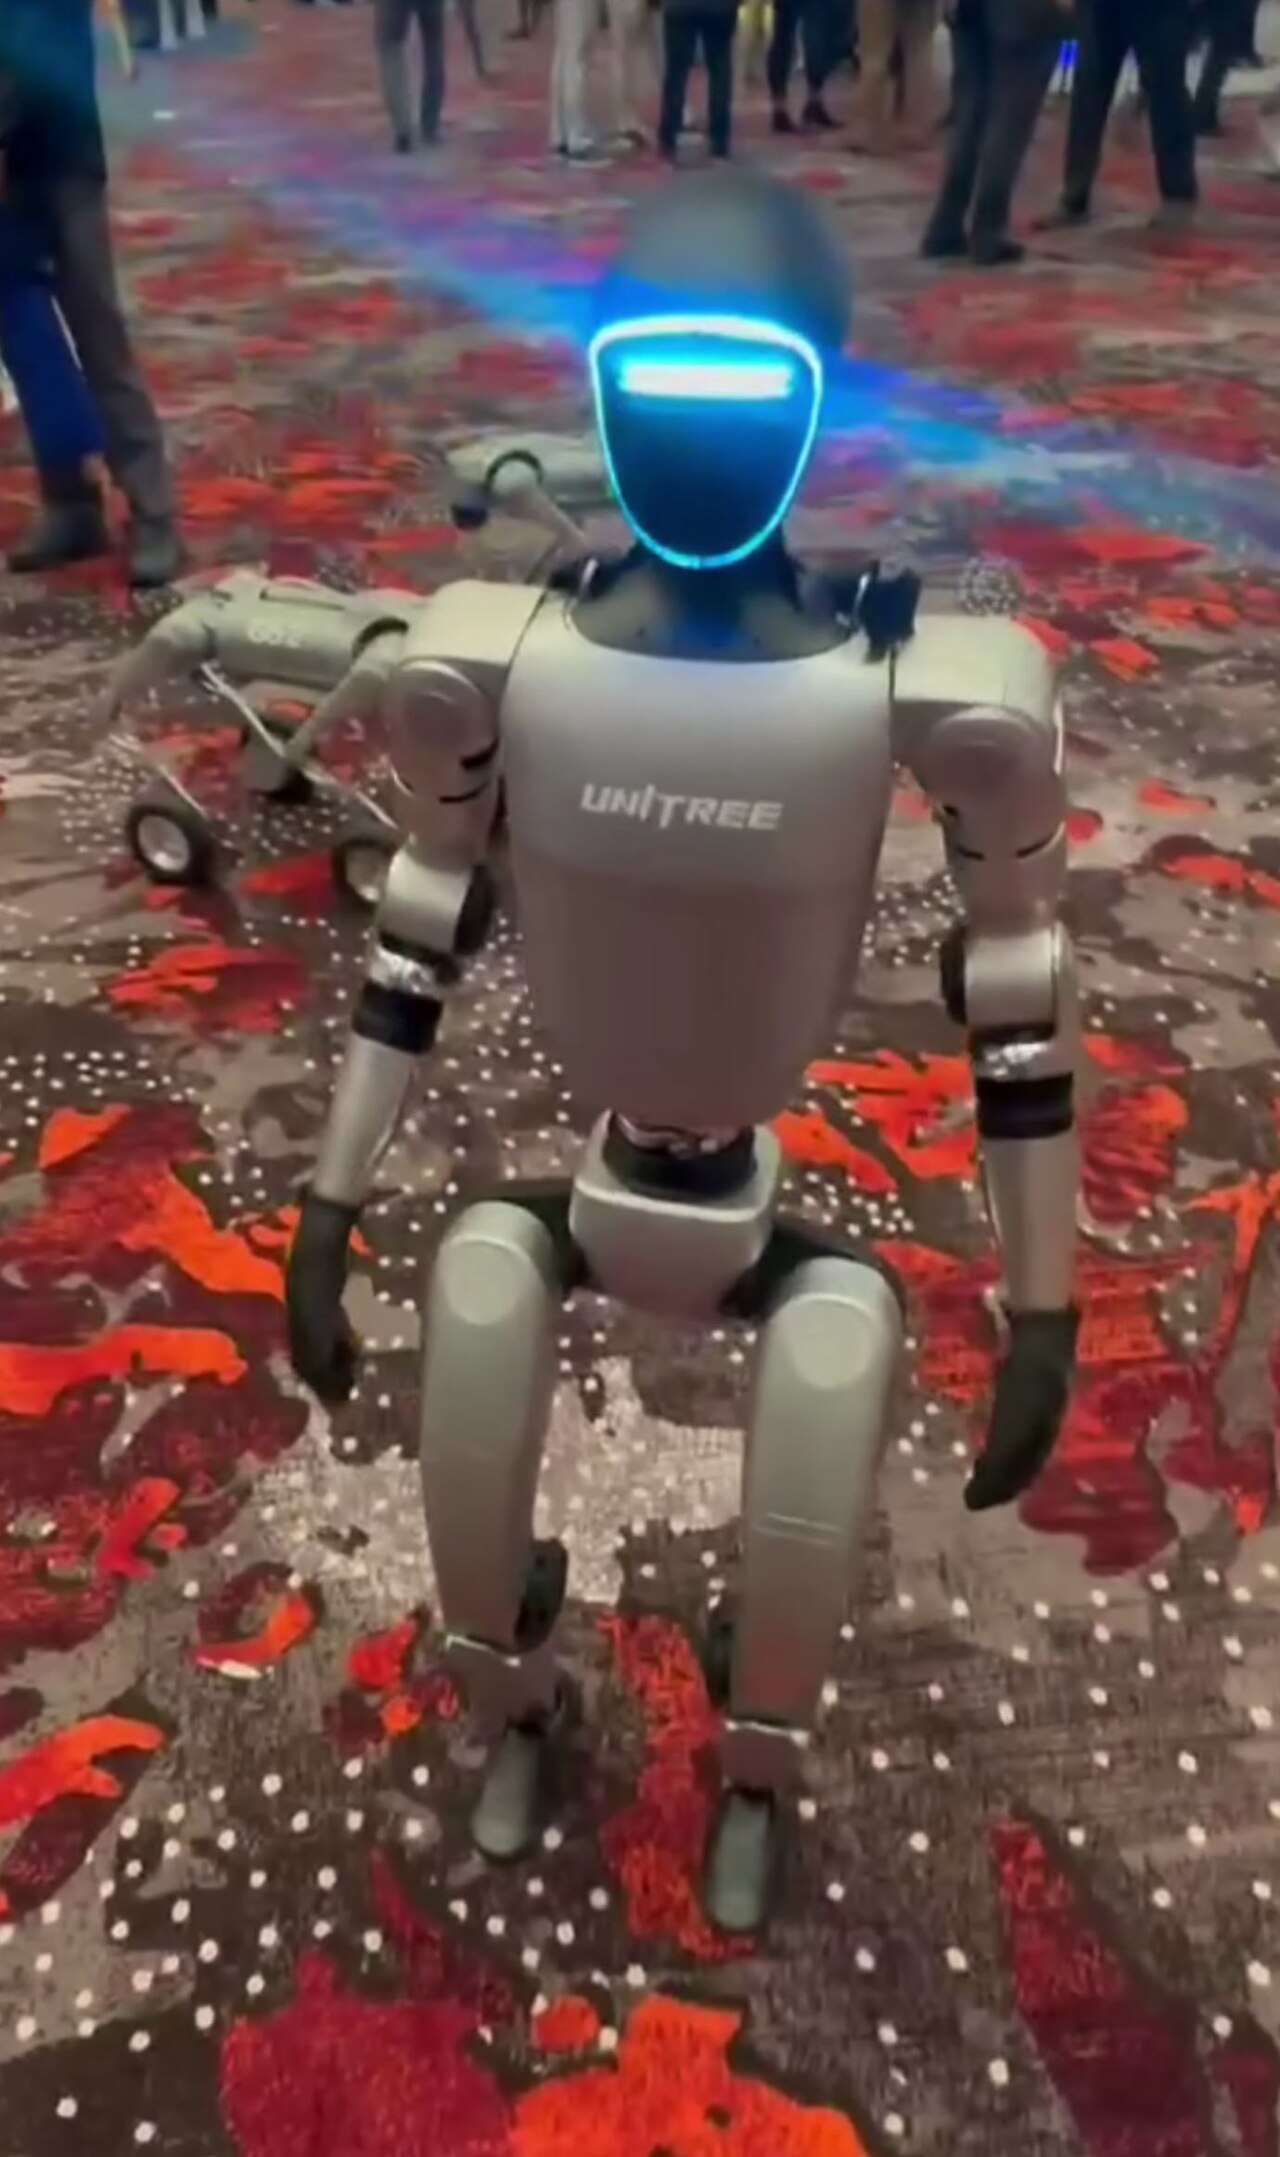
- 23,500 ساعة من بيانات التشغيل عن بُعد للروبوتات، بينها أذرع بقابضات متوازية وأيدي من Sharpa وWuji والروبوت الشبيه بالبشر Unitree G1
وبحسب إنفيديا، تتوفر 100 ألف ساعة من الفيديو البشري بشكل مفتوح على Hugging Face باسم Human-1M-100K. ويصف موقع The Robot Report نموذج GR00T 2 بأنه نموذج عالم وفعل مفتوح من الطراز الأول. ولم نتحقق في المصادر التي قرأناها من شروط الترخيص الدقيقة لأوزان النموذج.
ما الذي تُظهره الأرقام وما الذي لا تُظهره
جميع النتائج مصدرها تجارب مخبرية وإنفيديا نفسها، ولم يتم التحقق من أي منها بشكل مستقل حتى الآن. في 50 مهمة لم يمارسها الروبوت المستهدف من قبل، نجح 40% منها دون أي عرض توضيحي على الروبوت، بحسب إنفيديا. ومع عرض واحد لكل مهمة ارتفعت النسبة إلى 71%، ومع خمسة عروض، أي أقل من ثلاث دقائق من بيانات الروبوت إجمالًا، إلى 95%. وبحسب إنفيديا يكفي لذلك ضبط دقيق مدته 30 دقيقة على بطاقة رسومات واحدة من طراز RTX 5090.
والتعلم من فيديو البشر وحده لافت بصفة خاصة. فبحسب The Decoder، تمكن روبوت بيدين بخمسة أصابع من إشعال عود ثقاب وتقطيع موزة ورمي طرود على سير ناقل دون أن يُتحكم به عن بُعد لهذه المهام. وتراوحت نسب النجاح بين 10% و80% حسب المهمة. وبحسب إنفيديا، يكفي أن يؤدي شخص الحركات بقفازات بيانات أو قابضات يدوية خاصة أو هيكل خارجي للأصابع. ومن فيديو واحد لضربة مطرقة تعلم النظام أيضًا دق المسامير عبر محاكاة حاسوبية.
وفي المهام الدقيقة بيدين من Sharpa، تذكر إنفيديا نسبة نجاح 85% في تركيب وحدات ذاكرة GB300 و65% في تجميع شاحنة لعبة. ورفع التعلم المعزز على الروبوت الحقيقي ثلاث مهام إدخال شديدة التلامس إلى ما بين 88% و96%.
نموذج لغوي كقائد أوركسترا وكمكابح
للمهام التجميعية الأطول، تجمع إنفيديا GR00T 2 مع نموذج لغوي أعلى مستوى يستدعي البرنامج عبر واجهة. وبحسب The Decoder، قد يكون ذلك مثلًا GPT-6 Astra من OpenAI. يقسّم النموذج اللغوي المهمة إلى خطوات ويحدد نقاط الإمساك على صورة الكاميرا ويشغّل إجراءات مساعدة عند سقوط قطعة. ووفق إنفيديا أنجز الروبوت بهذه الطريقة كل واحد من ثلاثة نماذج لعب في 97 محاولة على الأقل من أصل 100 متتالية. وبدون النموذج اللغوي المصحح ومن دون تدريب إضافي، نجح تجميع سيارة اللعبة في 23 حالة فقط من 100، بحسب The Decoder. ومع علامات إمساك ملونة، اتبع الروبوت التعليمات في 92% من الحالات مقابل 40% مع تعليمة المهمة وحدها.
الثمن هو السرعة: فعند فرز النفايات بقي الروبوت متوقفًا نحو ثلث الوقت، بحسب The Decoder، لأنه كان ينتظر في المتوسط أكثر من سبع ثوانٍ لنموذج التخطيط. وللروبوتات ذات الساقين طورت إنفيديا لذلك النسخة المخففة GR00T 2 Turbo. وبحسب إنفيديا تحتاج 124 ميلي ثانية لكل تنبؤ وتعمل مباشرة على الحاسوب المدمج Jetson Thor في Unitree G1. وقد غرف الروبوت الفشار في جميع المحاولات الـ48 ورفع الأشياء عن طاولة في 93% من المحاولات. أما مسح سائل بمنشفة تحت القدم فنجح في نحو نصف المحاولات فقط، بحسب The Decoder.
عقبات ما زالت مفتوحة أمام الاستخدام العملي
- لا يعالج النموذج حتى الآن بيانات مستشعرات مباشرة لحاسة اللمس.
- يغفل أحيانًا أخطاء دقيقة مثل براغٍ مشدودة جزئيًا.
- تتذبذب نسب النجاح بشدة، وهي في كثير من المهام أقل بكثير من 95%.
- احتلال المراتب الثلاث الأولى في معايير مثل RoboCasa365 وRoboLab وRoboDojo وMolmoSpaces هو ادعاء من إنفيديا.
عند الإطلاق، تذكر إنفيديا شركاء يختبرون النموذج: فبحسب The Robot Report تطبقه فوكسكون في أتمتة المصانع لتصنيع الخوادم، وتقيّمه سيمنس لحالات استخدام صناعية، وتختبره Nexuni في المغاسل. وبالتزامن مع ذلك قدمت إنفيديا مع Isaac Lab 3.0 إصدارًا جديدًا من إطارها المفتوح المصدر لتدريب الروبوتات في المحاكاة.
ما الذي يغيّره ذلك للشركات في المنطقة العربية
بالنسبة إلى المصنّعين وشركات اللوجستيات في المنطقة العربية، لا يزال GR00T 2 منتجًا غير جاهز للتشغيل الفوري، لكنه إشارة: فقد يتحول تعليم الروبوتات من التحكم عن بُعد المكلف إلى الفيديوهات وعدد قليل من العروض التوضيحية. هذا تقديرنا نحن وليس تصريحًا من إنفيديا. والخطوة المعقولة تجربة صغيرة على مهمة متعددة الأشكال، حيث يكلف الإمساك الخاطئ القليل وتكون نسبة نجاح أقل من 95% مقبولة. وعلى الشركات التي تريد استخدام فيديوهات موظفيها مادة تدريب أن تشرك مبكرًا مسؤول حماية البيانات وممثلي العاملين. ولا تصبح أرقام المختبر موثوقة إلا بعد تأكيدها على قطعكم أنتم وفي مصنعكم أنتم.
المصادر
- GR00T 2 zeigt Nvidias neuen Kurs bei KI-Modellen für RoboterThe Decoder · ١٠ نوفمبر ٢٠٢٦
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and AdaptationNVIDIA Research (GEAR) · ١٠ نوفمبر ٢٠٢٦
- NVIDIA launches GR00T 2 and Isaac Lab 3.0 at CoRLThe Robot Report · ١٠ نوفمبر ٢٠٢٦