Nvidia GR00T 2: robôs aprendem movimentos com vídeo humano
O GR00T 2 da Nvidia leva gestos de vídeos humanos a robôs: 40% de acerto sem treino, 95% após cinco demos. Os limites continuam grandes.
Na conferência de robótica CoRL, em Austin (Texas), a Nvidia apresentou o GR00T 2, a segunda geração de seu modelo de fundação para robôs. O modelo busca aliviar um problema central do setor: até agora, os robôs aprendem novos movimentos principalmente porque pessoas os controlam à distância por horas. Segundo o The Decoder, essa teleoperação é cara, lenta e gera dados que só servem para um modelo de robô específico. O GR00T 2 aposta, em vez disso, em vídeos de pessoas.
Um modelo que prevê o futuro em vídeo
Segundo a Nvidia, o GR00T 2 é um chamado modelo mundo-ação. Diferentemente da geração anterior, o GR00T 1, ele não traduz diretamente imagens de câmera e comandos de linguagem em movimentos de motor. Ele calcula ao mesmo tempo o próximo movimento e um vídeo curto do futuro imediato. Ou seja, prevê como a imagem da câmera deveria mudar quando uma garra pega um objeto, por exemplo. De acordo com o relatório de pesquisa da Nvidia, um único transformador de difusão processa em conjunto o vídeo futuro e o bloco de ações, e pequenos módulos específicos de cada robô traduzem o plano em comandos de motor.
Por meio dessa previsão de vídeo, o modelo deve conseguir transferir sequências de movimento entre corpos de robô diferentes. A Nvidia afirma que ele roda em garras paralelas, mãos de cinco dedos e humanoides. Segundo o The Decoder, o treinamento ocorreu em um cluster com mais de mil chips GB300. De acordo com a Nvidia, a mistura de treinamento tem três tipos de dados:
- 402.730 horas de vídeo egocêntrico de pessoas trabalhando, gravado com câmeras na cabeça
- 10.184 horas de demonstrações com uma garra UMI de mão em 2.897 tarefas
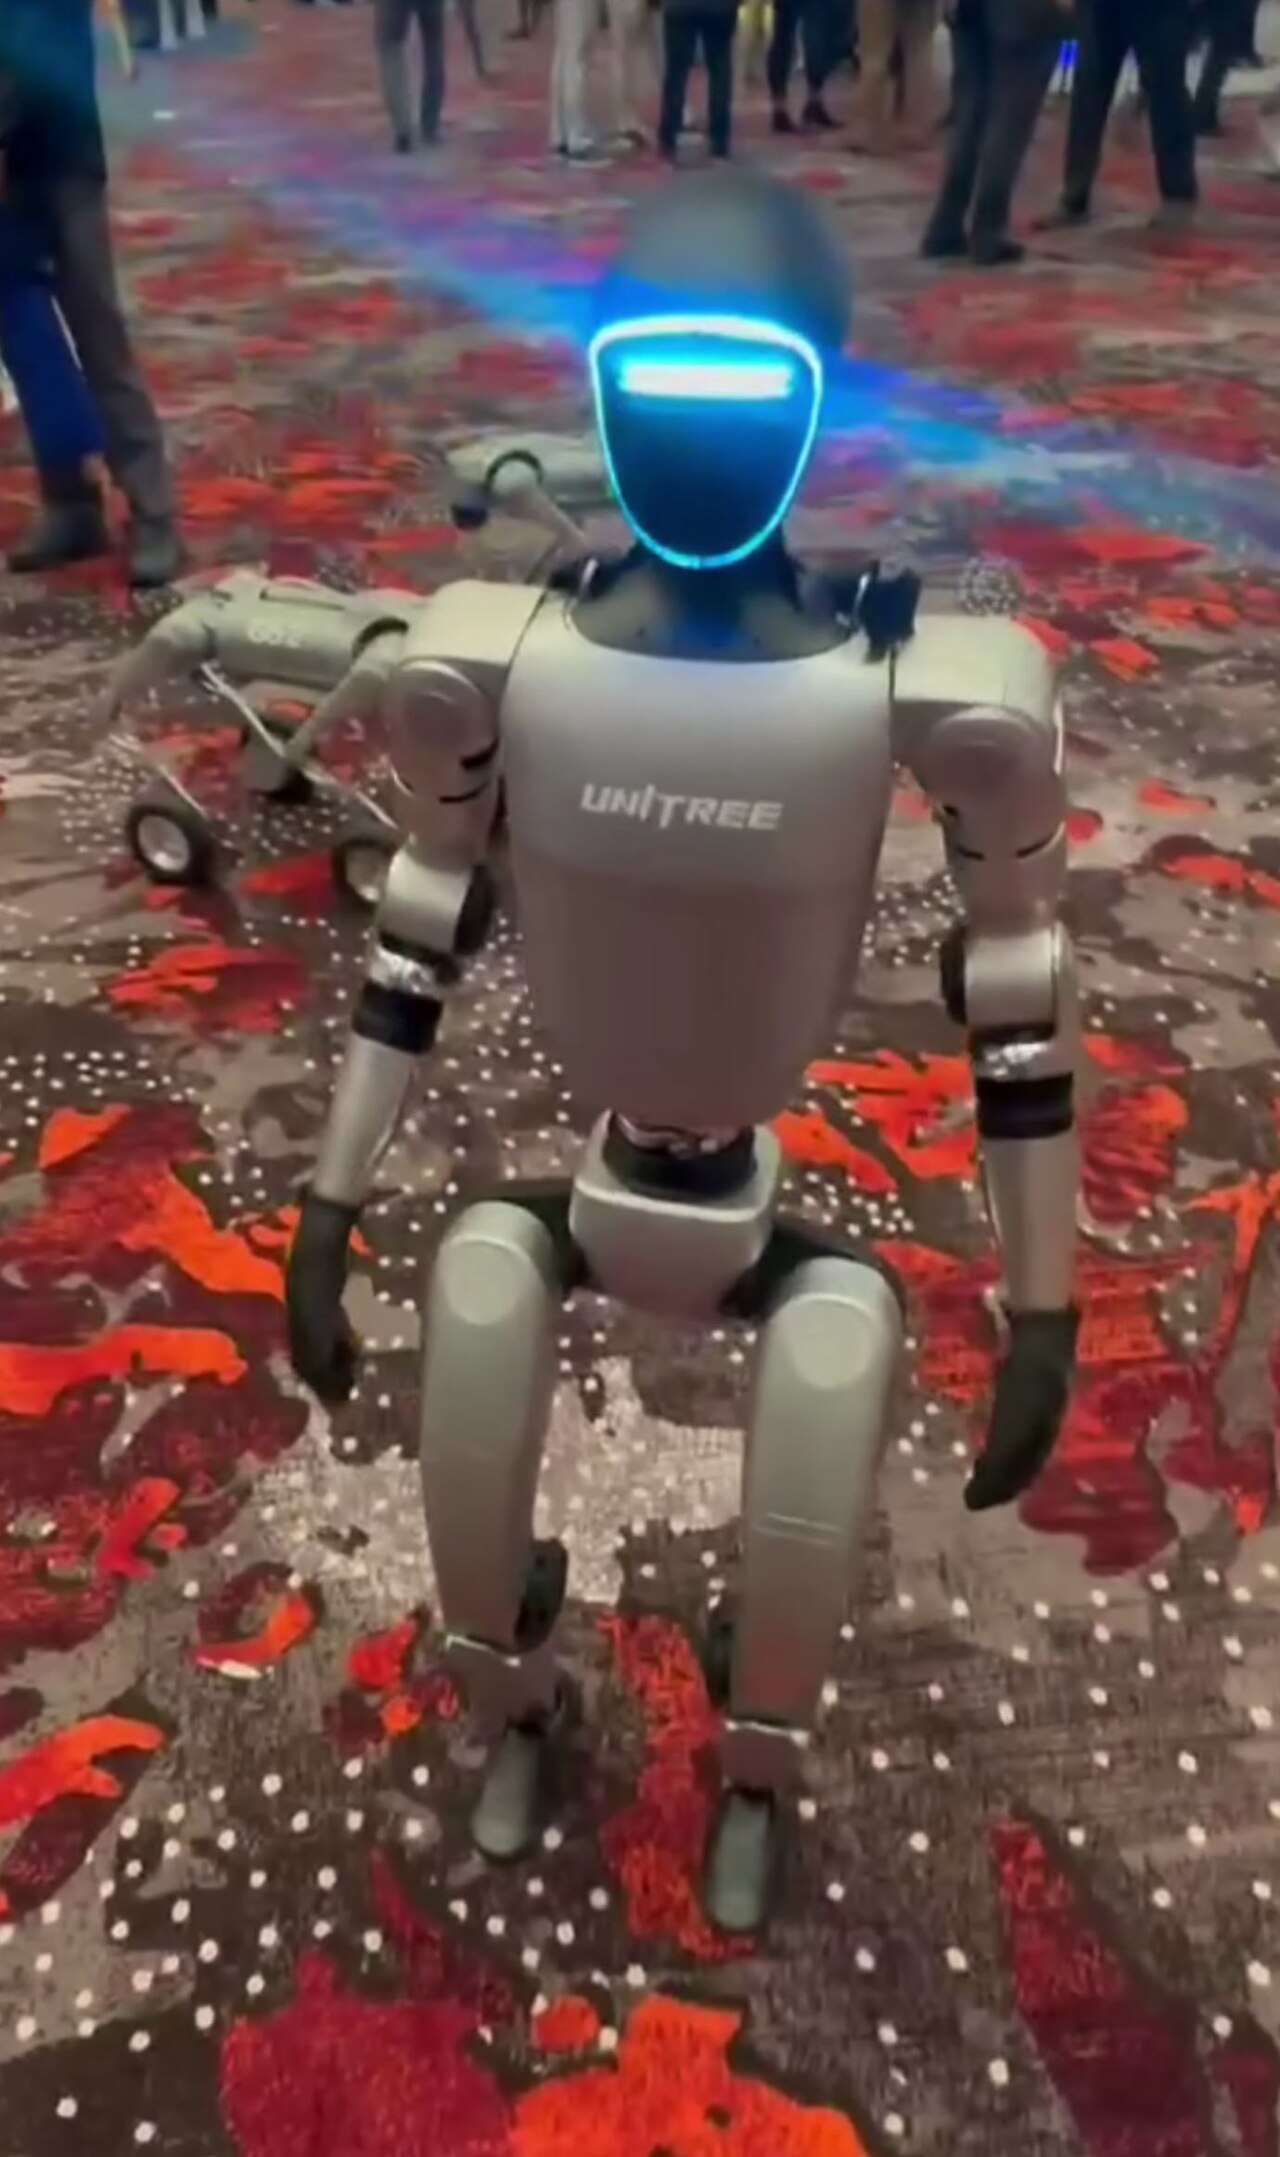
- 23.500 horas de dados de teleoperação de robôs, incluindo braços com garras paralelas, mãos da Sharpa e da Wuji e o humanoide Unitree G1
Segundo a Nvidia, 100.000 horas do vídeo humano estão disponíveis abertamente no Hugging Face com o nome Human-1M-100K. O The Robot Report descreve o GR00T 2 como um modelo mundo-ação aberto de ponta. Nas fontes lidas, não verificamos as condições exatas de licença dos pesos do modelo.
O que os números mostram e o que não mostram
Todos os resultados vêm de experimentos de laboratório e da própria Nvidia; nenhum foi verificado de forma independente até agora. Em 50 tarefas que o robô de destino nunca havia praticado, 40% deram certo sem nenhuma demonstração no robô, segundo a Nvidia. Com uma demonstração por tarefa, a taxa subiu para 71%, e com cinco demonstrações, menos de três minutos de dados de robô no total, para 95%. Segundo a Nvidia, basta um ajuste fino de 30 minutos em uma única placa de vídeo RTX 5090.
Aprender apenas com vídeo humano é especialmente notável. Segundo o The Decoder, um robô com duas mãos de cinco dedos conseguiu acender um fósforo, cortar uma banana ou jogar pacotes numa esteira sem ter sido teleoperado para essas tarefas. As taxas de sucesso variaram de 10% a 80% conforme a tarefa. De acordo com a Nvidia, basta que uma pessoa demonstre os movimentos com luvas de dados, garras manuais especiais ou um exoesqueleto de dedos. A partir de um único vídeo de uma martelada, o sistema também aprendeu a cravar pregos, passando por uma simulação.
Em tarefas de motricidade fina com duas mãos Sharpa, a Nvidia informa 85% de sucesso ao encaixar módulos de memória GB300 e 65% na montagem de um caminhão de brinquedo. O aprendizado por reforço no robô real elevou três tarefas de inserção com muito contato para entre 88% e 96%.
Um modelo de linguagem como maestro e como freio
Para montagens mais longas, a Nvidia combina o GR00T 2 com um modelo de linguagem de nível superior que chama o software por uma interface. Segundo o The Decoder, pode ser, por exemplo, o GPT-6 Astra da OpenAI. O modelo de linguagem divide a tarefa em etapas, marca pontos de pega na imagem da câmera e inicia rotinas de ajuda quando uma peça cai. Segundo a Nvidia, o robô concluiu assim cada um de três brinquedos em pelo menos 97 de 100 execuções seguidas. Sem o modelo de linguagem corretor e sem treinamento adicional, a montagem do carrinho de brinquedo deu certo em apenas 23 de 100 casos, segundo o The Decoder. Com marcações coloridas de pega, o robô seguiu as instruções em 92% dos casos, contra 40% com a instrução da tarefa sozinha.
O preço é a velocidade: ao separar lixo, o robô ficou parado cerca de um terço do tempo, segundo o The Decoder, porque precisava esperar em média mais de sete segundos pelo modelo de planejamento. Para robôs bípedes, a Nvidia desenvolveu por isso a variante reduzida GR00T 2 Turbo. Segundo a Nvidia, ela leva 124 milissegundos por previsão e roda diretamente no computador de bordo Jetson Thor do Unitree G1. O robô serviu pipoca em todas as 48 tentativas e limpou uma mesa em 93% delas. Enxugar um líquido com uma toalha sob o pé só funcionou em cerca de metade das tentativas, segundo o The Decoder.
Obstáculos em aberto para o uso real
- O modelo ainda não processa dados diretos de sensores para o tato.
- Às vezes deixa passar erros sutis, como parafusos meio rosqueados.
- As taxas de sucesso oscilam muito e ficam bem abaixo de 95% em várias tarefas.
- As colocações entre os três melhores em benchmarks como RoboCasa365, RoboLab, RoboDojo e MolmoSpaces são uma afirmação da Nvidia.
No lançamento, a Nvidia cita parceiros que testam o modelo: segundo o The Robot Report, a Foxconn o aplica na automação de fábrica para a produção de servidores, a Siemens o avalia para casos de uso industriais e a Nexuni o testa em lavanderia. Com o Isaac Lab 3.0, a Nvidia também apresentou uma nova versão de seu framework de código aberto para treinar robôs em simulação.
O que muda para as empresas no Brasil
Para indústrias e operadores logísticos brasileiros, o GR00T 2 ainda não é um produto para ligar e usar, mas é um sinal: o ensino de robôs pode migrar da cara teleoperação para vídeos e poucas demonstrações. Essa é nossa avaliação, não uma declaração da Nvidia. Um piloto pequeno em uma tarefa com muitas variantes é razoável, onde uma pega errada custa pouco e uma taxa abaixo de 95% é tolerável. Empresas que queiram usar vídeos de funcionários como material de treinamento devem envolver cedo o encarregado de dados (LGPD) e os representantes dos trabalhadores. Os números de laboratório só são confiáveis depois de confirmados com as suas próprias peças e no seu próprio chão de fábrica.
Fontes
- GR00T 2 zeigt Nvidias neuen Kurs bei KI-Modellen für RoboterThe Decoder · 10 de novembro de 2026
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and AdaptationNVIDIA Research (GEAR) · 10 de novembro de 2026
- NVIDIA launches GR00T 2 and Isaac Lab 3.0 at CoRLThe Robot Report · 10 de novembro de 2026