Nvidia GR00T 2: robots leren handelingen van mensenvideo's
Nvidia's GR00T 2 zet handelingen uit mensenvideo's over op robots: 40% succes zonder training, 95% na vijf demo's. De grenzen blijven groot.
Op de robotica-conferentie CoRL in Austin (Texas) heeft Nvidia GR00T 2 gepresenteerd, de tweede generatie van zijn basismodel voor robots. Het model moet een kernprobleem van de sector verzachten: robots leren nieuwe handelingen tot nu toe meestal doordat mensen ze urenlang op afstand besturen. Volgens The Decoder is deze zogeheten teleoperatie duur, traag en levert ze data op die alleen bruikbaar is voor één specifiek robotmodel. GR00T 2 zet in plaats daarvan in op video's van mensen.
Een model dat de toekomst in video voorspelt
Volgens Nvidia is GR00T 2 een zogeheten wereld-actiemodel. Anders dan de vorige generatie, GR00T 1, vertaalt het camerabeelden en taalopdrachten niet rechtstreeks naar motorbewegingen. Het berekent tegelijk de volgende beweging en een korte video van de directe toekomst. Het voorspelt dus hoe het camerabeeld zou moeten veranderen wanneer een grijper bijvoorbeeld een voorwerp oppakt. Volgens het onderzoeksrapport van Nvidia verwerkt één enkele diffusietransformer de toekomstvideo en het actieblok samen, en kleine modules per robot vertalen het plan naar motorcommando's.
Via deze videovoorspelling moet het model bewegingen kunnen overdragen tussen verschillende robotlichamen. Nvidia zegt dat het draait op parallelle grijpers, handen met vijf vingers en humanoïden. Volgens The Decoder vond de training plaats op een cluster van meer dan duizend GB300-chips. Volgens Nvidia bestaat de trainingsmix uit drie soorten data:
- 402.730 uur egocentrische video van mensen aan het werk, opgenomen met hoofdcamera's
- 10.184 uur demonstraties met een handgehouden UMI-grijper over 2.897 taken
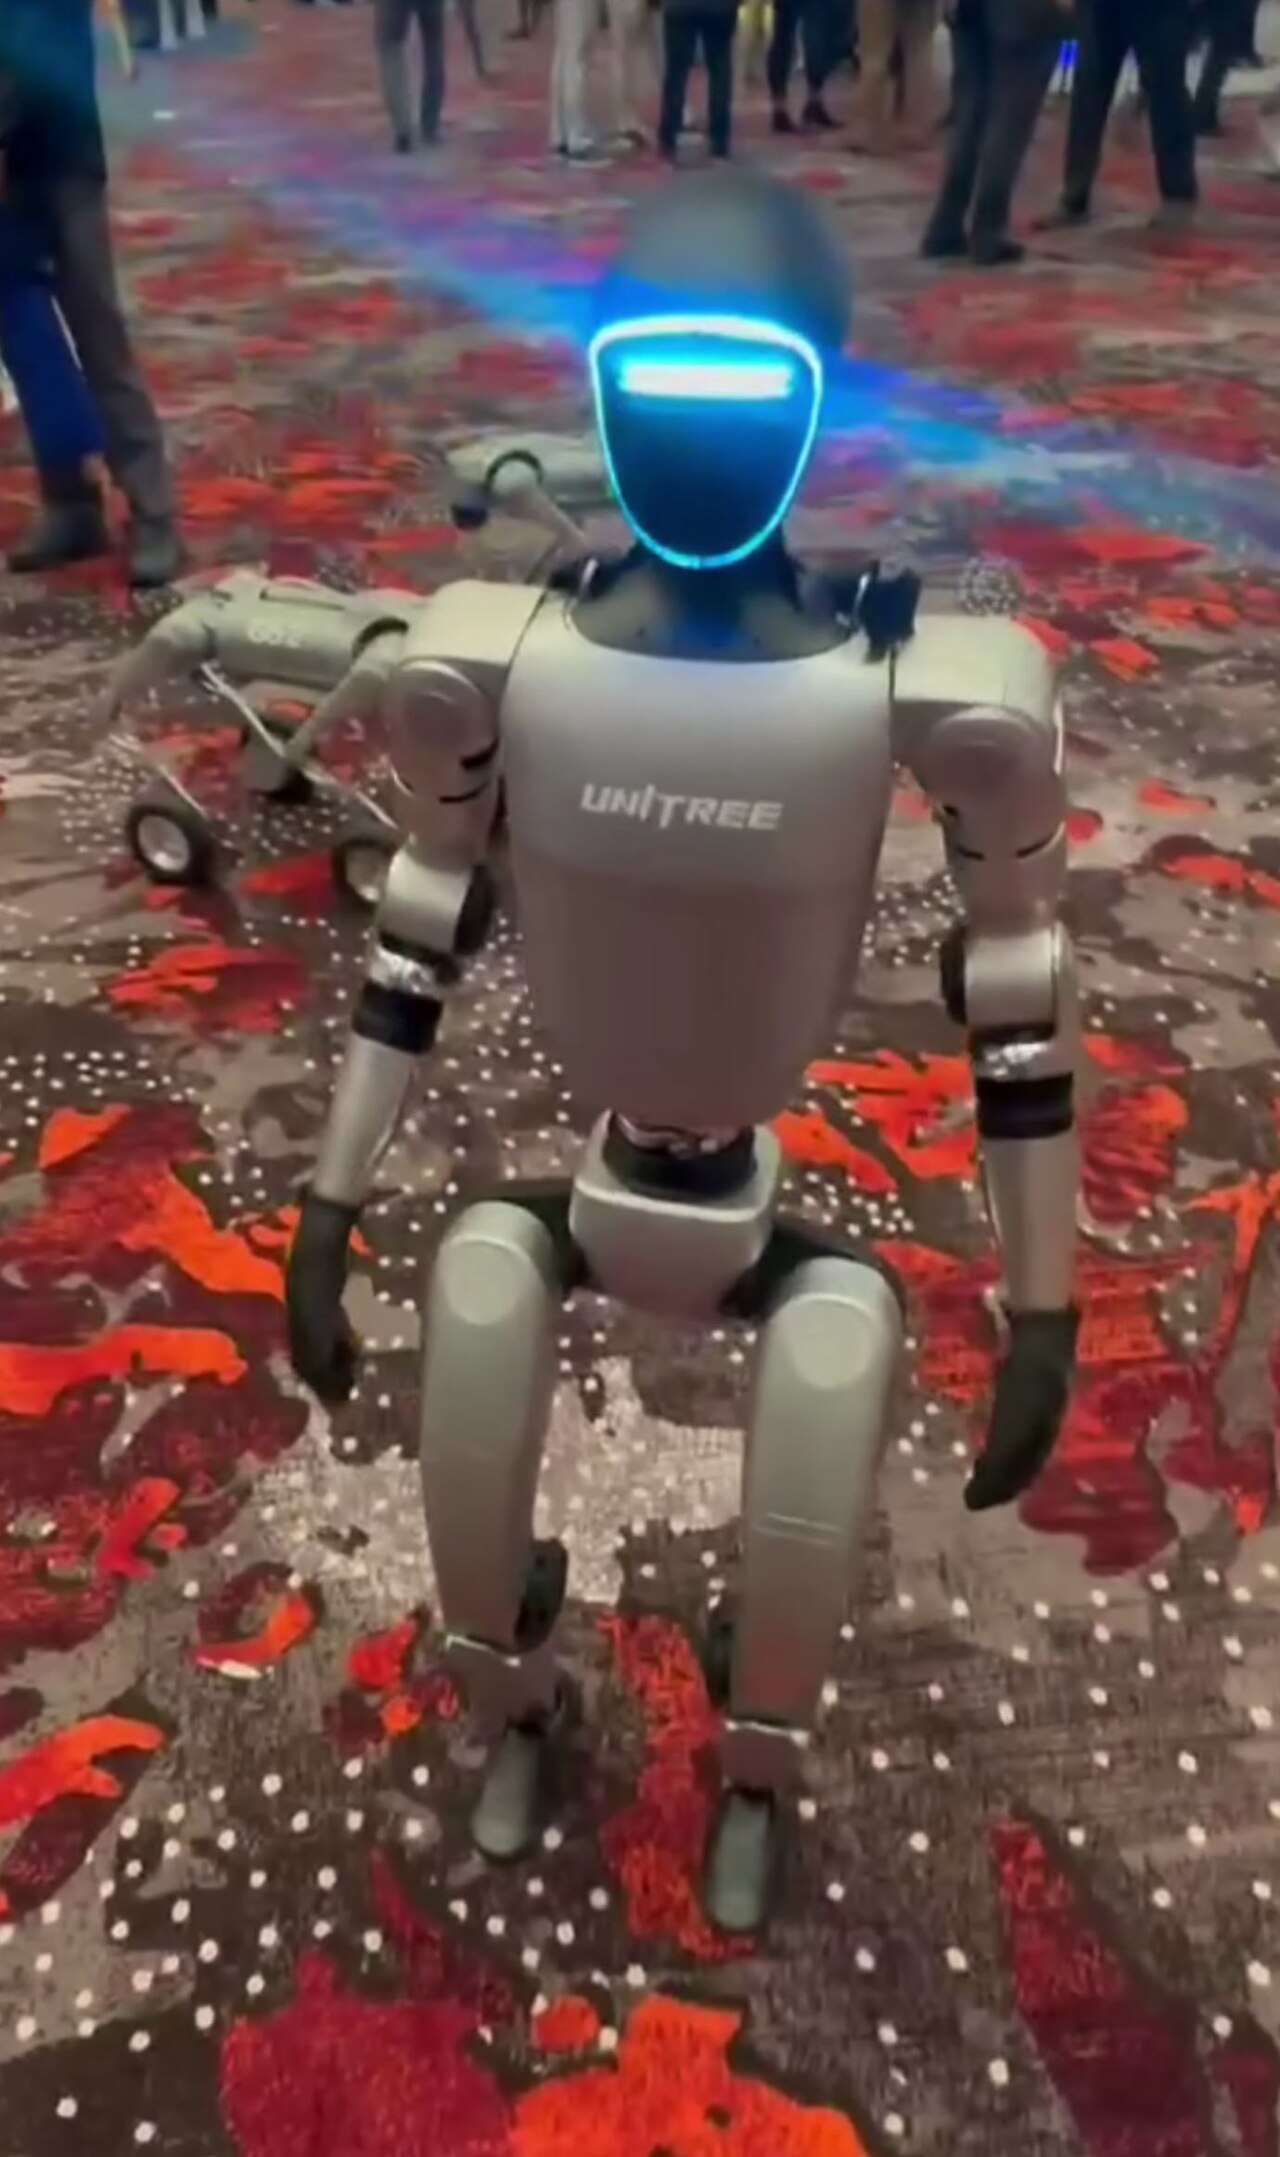
- 23.500 uur teleoperatiedata van robots, waaronder armen met parallelle grijpers, handen van Sharpa en Wuji en de humanoïde Unitree G1
Volgens Nvidia is 100.000 uur van de mensenvideo's openlijk beschikbaar op Hugging Face onder de naam Human-1M-100K. The Robot Report beschrijft GR00T 2 als een open wereld-actiemodel van het hoogste niveau. De exacte licentievoorwaarden voor de modelgewichten hebben we in de gelezen bronnen niet gecontroleerd.
Wat de cijfers laten zien, en wat niet
Alle resultaten komen uit laboratoriumproeven en van Nvidia zelf; geen enkel is tot nu toe onafhankelijk gecontroleerd. Bij 50 taken die de doelrobot nooit had geoefend, lukte volgens Nvidia 40% zonder enige demonstratie op de robot. Met één demonstratie per taak steeg het percentage naar 71%, en met vijf demonstraties, samen minder dan drie minuten robotdata, naar 95%. Volgens Nvidia volstaat daarvoor een fijnafstemming van 30 minuten op één enkele RTX 5090-videokaart.
Vooral het leren uitsluitend van mensenvideo is opmerkelijk. Volgens The Decoder kon een robot met twee handen met vijf vingers een lucifer aansteken, een banaan snijden of pakketten op een lopende band gooien zonder voor die taken op afstand te zijn bestuurd. De succespercentages schommelden per taak tussen 10 en 80%. Volgens Nvidia is het voldoende dat een mens de handelingen voordoet met datahandschoenen, speciale handgrijpers of een vingerexoskelet. Uit één enkele video van een hamerslag leerde het systeem via een simulatie bovendien spijkers inslaan.
Bij fijnmotorische taken met twee Sharpa-handen noemt Nvidia 85% succes bij het plaatsen van GB300-geheugenmodules en 65% bij het in elkaar zetten van een speelgoedvrachtwagen. Versterkend leren op de echte robot tilde drie insteektaken met veel contact naar 88 tot 96%.
Taalmodel als dirigent, en als rem
Voor langere montagewerkzaamheden combineert Nvidia GR00T 2 met een overkoepelend AI-taalmodel dat de software via een interface aanroept. Volgens The Decoder kan dat bijvoorbeeld OpenAI's GPT-6 Astra zijn. Het taalmodel splitst de taak in stappen, markeert grijppunten in het camerabeeld en start hulpprogramma's wanneer een onderdeel valt. Volgens Nvidia voltooide de robot zo elk van drie speelgoedmodellen in minstens 97 van 100 opeenvolgende pogingen. Zonder het corrigerende taalmodel en extra natraining lukte het in elkaar zetten van de speelgoedauto volgens The Decoder maar in 23 van 100 gevallen. Met gekleurde grijpmarkeringen volgde de robot de instructies in 92% van de gevallen, tegenover 40% met alleen de taakinstructie.
De prijs is snelheid: bij het sorteren van afval stond de robot volgens The Decoder ongeveer een derde van de tijd stil, omdat hij gemiddeld meer dan zeven seconden op het planningsmodel moest wachten. Voor tweebenige robots heeft Nvidia daarom de afgeslankte variant GR00T 2 Turbo ontwikkeld. Volgens Nvidia heeft die 124 milliseconden per voorspelling nodig en draait ze rechtstreeks op de boordcomputer Jetson Thor van de Unitree G1. De robot schepte in alle 48 pogingen popcorn en ruimde in 93% van de pogingen een tafel af. Vloeistof opvegen met een handdoek onder de voet lukte volgens The Decoder maar in ongeveer de helft van de pogingen.
Openstaande hobbels voor praktisch gebruik
- Het model verwerkt nog geen directe sensordata voor de tastzin.
- Het ziet soms fijne fouten over het hoofd, zoals half ingedraaide schroeven.
- De succespercentages schommelen sterk en liggen bij veel taken ver onder 95%.
- De plaatsen bij de beste drie modellen in benchmarks als RoboCasa365, RoboLab, RoboDojo en MolmoSpaces zijn een bewering van Nvidia.
Bij de lancering noemt Nvidia partners die het model testen: volgens The Robot Report past Foxconn het toe in fabrieksautomatisering voor de productie van servers, evalueert Siemens het voor industriële toepassingen en test Nexuni het voor wasserijen. Met Isaac Lab 3.0 presenteerde Nvidia bovendien een nieuwe versie van zijn open-source framework voor het trainen van robots in simulatie.
Wat dit verandert voor bedrijven in Nederland
Voor Nederlandse fabrikanten en logistieke bedrijven is GR00T 2 nog geen product om aan te zetten, maar wel een signaal: het aanleren van robots kan verschuiven van dure teleoperatie naar video's en een handvol demonstraties. Dat is onze inschatting, geen uitspraak van Nvidia. Een kleine pilot op een taak met veel varianten is verstandig, waar een mislukte greep weinig kost en een percentage onder 95% te verdragen is. Bedrijven die video's van medewerkers als trainingsmateriaal willen gebruiken, moeten vroeg de functionaris gegevensbescherming en de ondernemingsraad betrekken. Labcijfers zijn pas betrouwbaar als ze met uw eigen onderdelen en op uw eigen werkvloer zijn bevestigd.
Bronnen
- GR00T 2 zeigt Nvidias neuen Kurs bei KI-Modellen für RoboterThe Decoder · 10 november 2026
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and AdaptationNVIDIA Research (GEAR) · 10 november 2026
- NVIDIA launches GR00T 2 and Isaac Lab 3.0 at CoRLThe Robot Report · 10 november 2026