엔비디아 GR00T 2, 로봇이 사람 영상으로 손동작을 배운다
엔비디아 GR00T 2는 사람 영상의 손동작을 로봇에 옮긴다. 훈련 없이 성공률 40%, 시연 5번 뒤 95%. 다만 실용화의 벽은 여전히 높다.
엔비디아는 미국 텍사스주 오스틴에서 열린 로봇 학습 학회 CoRL에서 로봇용 파운데이션 모델의 2세대인 GR00T 2를 공개했다. 이 모델은 업계의 핵심 문제를 덜어 주는 것을 목표로 한다. 지금까지 로봇이 새로운 손동작을 익히려면 사람이 몇 시간씩 원격으로 조종하는 방식이 대부분이었다. The Decoder에 따르면 이른바 원격 조작은 비용이 많이 들고 느리며, 얻은 데이터도 특정 로봇 기종에서만 쓸모가 있다. GR00T 2는 그 대신 사람의 영상에 의존한다.
영상으로 미래를 예측하는 모델
엔비디아에 따르면 GR00T 2는 이른바 월드-액션 모델이다. 이전 세대인 GR00T 1과 달리 카메라 이미지와 언어 명령을 곧바로 모터 동작으로 바꾸지 않는다. 다음 동작과 바로 뒤의 미래를 담은 짧은 영상을 동시에 계산한다. 예를 들어 로봇 팔이 물건을 집을 때 카메라 화면이 어떻게 바뀌어야 하는지를 예측하는 것이다. 엔비디아의 연구 보고서에 따르면 하나의 확산 트랜스포머가 미래 영상과 동작 묶음을 함께 처리하고, 로봇마다 있는 작은 모듈이 계획을 모터 명령으로 바꾼다.
이런 영상 예측을 통해 모델은 서로 다른 로봇 형태 사이에서 동작 흐름을 옮길 수 있다고 한다. 엔비디아는 병렬 그리퍼, 다섯 손가락 손, 휴머노이드에서 작동한다고 밝혔다. The Decoder에 따르면 학습은 GB300 칩 1000개 이상으로 이뤄진 클러스터에서 진행됐다. 엔비디아에 따르면 학습 데이터는 세 종류로 구성된다.
- 머리에 단 카메라로 촬영한, 일하는 사람의 1인칭 영상 40만 2730시간
- 손에 든 UMI 그리퍼로 2897개 과제를 시연한 1만 184시간
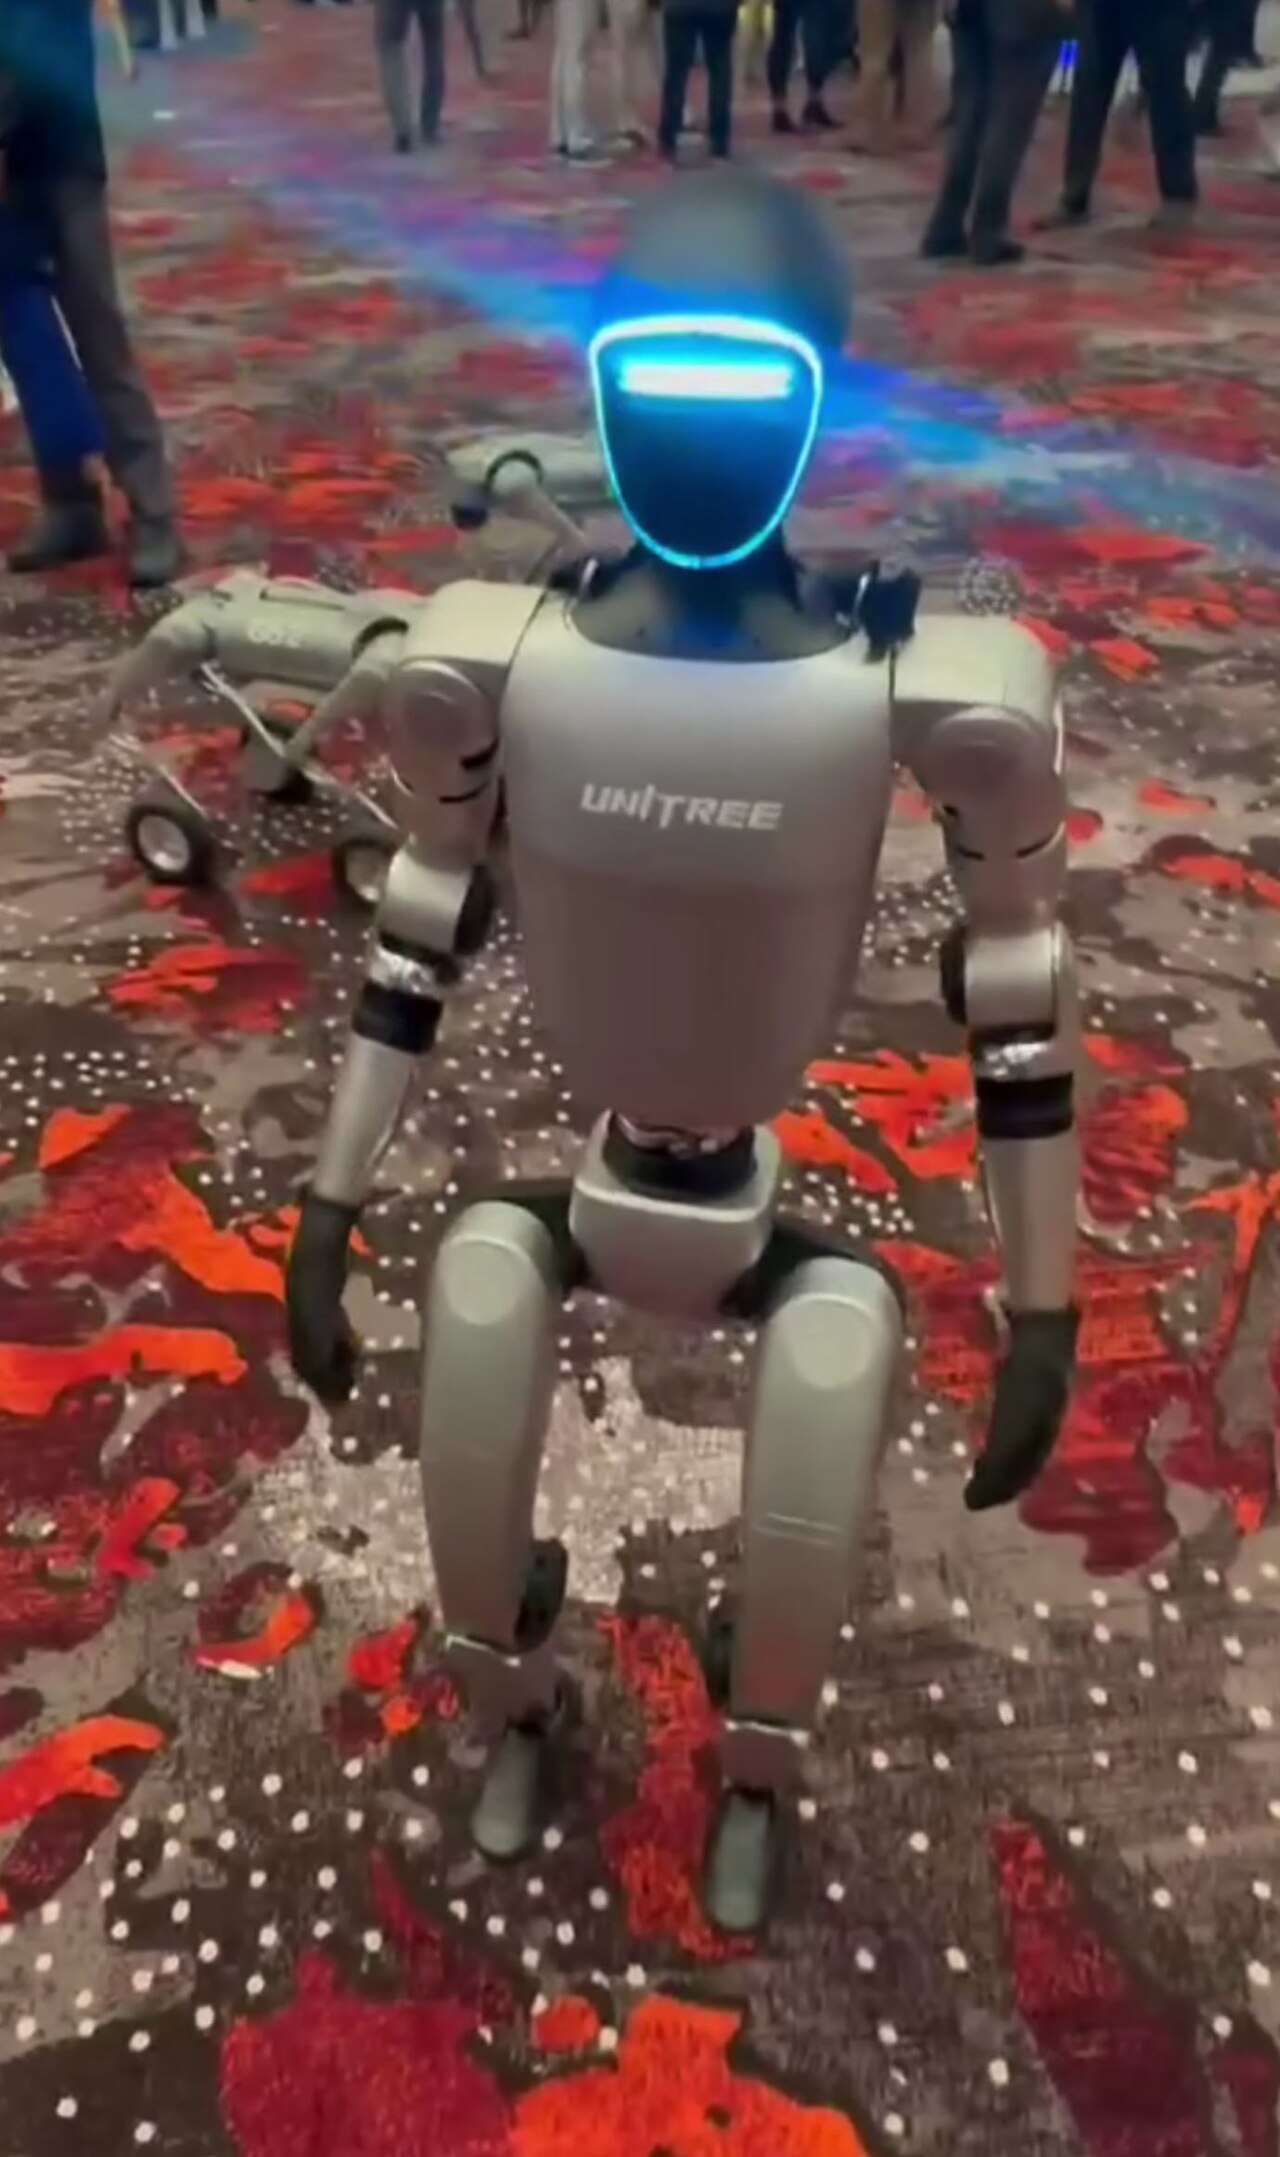
- 병렬 그리퍼 팔, 샤프파와 우지의 손, 휴머노이드 유니트리 G1 등 로봇 원격 조작 데이터 2만 3500시간
엔비디아에 따르면 사람 영상 가운데 10만 시간은 Human-1M-100K라는 이름으로 허깅페이스에 공개돼 있다. The Robot Report는 GR00T 2를 개방형 최첨단 월드-액션 모델이라고 설명한다. 모델 가중치의 정확한 라이선스 조건은 우리가 읽은 자료에서는 확인하지 못했다.
숫자가 보여 주는 것과 보여 주지 않는 것
모든 결과는 실험실 시험과 엔비디아 자체에서 나온 것이며, 지금까지 독립적으로 검증된 것은 없다. 대상 로봇이 한 번도 연습하지 않은 50개 과제에서, 엔비디아에 따르면 로봇 시연 없이 40%가 성공했다. 과제마다 시연을 한 번 주자 성공률은 71%로, 다섯 번(로봇 데이터는 합쳐서 3분 미만) 주자 95%로 올랐다. 엔비디아에 따르면 RTX 5090 그래픽카드 한 장으로 30분 동안 미세 조정하면 충분하다.
사람 영상만으로 배운다는 점이 특히 눈에 띈다. The Decoder에 따르면 다섯 손가락 손 두 개를 가진 로봇이 해당 과제를 위해 원격 조종된 적이 없는데도 성냥에 불을 붙이고, 바나나를 자르고, 소포를 컨베이어 벨트에 던질 수 있었다. 성공률은 과제에 따라 10%에서 80% 사이로 크게 출렁였다. 엔비디아에 따르면 사람이 데이터 장갑, 전용 손 그리퍼, 손가락 외골격으로 동작을 보여 주기만 하면 된다. 망치질 영상 하나로 시뮬레이션을 거쳐 못 박는 법도 익혔다.
샤프파 손 두 개를 쓰는 정밀 과제에서 엔비디아는 GB300 메모리 모듈 장착 성공률 85%, 장난감 트럭 조립 성공률 65%를 제시했다. 실제 로봇에서의 강화 학습은 접촉이 많은 삽입 과제 세 가지를 88%에서 96%로 끌어올렸다.
지휘자이자 브레이크인 언어 모델
긴 조립 작업에서는 엔비디아가 GR00T 2를 상위 AI 언어 모델과 결합하고, 언어 모델이 인터페이스를 통해 이 소프트웨어를 호출한다. The Decoder에 따르면 예를 들어 OpenAI의 GPT-6 Astra가 이 역할을 할 수 있다. 언어 모델은 작업을 단계로 나누고, 카메라 이미지에 집을 지점을 표시하고, 부품이 떨어지면 보조 프로그램을 실행한다. 엔비디아에 따르면 이렇게 해서 장난감 세 종류를 각각 연속 100번 중 최소 97번 완성했다. The Decoder에 따르면 교정 역할의 언어 모델과 추가 후속 훈련이 없으면 장난감 자동차 조립은 100번 중 23번만 성공했다. 색깔로 집을 지점을 표시하면 로봇이 지시를 따른 비율은 92%로, 과제 지시만 줬을 때의 40%를 웃돌았다.
대가는 속도다. The Decoder에 따르면 쓰레기를 분류할 때 로봇은 계획 모델을 평균 7초 넘게 기다려야 해서 전체 시간의 약 3분의 1 동안 멈춰 있었다. 그래서 엔비디아는 두 발 로봇용으로 경량판 GR00T 2 Turbo를 만들었다. 엔비디아에 따르면 예측 한 번에 124밀리초가 걸리고, 유니트리 G1에 탑재된 컴퓨터 젯슨 토르에서 직접 돌아간다. 로봇은 48번의 시도 모두에서 팝콘을 퍼냈고 93%의 시도에서 탁자를 치웠다. 발밑 수건으로 액체를 닦는 일은 The Decoder에 따르면 시도의 절반 정도에서만 성공했다.
실제 투입에 남은 과제
- 모델은 아직 촉각을 위한 직접적인 센서 데이터를 처리하지 못한다.
- 반쯤만 조인 나사 같은 미세한 오류를 놓치기도 한다.
- 성공률 편차가 크고, 많은 과제에서 95%에 크게 못 미친다.
- RoboCasa365, RoboLab, RoboDojo, MolmoSpaces 같은 벤치마크에서 상위 3위 안에 들었다는 것은 엔비디아의 주장이다.
공개와 함께 엔비디아는 모델을 시험 중인 파트너를 밝혔다. The Robot Report에 따르면 폭스콘은 서버 제조 공장 자동화에, 지멘스는 산업 활용 사례 평가에, Nexuni는 세탁 업무 시험에 쓰고 있다. 엔비디아는 시뮬레이션에서 로봇을 훈련하는 오픈소스 프레임워크의 새 버전인 Isaac Lab 3.0도 함께 공개했다.
한국 기업에 어떤 의미인가
한국의 제조·물류 기업에게 GR00T 2는 아직 켜기만 하면 쓰는 제품은 아니지만 하나의 신호다. 로봇을 가르치는 방식이 비싼 원격 조종에서 영상과 소수의 시연으로 옮겨 갈 수 있다. 이는 우리의 판단이며 엔비디아의 발언이 아니다. 현실적인 첫걸음은 변형이 많고, 집기에 실패해도 비용이 작으며, 성공률이 95% 아래여도 감당할 수 있는 작업에서 작은 시범 사업을 해 보는 것이다. 직원 영상을 훈련 자료로 쓰려는 기업은 개인정보 보호 담당자와 근로자 대표를 일찍 참여시켜야 한다. 실험실 수치는 자사 부품과 자사 현장에서 확인된 뒤에야 믿을 만하다.
출처
- GR00T 2 zeigt Nvidias neuen Kurs bei KI-Modellen für RoboterThe Decoder · 2026년 11월 10일
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and AdaptationNVIDIA Research (GEAR) · 2026년 11월 10일
- NVIDIA launches GR00T 2 and Isaac Lab 3.0 at CoRLThe Robot Report · 2026년 11월 10일