Apple meldt gedistribueerde AI-inferentie via ongebruikte Macs van werknemers
Apple zegt intern een gedistribueerde GPU-cloud te hebben opgebouwd uit ongebruikte Apple Silicon-Macs. Het gemelde ontwerp is bedoeld voor AI-inferentie wanneer de capaciteit van gecentraliseerde GPU’s onder druk staat, met duidelijke beperkingen.
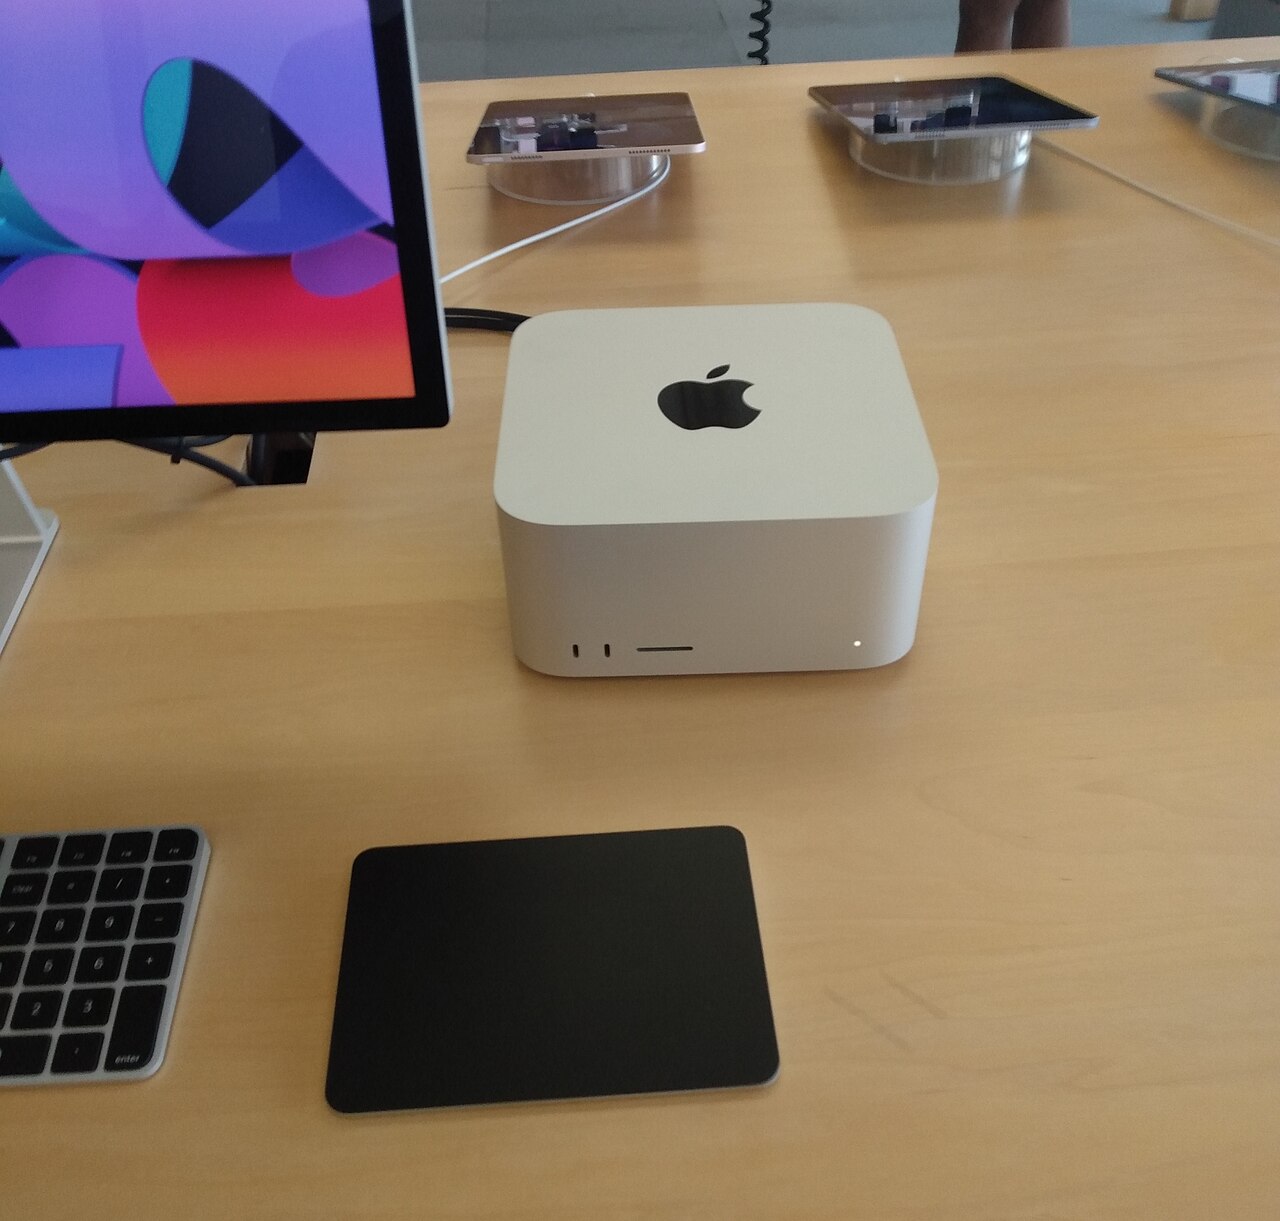
Apple heeft een intern systeem beschreven met de naam Minions, dat ongebruikte GPU’s van macOS-apparaten met Apple Silicon bundelt en omzet in een gedistribueerde rekenbron voor machine-learning-inferentie. In een onderzoekssamenvatting die is gepubliceerd door Apple Machine Learning Research presenteert het bedrijf Minions als “een dynamische en gedistribueerde virtuele GPU-cloud” die inactieve GPU’s op Macs samenbrengt om grootschalige inferentieworkloads uit te voeren. Het genoemde doel is praktisch: hardware benutten die binnen het bedrijf al aanwezig is, in plaats van extra GPU’s aan te schaffen wanneer de capaciteit van een centraal systeem beperkt is.
De samenvatting van het artikel blijft voorzichtig in reikwijdte. Ze plaatst het probleem in de context van een groeiende vraag naar GPU-versnelde inferentie, naast de beperkingen van gecentraliseerde GPU-infrastructuur, waaronder kosten, beperkte elasticiteit en lange wachttijden wanneer middelen schaars zijn. De onderzoekers van Apple stellen dat moderne Apple Silicon-Macs al over krachtige GPU’s beschikken die tijdens normaal gebruik vaak grotendeels ongebruikt blijven. Hun stelling is dat deze slapende middelen kunnen worden georganiseerd tot een bruikbaar inferentieplatform voor teams die rekenkracht nodig hebben, maar niet altijd tijdig toegang krijgen tot een centrale cluster.
Een virtuele GPU-cloud gebouwd uit kantoor-Macs
Volgens Apple’s onderzoekspagina is Minions ontworpen voor inferentie en niet voor algemene AI-training. Dat onderscheid is belangrijk. Inferentieworkloads kunnen vaak flexibeler worden opgesplitst en ingepland dan grootschalige modeltraining, en Apple zegt dat het systeem flexibele uitvoering van GPU-inferentietaken, fouttolerantie en efficiënt gebruik van middelen biedt. De samenvatting van het bedrijf bevat in de hier aangeleverde brontekst geen gedetailleerde benchmarktabellen, maar stelt wel dat de eigen ervaring laat zien dat inactieve macOS-apparaten een praktisch gedistribueerd GPU-inferentieplatform kunnen vormen wanneer gecentraliseerde GPU-middelen beperkt zijn.
Een apart bericht van de Franse titel 01net voegt architectuurdetails en operationele beweringen toe die niet expliciet in Apple’s korte samenvatting staan. Omdat deze bijzonderheden uit een secundair bericht komen, moeten ze worden gelezen als gerapporteerde beschrijvingen en niet als details die hier onafhankelijk zijn bevestigd op basis van Apple’s samenvatting zelf. Volgens 01net moesten sommige interne AI-taken eerder uren in de wachtrij staan omdat gecentraliseerde GPU’s niet beschikbaar waren, en heeft Minions de opstarttijd van veel van die taken teruggebracht tot minuten. Dat is een opmerkelijke bewering, maar het blijft een bewering uit dat bericht zolang die niet rechtstreeks in de onderliggende publicatie is geverifieerd.
Gerapporteerde architectuur: vier bewegende delen
01net beschrijft Minions als een systeem dat op vier hoofdcomponenten rust. In dat overzicht ontvangt een centrale Minion Server verzoeken van teams en splitst die op in subtaken. De status daarvan zou worden bijgehouden in een PostgreSQL-database. Elke aangesloten Mac draait vervolgens een Minion Executor, die het toegewezen deel op de lokale GPU verwerkt, resultaten uploadt naar S3-opslag en de status terugrapporteert aan de server. Een aparte Minion Watchdog houdt toezicht op het geheel en wijst werk opnieuw toe als een machine niet meer reageert. Dashboards zouden daarbij realtime inzicht geven in de toestand van het systeem.
- Een centrale Minion Server die taken accepteert en opsplitst in subtaken
- Een PostgreSQL-database die volgens 01net wordt gebruikt om de taakstatus bij te houden
- Een Minion Executor op elke aangesloten Mac die GPU-werk lokaal uitvoert
- Een Minion Watchdog die storingen detecteert en onderbroken taken opnieuw toewijst
Als deze beschrijving klopt, wijst die architectuur erop dat Apple heeft gekozen voor een vrij klassiek control-plane-patroon voor een sterk heterogene en instabiele pool van apparaten. Kantoor-Macs zijn geen dedicated servers: ze kunnen de verbinding verbreken, in de sluimerstand gaan, opnieuw door werknemers worden gebruikt of zonder waarschuwing onbeschikbaar worden. In die context zijn het opsplitsen van taken, het persistent volgen van status en een watchdog-proces geen optionele extra’s, maar kernvereisten. De architectuur suggereert ook dat Minions eerst is geoptimaliseerd voor gedistribueerde beschikbaarheid en foutafhandeling, en pas daarna voor maximale ruwe doorvoer.
Waar Minions op lijkt te optimaliseren
Beide bronnen wijzen strategisch in dezelfde richting. Minions wordt niet gepresenteerd als een poging om gecentraliseerde GPU-clusters in Nvidia-stijl voor de grootste frontier-modellen te evenaren. In plaats daarvan ligt de nadruk op het terugwinnen van onderbenutte middelen die al op bureaus staan en die beschikbaar maken voor inferentietaken binnen het bedrijf. 01net zegt expliciet dat het doel beschikbaarheid is en niet brute rekenkracht, en dat het systeem bedoeld is om capaciteit die al op het interne netwerk aanwezig is te herverdelen naar teams die daar zelf niet over beschikken.
Die positionering past bij de beperkte maar duidelijke formulering in Apple’s eigen samenvatting. Het bedrijf benadrukt de mogelijkheid om bestaande hardware te benutten zonder extra GPU’s aan te schaffen en verankert het systeem herhaaldelijk in omgevingen waar gecentraliseerde GPU-middelen beperkt zijn. Anders gezegd: de waardepropositie draait minder om het verslaan van een doelgericht gebouwd datacentercluster op prestaties, en meer om het verminderen van verspilling van ongebruikte hardware en het soepeler maken van de toegang tot rekenkracht voor interne gebruikers.
De beperkingen horen bij het verhaal
Dezelfde bronnen maken ook duidelijk dat deze architectuur met betekenisvolle beperkingen komt. Ten eerste wordt Minions besproken in de context van inferentieworkloads, niet van volledige training op grote schaal. Ten tweede is het afhankelijk van ongebruikte Apple Silicon-macOS-apparaten, wat betekent dat het aanbod mee fluctueert met het gedrag van werknemers en het gebruik van apparaten. Een gedistribueerde pool die is opgebouwd uit gebruikersmachines is van nature dynamisch: nodes kunnen verdwijnen, prestaties kunnen verschillen tussen Mac-modellen en het systeem moet storingen kunnen verdragen als normale operationele toestand.
Ten derde spelen opslag- en orkestratie-overheads waarschijnlijk een centrale rol in het ontwerp. Het gemelde gebruik van een centrale server, een database en opslag voor resultaten in S3-stijl wijst erop dat taakcoördinatie en dataverplaatsing belangrijke aandachtspunten zijn. Gedistribueerde inferentie kan profiteren van veel GPU’s, maar niet elk model of elke taak laat zich netjes opdelen. Dat helpt te verklaren waarom fouttolerantie en flexibiliteit in planning in Apple’s samenvatting worden benadrukt, terwijl beweringen over extreme prestaties dat niet worden.
01net meldt ook dat recente Mac mini- en Mac Studio-systemen via RDMA over Thunderbolt 5 aan elkaar gekoppeld kunnen worden, waarbij geheugen en rekenkracht worden gecombineerd om een model te laden dat te groot is voor één enkele machine. Dat is een opvallend detail, maar in de hier aangeleverde bronnen komt het alleen voor in het artikel van 01net, en niet in de korte samenvatting van Apple die hierboven is aangehaald. Het moet daarom worden gelezen als een gerapporteerde mogelijkheid en niet als een punt dat door beide bronnen is vastgesteld. Als het is geïmplementeerd zoals beschreven, zou het een van de duidelijkste knelpunten van inferentie op Macs met één apparaat aanpakken: de verhouding tussen modelgrootte en de limieten van lokaal geheugen.
Wat Apple zegt — en wat het niet zegt
Apple’s eigen onderzoekssamenvatting valt op door haar terughoudendheid. Daarin staat dat Minions inactieve Macs kan omvormen tot een praktisch gedistribueerd GPU-inferentieplatform en dat het systeem flexibele taakuitvoering, fouttolerantie en efficiënt gebruik van middelen biedt. In de hier beschikbare brontekst wordt niet beweerd dat deze aanpak gecentraliseerde clusters vervangt, dat zij breed ondersteuning biedt voor gigantische modellen, of dat zij geschikt is voor elke AI-workload. Juist die weglatingen zijn informatief. Ze suggereren dat Minions een gerichte interne reactie is op een specifieke bottleneck: schaarse gedeelde toegang tot GPU’s voor inferentietaken die kunnen worden verspreid over een vluchtige pool van Apple Silicon-apparaten.
Voor Nederlandstalige bedrijven is de concrete les niet dat kantoorlaptops en desktops eenvoudig datacenter-GPU’s kunnen vervangen. Wel laat dit zien dat, waar de gecentraliseerde inferentiecapaciteit beperkt is, een zorgvuldig beheerde pool van ongebruikte Macs van werknemers mogelijk een aanvullende interne laag kan bieden voor geschikte workloads — op voorwaarde dat een organisatie orkestratie, storingen, ongelijkmatige beschikbaarheid van apparaten en de beperktere reikwijdte van inferentiegerichte taken kan opvangen, in plaats van de grootste trainingsworkloads.
Bronnen
- Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon DevicesApple Machine Learning Research · 1 oktober 2026
- À court de cartes graphiques, Apple réquisitionne les Mac de ses employés01net · 15 oktober 2026