Apple relata inferência de IA distribuída a partir de Macs ociosos de funcionários
A Apple afirma ter criado uma nuvem interna de GPUs distribuída a partir de Macs com Apple Silicon que estavam sem uso. Segundo o relato, o projeto mira a inferência de IA quando a capacidade centralizada de GPU está limitada, com limites bem definidos.
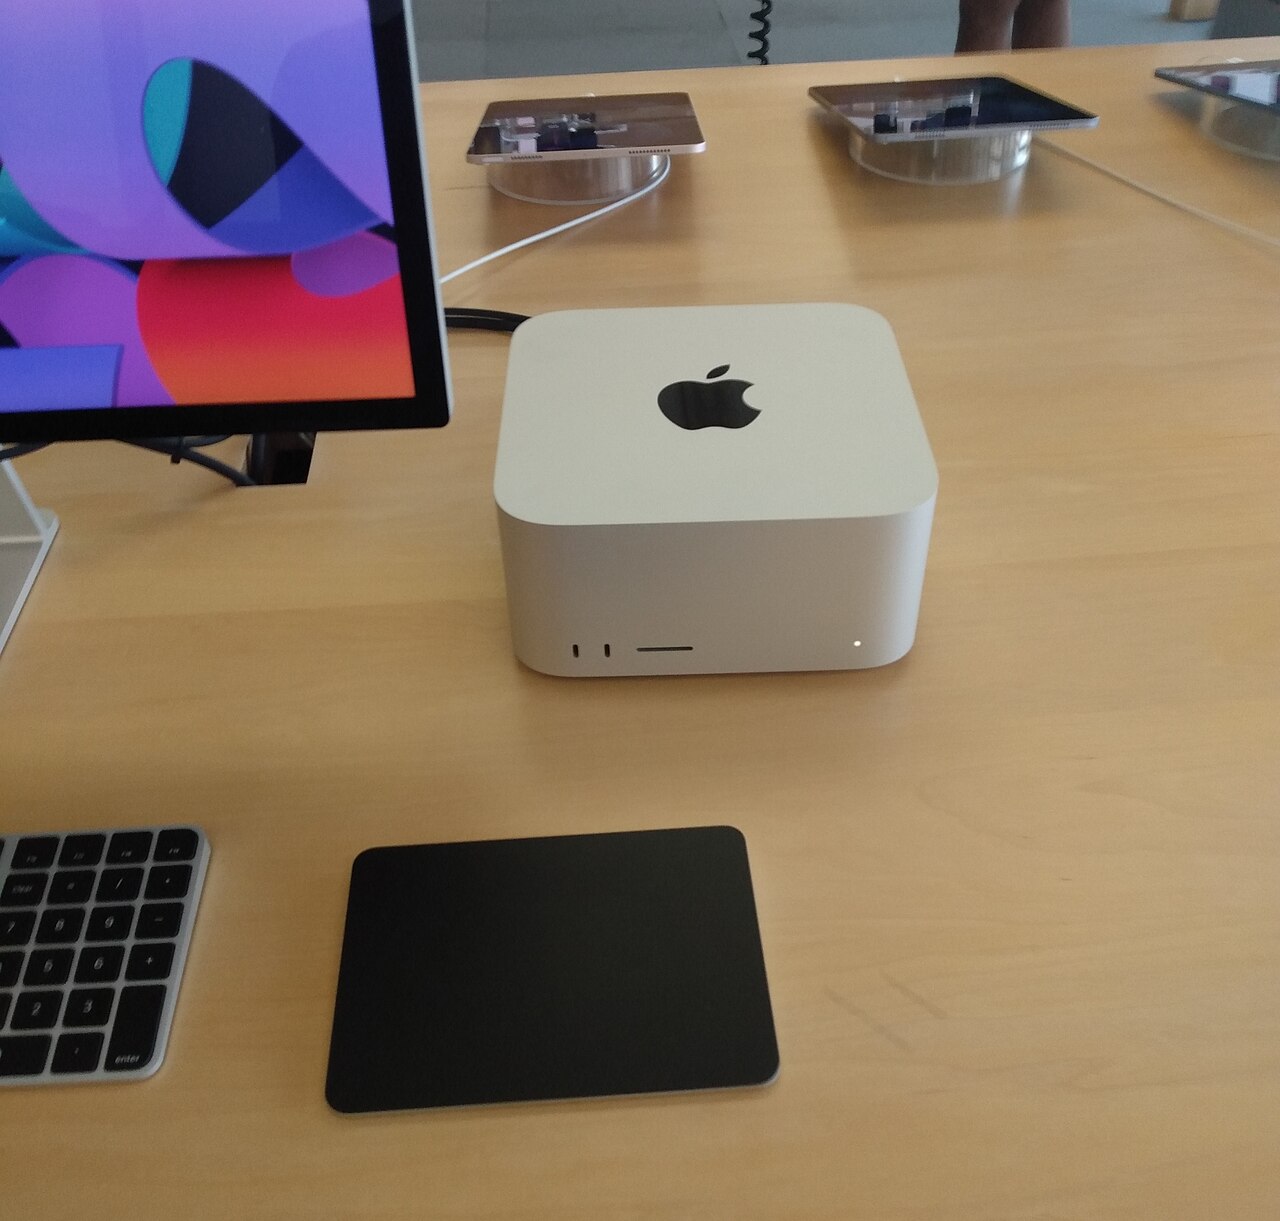
A Apple descreveu um sistema interno chamado Minions que reúne GPUs não utilizadas de dispositivos macOS com Apple Silicon e as transforma em um recurso distribuído de computação para inferência de aprendizado de máquina. Em um resumo de pesquisa publicado pela Apple Machine Learning Research, a empresa apresenta o Minions como “uma nuvem virtual de GPU dinâmica e distribuída” que agrega GPUs ociosas de Macs para executar cargas de trabalho de inferência em larga escala. O objetivo declarado é prático: usar hardware que a empresa já possui internamente, em vez de adquirir GPUs adicionais quando a capacidade centralizada está apertada.
O resumo do artigo é cauteloso quanto ao escopo. Ele enquadra o problema como um aumento da demanda por inferência acelerada por GPU, ao lado dos limites da infraestrutura centralizada de GPUs, incluindo custo, elasticidade restrita e longas esperas quando os recursos ficam escassos. Os pesquisadores da Apple argumentam que os Macs modernos com Apple Silicon já contêm GPUs poderosas que, durante o uso normal, muitas vezes ficam em grande parte ociosas. A tese apresentada é que esses recursos adormecidos podem ser organizados em uma plataforma útil de inferência para equipes que precisam de computação, mas nem sempre conseguem acesso rápido a um cluster central.
Uma nuvem virtual de GPU construída a partir de Macs de escritório
De acordo com a página de pesquisa da Apple, o Minions foi projetado para inferência, e não para treinamento de IA de uso geral. Essa distinção é importante. Cargas de trabalho de inferência muitas vezes podem ser divididas e agendadas com mais flexibilidade do que o treinamento de modelos em larga escala, e a Apple afirma que o sistema oferece execução flexível de tarefas de inferência em GPU, tolerância a falhas e uso eficiente de recursos. O resumo da empresa não traz, no texto-fonte fornecido aqui, tabelas detalhadas de benchmark, mas afirma que sua experiência mostra que dispositivos macOS ociosos podem se tornar uma plataforma prática de inferência distribuída por GPU em cenários nos quais os recursos centralizados de GPU estão limitados.
Uma reportagem separada do veículo francês 01net acrescenta detalhes de arquitetura e alegações operacionais que não aparecem explicitamente no resumo curto da Apple. Como esses pontos vêm de uma fonte secundária, eles devem ser tratados como descrições reportadas, e não como detalhes confirmados aqui de forma independente a partir do próprio resumo da Apple. Segundo a 01net, alguns trabalhos internos de IA antes esperavam por horas em fila porque GPUs centralizadas não estavam disponíveis, e o Minions teria reduzido o tempo de início de muitas dessas tarefas para minutos. Trata-se de uma afirmação relevante, mas ainda assim continua sendo uma afirmação do relatório, a menos que seja verificada diretamente no artigo subjacente.
Arquitetura relatada: quatro partes em movimento
A 01net descreve o Minions como apoiado em quatro componentes principais. Nessa versão, um Minion Server central recebe solicitações das equipes e as divide em subtarefas. O estado dessas subtarefas seria acompanhado em um banco de dados PostgreSQL. Cada Mac inscrito no sistema então executa um Minion Executor, que processa localmente sua parte atribuída na GPU, envia os resultados para um armazenamento S3 e reporta o status de volta ao servidor. Um componente separado, chamado Minion Watchdog, supervisiona a frota e redistribui o trabalho se uma máquina parar de responder. Painéis de controle supostamente oferecem visibilidade em tempo real sobre o estado do sistema.
- Um Minion Server central que aceita trabalhos e os divide em subtarefas
- Um banco de dados PostgreSQL usado para acompanhar o estado das tarefas, segundo a 01net
- Um Minion Executor em cada Mac inscrito que executa o trabalho de GPU localmente
- Um Minion Watchdog que detecta falhas e realoca tarefas interrompidas
Se estiver correta, essa arquitetura sugere que a Apple escolheu um padrão de plano de controle relativamente clássico para um conjunto de dispositivos altamente heterogêneo e instável. Macs de escritório não são servidores dedicados: eles podem se desconectar, entrar em repouso, ser retomados pelos funcionários ou se tornar indisponíveis sem aviso. Nesse contexto, a divisão das tarefas, o rastreamento persistente de estado e um processo de supervisão não são extras opcionais, mas requisitos centrais. A arquitetura também sugere que o Minions foi otimizado primeiro para disponibilidade distribuída e tratamento de falhas, antes de ser otimizado para o maior throughput bruto possível.
O que o Minions parece otimizar
As duas fontes apontam na mesma direção em termos de estratégia. O Minions não é apresentado como uma tentativa de rivalizar com clusters centralizados de GPU ao estilo Nvidia para os maiores modelos de fronteira. Em vez disso, a ênfase está em recuperar recursos subutilizados que já estão sobre mesas de trabalho e torná-los disponíveis para tarefas de inferência dentro da empresa. A 01net afirma explicitamente que o objetivo é disponibilidade, e não força bruta, e que o sistema serve para redistribuir a capacidade já presente na rede interna para equipes que não a possuem.
Esse posicionamento combina com a formulação limitada, mas clara, do próprio resumo da Apple. A empresa destaca a capacidade de aproveitar hardware existente sem a necessidade de adquirir GPUs adicionais e ancora repetidamente o sistema em ambientes nos quais os recursos centralizados de GPU estão restritos. Em outras palavras, a proposta de valor parece menos relacionada a superar em desempenho um cluster de datacenter construído especificamente para isso e mais a reduzir o desperdício de hardware ocioso, ao mesmo tempo em que suaviza o acesso à computação para usuários internos.
As restrições fazem parte da história
As mesmas fontes também deixam claro que essa arquitetura vem com restrições significativas. Primeiro, o Minions é discutido no contexto de cargas de trabalho de inferência, não de treinamento em escala total. Segundo, ele depende de dispositivos macOS com Apple Silicon que estejam ociosos, o que significa que a oferta oscila de acordo com o comportamento dos funcionários e com o uso dos aparelhos. Um conjunto distribuído construído a partir de máquinas de usuários é, por natureza, dinâmico: nós podem desaparecer, o desempenho pode variar entre diferentes modelos de Mac e o sistema precisa tolerar falhas como uma condição operacional normal.
Terceiro, os custos indiretos de armazenamento e orquestração provavelmente são centrais no desenho do sistema. O uso relatado de um servidor central, de um banco de dados e de um armazenamento de resultados no estilo S3 indica que a coordenação dos trabalhos e a movimentação de dados são considerações importantes. A inferência distribuída pode se beneficiar de muitas GPUs, mas nem todo modelo ou tarefa se divide de forma limpa. Isso ajuda a explicar por que tolerância a falhas e flexibilidade de agendamento são enfatizadas no resumo da Apple, enquanto alegações sobre desempenho extremo não são.
A 01net também relata que sistemas Mac mini e Mac Studio recentes podem ser associados via RDMA sobre Thunderbolt 5, combinando memória e computação para carregar um modelo grande demais para uma única máquina. É um detalhe chamativo, mas, nas fontes fornecidas aqui, ele aparece apenas no artigo da 01net, e não no resumo curto da Apple citado acima. Portanto, deve ser lido como uma capacidade reportada, e não como um ponto estabelecido por ambas as fontes. Se implementado como descrito, isso enfrentaria um dos gargalos mais óbvios da inferência em Macs de um único dispositivo: o tamanho do modelo em relação aos limites de memória local.
O que a Apple está dizendo — e o que não está
O próprio resumo de pesquisa da Apple chama atenção pela contenção. Ele afirma que o Minions pode transformar Macs ociosos em uma plataforma prática de inferência distribuída por GPU e que o sistema fornece execução flexível de tarefas, tolerância a falhas e uso eficiente de recursos. No texto-fonte disponível aqui, ele não afirma que essa abordagem substitui clusters centralizados, que dá suporte amplo a modelos gigantes ou que seja adequada para toda carga de trabalho de IA. Essas omissões são informativas. Elas sugerem que o Minions é uma resposta interna direcionada a um gargalo específico: a escassez de acesso compartilhado a GPU para tarefas de inferência que podem ser distribuídas por um conjunto volátil de dispositivos com Apple Silicon.
Para empresas, a conclusão concreta não é que laptops e desktops de escritório possam simplesmente substituir GPUs de datacenter. A lição é que, quando a capacidade centralizada de inferência é limitada, um conjunto de Macs ociosos de funcionários, administrado com cuidado, pode oferecer uma camada interna complementar para cargas de trabalho adequadas — desde que a empresa consiga lidar com orquestração, falhas, disponibilidade desigual dos dispositivos e o escopo mais estreito implícito por tarefas orientadas à inferência, e não pelas maiores cargas de treinamento.
Fontes
- Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon DevicesApple Machine Learning Research · 1 de outubro de 2026
- À court de cartes graphiques, Apple réquisitionne les Mac de ses employés01net · 15 de outubro de 2026