Apple meldet verteilte KI-Inferenz mit ungenutzten Macs von Mitarbeitenden
Apple erklärt, intern eine verteilte GPU-Cloud aus ungenutzten Apple-Silicon-Macs aufgebaut zu haben. Das beschriebene Design zielt auf KI-Inferenz ab, wenn zentrale GPU-Kapazitäten knapp sind, und setzt dabei klare Grenzen.
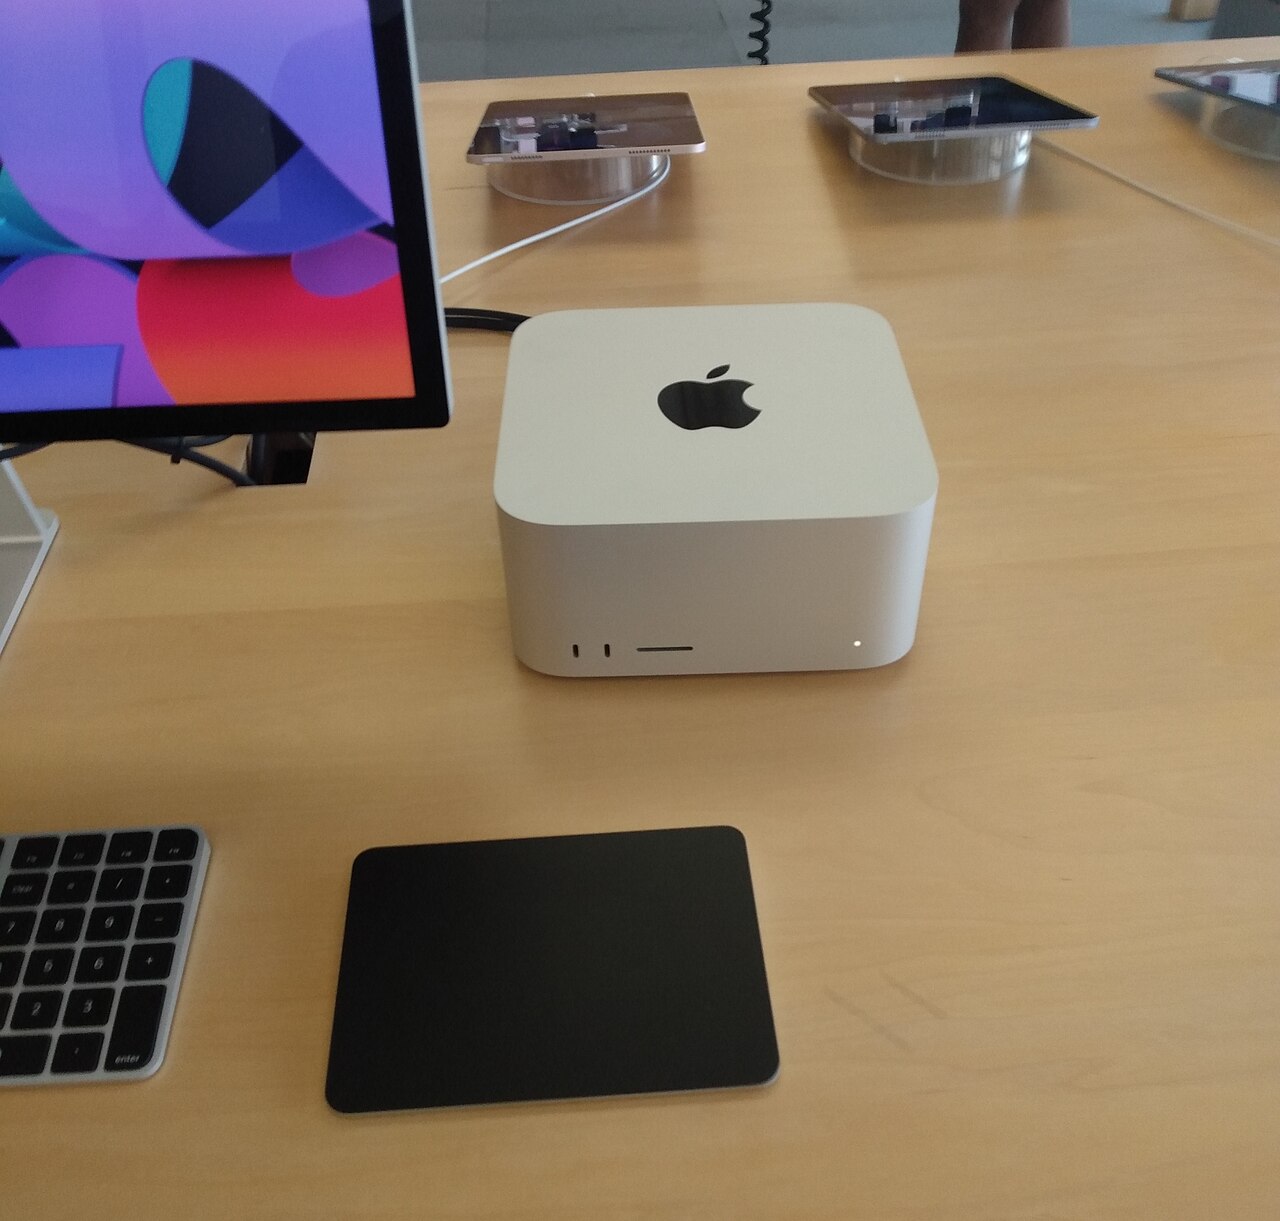
Apple hat ein internes System mit dem Namen Minions beschrieben, das ungenutzte GPUs von macOS-Geräten mit Apple Silicon bündelt und in eine verteilte Rechenressource für Machine-Learning-Inferenz verwandelt. In einer Forschungszusammenfassung von Apple Machine Learning Research präsentiert das Unternehmen Minions als eine „dynamische und verteilte virtuelle GPU-Cloud“, die ungenutzte GPUs über Macs hinweg aggregiert, um Inferenz-Workloads in großem Maßstab auszuführen. Das genannte Ziel ist pragmatisch: Hardware zu nutzen, die im Unternehmen bereits vorhanden ist, anstatt zusätzliche GPUs zu beschaffen, wenn die Kapazität zentraler Systeme knapp ist.
Die Zusammenfassung des Beitrags bleibt beim Umfang vorsichtig. Sie beschreibt das Problem als Folge der wachsenden Nachfrage nach GPU-beschleunigter Inferenz und zugleich der Grenzen zentralisierter GPU-Infrastruktur, darunter Kosten, eingeschränkte Elastizität und lange Wartezeiten, wenn Ressourcen knapp sind. Apples Forschende argumentieren, dass moderne Macs mit Apple Silicon bereits leistungsfähige GPUs enthalten, die im normalen Einsatz oft weitgehend ungenutzt bleiben. Ihre These lautet, dass sich diese brachliegenden Ressourcen zu einer nützlichen Inferenzplattform organisieren lassen für Teams, die Rechenleistung benötigen, aber nicht immer rechtzeitig Zugang zu einem zentralen Cluster erhalten.
Eine virtuelle GPU-Cloud aus Büro-Macs
Laut Apples Forschungsseite ist Minions für Inferenz und nicht für allgemeines KI-Training ausgelegt. Diese Unterscheidung ist wichtig. Inferenz-Workloads lassen sich häufig flexibler aufteilen und planen als groß angelegtes Modelltraining, und Apple erklärt, das System biete eine flexible Ausführung von GPU-Inferenzaufgaben, Fehlertoleranz und eine effiziente Ressourcennutzung. Die Zusammenfassung des Unternehmens enthält in dem hier vorliegenden Quelltext keine detaillierten Benchmark-Tabellen, sie sagt jedoch, die eigenen Erfahrungen zeigten, dass ungenutzte macOS-Geräte zu einer praktikablen verteilten GPU-Inferenzplattform werden können, wenn zentrale GPU-Ressourcen begrenzt sind.
Ein separater Bericht des französischen Mediums 01net ergänzt Architekturdetails und Aussagen zum Betrieb, die in Apples kurzer Zusammenfassung nicht ausformuliert sind. Da diese Einzelheiten aus einem Sekundärbericht stammen, sollten sie als wiedergegebene Beschreibungen gelesen werden und nicht als Angaben, die hier unabhängig anhand der Apple-Zusammenfassung selbst bestätigt werden. 01net schreibt, einige interne KI-Jobs hätten zuvor stundenlang in Warteschlangen gestanden, weil zentrale GPUs nicht verfügbar gewesen seien, und Minions habe die Startzeit vieler dieser Aufgaben auf Minuten verkürzt. Das ist eine bemerkenswerte Behauptung, bleibt aber eine Behauptung des Berichts, solange sie nicht direkt im zugrunde liegenden Paper verifiziert ist.
Berichtete Architektur: vier bewegliche Teile
01net beschreibt Minions als ein System mit vier Hauptkomponenten. In dieser Darstellung nimmt ein zentraler Minion Server Anfragen von Teams entgegen und zerlegt sie in Teilaufgaben. Deren Zustand werde demnach in einer PostgreSQL-Datenbank nachverfolgt. Jeder eingebundene Mac führe dann einen Minion Executor aus, der den zugewiesenen Anteil auf der lokalen GPU verarbeitet, Ergebnisse in einen S3-Speicher hochlädt und den Status an den Server zurückmeldet. Ein separater Minion Watchdog überwache den gesamten Verbund und weise Arbeit neu zu, wenn eine Maschine nicht mehr antworte. Dashboards sollen zudem in Echtzeit Einblick in den Zustand des Systems geben.
- Ein zentraler Minion Server, der Jobs entgegennimmt und in Teilaufgaben zerlegt
- Eine PostgreSQL-Datenbank, die laut 01net zur Nachverfolgung des Aufgabenstatus dient
- Ein Minion Executor auf jedem eingebundenen Mac, der GPU-Arbeit lokal ausführt
- Ein Minion Watchdog, der Ausfälle erkennt und unterbrochene Aufgaben neu verteilt
Falls diese Beschreibung zutrifft, deutet die Architektur darauf hin, dass Apple für einen stark heterogenen und instabilen Gerätepool ein recht klassisches Control-Plane-Muster gewählt hat. Büro-Macs sind keine dedizierten Server: Sie können die Verbindung verlieren, in den Ruhezustand wechseln, von Mitarbeitenden wieder in Beschlag genommen werden oder ohne Vorwarnung nicht mehr verfügbar sein. In diesem Kontext sind Aufgabenzerlegung, persistente Zustandsverfolgung und ein Watchdog-Prozess keine optionalen Zusätze, sondern zentrale Anforderungen. Die Architektur legt außerdem nahe, dass Minions zunächst auf verteilte Verfügbarkeit und den Umgang mit Fehlern optimiert ist, bevor es auf maximalen Rohdurchsatz optimiert wird.
Worauf Minions offenbar optimiert ist
Beide Quellen weisen strategisch in dieselbe Richtung. Minions wird nicht als Versuch dargestellt, mit zentralisierten GPU-Clustern im Nvidia-Stil für die größten Frontier-Modelle zu konkurrieren. Stattdessen liegt der Schwerpunkt darauf, bereits auf Schreibtischen vorhandene, unterausgelastete Ressourcen nutzbar zu machen und sie für Inferenzaufgaben innerhalb des Unternehmens bereitzustellen. 01net sagt ausdrücklich, das Ziel sei Verfügbarkeit statt roher Leistung, und das System solle vorhandene Kapazität im internen Netzwerk an Teams umverteilen, denen diese Kapazität fehlt.
Diese Einordnung passt zu der knappen, aber klaren Formulierung in Apples eigener Zusammenfassung. Das Unternehmen betont die Möglichkeit, vorhandene Hardware ohne zusätzliche GPU-Beschaffung zu nutzen, und verankert das System wiederholt in Umgebungen, in denen zentrale GPU-Ressourcen eingeschränkt sind. Anders gesagt: Das Nutzenversprechen besteht weniger darin, einen eigens dafür gebauten Rechenzentrums-Cluster bei der Leistung zu übertreffen, sondern eher darin, die Verschwendung ungenutzter Hardware zu verringern und den Zugang zu Rechenkapazität für interne Nutzerinnen und Nutzer zu glätten.
Die Grenzen gehören zur Geschichte dazu
Dieselben Quellen machen auch deutlich, dass diese Architektur mit spürbaren Einschränkungen einhergeht. Erstens wird Minions im Zusammenhang mit Inferenz-Workloads diskutiert, nicht mit vollumfänglichem Training. Zweitens hängt es von ungenutzten macOS-Geräten mit Apple Silicon ab, was bedeutet, dass das Angebot mit dem Verhalten der Mitarbeitenden und der Gerätenutzung schwankt. Ein verteilter Pool, der aus Rechnern von Nutzerinnen und Nutzern aufgebaut ist, ist seinem Wesen nach dynamisch: Knoten können verschwinden, die Leistung kann sich zwischen verschiedenen Mac-Modellen unterscheiden, und das System muss Ausfälle als normalen Betriebszustand verkraften.
Drittens dürften Speicher- und Orchestrierungs-Overheads eine zentrale Rolle im Design spielen. Der berichtete Einsatz eines zentralen Servers, einer Datenbank und eines S3-ähnlichen Ergebnisspeichers deutet darauf hin, dass Job-Koordination und Datenbewegung wesentliche Gesichtspunkte sind. Verteilte Inferenz kann von vielen GPUs profitieren, aber nicht jedes Modell und nicht jede Aufgabe lässt sich sauber aufteilen. Das hilft zu erklären, warum Apples Zusammenfassung Fehlertoleranz und Flexibilität bei der Planung hervorhebt, während Aussagen über extreme Leistung ausbleiben.
01net berichtet außerdem, dass sich aktuelle Mac mini- und Mac Studio-Systeme über RDMA via Thunderbolt 5 koppeln ließen, wodurch Speicher und Rechenleistung kombiniert würden, um ein Modell zu laden, das für eine einzelne Maschine zu groß ist. Das ist ein auffälliges Detail, erscheint in den hier vorliegenden Quellen aber nur im 01net-Artikel und nicht in der kurzen Apple-Zusammenfassung oben. Es sollte daher als berichtete Fähigkeit gelesen werden und nicht als Punkt, der durch beide Quellen belegt ist. Falls dies wie beschrieben umgesetzt wurde, würde es einen der offensichtlichsten Engpässe bei Inferenz auf Macs mit nur einem Gerät adressieren: die Modellgröße im Verhältnis zu den Grenzen des lokalen Speichers.
Was Apple sagt — und was nicht
Apples eigene Forschungszusammenfassung fällt durch ihre Zurückhaltung auf. Sie sagt, Minions könne ungenutzte Macs in eine praktikable verteilte GPU-Inferenzplattform verwandeln und das System biete flexible Aufgabenausführung, Fehlertoleranz und effiziente Ressourcennutzung. Sie behauptet in dem hier verfügbaren Quelltext nicht, dass dieser Ansatz zentrale Cluster ersetzt, dass er große Modelle allgemein unterstützt oder dass er für jede KI-Arbeitslast geeignet ist. Gerade diese Auslassungen sind aufschlussreich. Sie legen nahe, dass Minions eine gezielte interne Antwort auf einen spezifischen Engpass ist: knapper gemeinsamer GPU-Zugang für Inferenzaufgaben, die sich über einen flüchtigen Pool von Apple-Silicon-Geräten verteilen lassen.
Für deutschsprachige Unternehmen lautet die konkrete Schlussfolgerung nicht, dass Büro-Laptops und -Desktops Rechenzentrums-GPUs einfach ersetzen könnten. Vielmehr zeigt sich, dass dort, wo zentrale Inferenzkapazität begrenzt ist, ein sorgfältig verwalteter Pool ungenutzter Macs von Mitarbeitenden eine ergänzende interne Ebene für geeignete Workloads bieten kann — vorausgesetzt, das Unternehmen kann Orchestrierung, Ausfälle, ungleichmäßige Geräteverfügbarkeit und den engeren Anwendungsbereich bewältigen, der bei auf Inferenz ausgerichteten Jobs statt bei den größten Trainings-Workloads impliziert ist.
Quellen
- Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon DevicesApple Machine Learning Research · 1. Oktober 2026
- À court de cartes graphiques, Apple réquisitionne les Mac de ses employés01net · 15. Oktober 2026