Apple affirme exécuter de l’inférence IA distribuée à partir des Mac inactifs de ses employés
Apple indique avoir mis en place en interne un cloud GPU distribué à partir de Mac Apple Silicon sous macOS laissés inactifs. Le dispositif présenté vise l’inférence en IA lorsque la capacité GPU centralisée est sous tension, avec des limites clairement assumées.
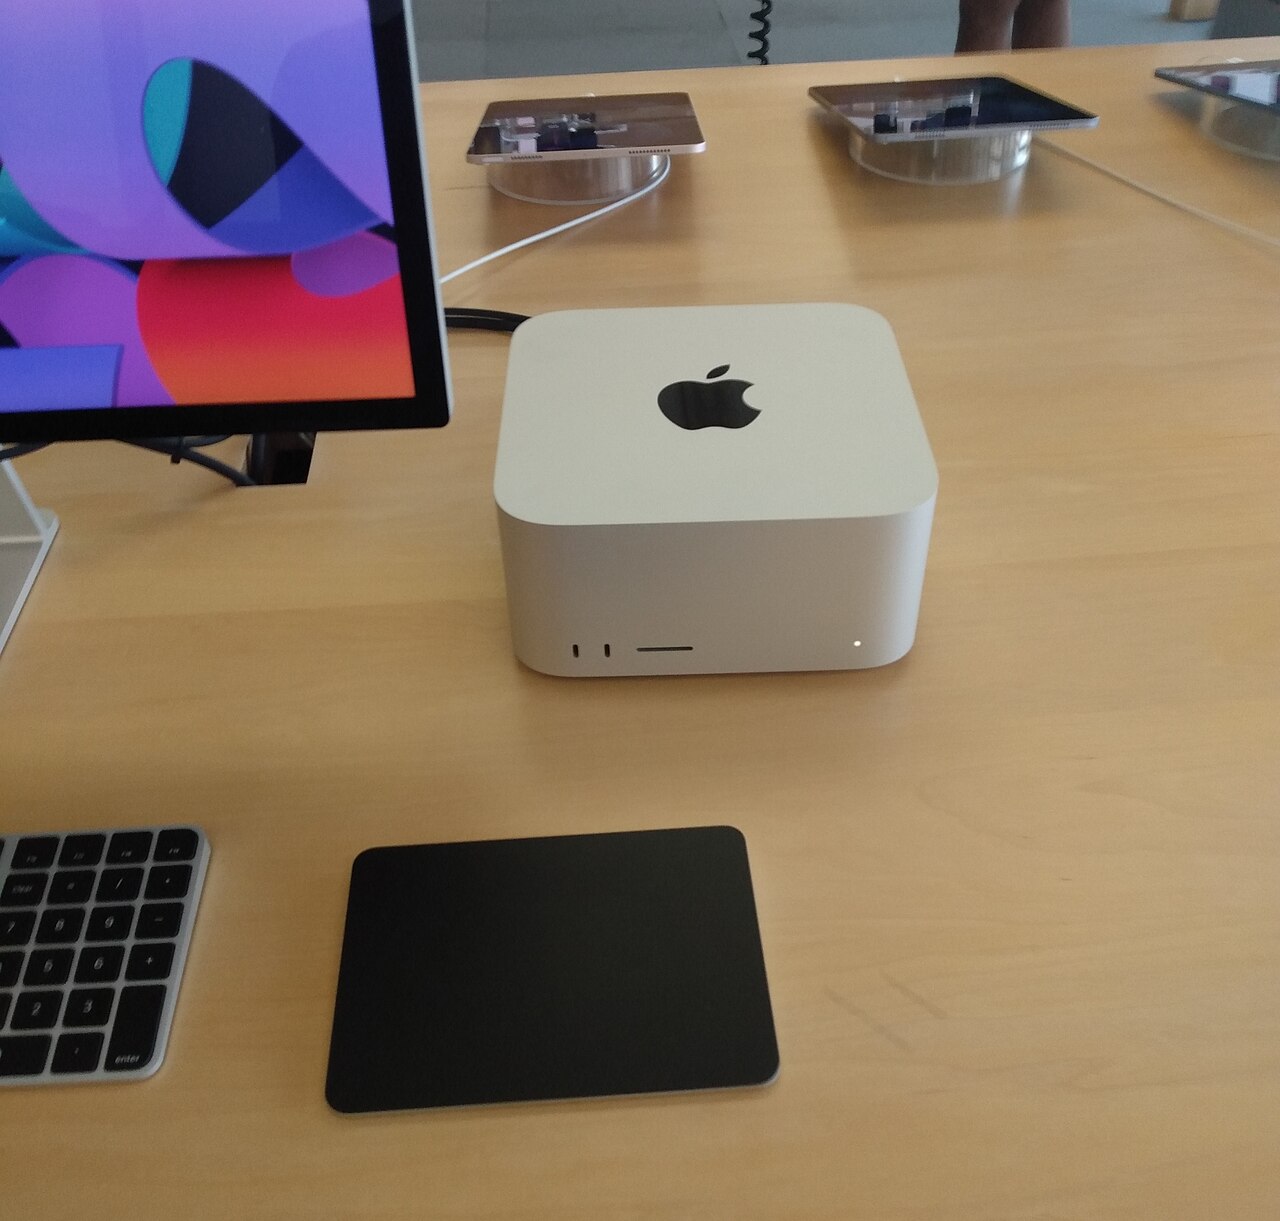
Apple a décrit un système interne baptisé Minions, qui mutualise les GPU inutilisés d’appareils macOS équipés d’Apple Silicon pour les transformer en ressource de calcul distribuée destinée à l’inférence en apprentissage automatique. Dans un résumé de recherche publié par Apple Machine Learning Research, l’entreprise présente Minions comme « un cloud virtuel de GPU dynamique et distribué » qui agrège les GPU inactifs de plusieurs Mac afin d’exécuter des charges d’inférence à grande échelle. L’objectif affiché est très concret : exploiter du matériel déjà présent dans l’entreprise plutôt que d’acheter des GPU supplémentaires lorsque la capacité centralisée vient à manquer.
Le résumé de l’article reste prudent quant à sa portée. Il présente le problème comme celui d’une demande croissante pour l’inférence accélérée par GPU, en parallèle des limites de l’infrastructure GPU centralisée, notamment son coût, son élasticité restreinte et les longues files d’attente lorsque les ressources se raréfient. Les chercheurs d’Apple soutiennent que les Mac modernes dotés d’Apple Silicon embarquent déjà des GPU puissants, souvent largement sous-utilisés dans le cadre d’un usage normal. Leur thèse est que ces ressources dormantes peuvent être organisées pour former une plateforme d’inférence utile à des équipes qui ont besoin de puissance de calcul, mais qui ne peuvent pas toujours obtenir un accès rapide à un cluster central.
Un cloud virtuel de GPU construit à partir des Mac du bureau
D’après la page de recherche d’Apple, Minions est conçu pour l’inférence, et non pour l’entraînement généraliste de modèles d’IA. Cette distinction est importante. Les charges d’inférence peuvent souvent être découpées et planifiées avec davantage de souplesse que l’entraînement de modèles à très grande échelle, et Apple affirme que le système propose une exécution flexible des tâches d’inférence sur GPU, une tolérance aux pannes et une utilisation efficace des ressources. Le résumé de l’entreprise ne fournit pas, dans le texte source repris ici, de tableaux de benchmarks détaillés, mais il affirme que son expérience montre que des appareils macOS inactifs peuvent devenir une plateforme pratique d’inférence GPU distribuée lorsque les ressources GPU centralisées sont contraintes.
Un autre article, publié par le média français 01net, ajoute des détails d’architecture et des affirmations opérationnelles qui ne figurent pas explicitement dans le court résumé d’Apple. Comme ces précisions proviennent d’une source secondaire, il convient de les considérer comme des éléments rapportés, et non comme des détails confirmés ici de manière indépendante à partir du seul résumé d’Apple. Selon 01net, certaines tâches internes d’IA devaient auparavant attendre des heures dans une file faute de GPU centralisés disponibles, et Minions aurait ramené le temps de démarrage de nombre de ces tâches à quelques minutes. Il s’agit d’une affirmation notable, mais qui demeure une affirmation rapportée tant qu’elle n’est pas vérifiée directement dans l’article scientifique sous-jacent.
Architecture rapportée : quatre éléments en mouvement
01net décrit Minions comme reposant sur quatre composants principaux. Dans ce récit, un Minion Server central reçoit les demandes des équipes et les découpe en sous-tâches. Leur état serait suivi dans une base de données PostgreSQL. Chaque Mac inscrit au système exécuterait ensuite un Minion Executor, chargé de traiter localement sur le GPU la portion qui lui a été attribuée, de téléverser les résultats vers un stockage S3 et de renvoyer son état au serveur. Un Minion Watchdog distinct superviserait l’ensemble de la flotte et réattribuerait le travail si une machine cessait de répondre. Des tableaux de bord offriraient par ailleurs une visibilité en temps réel sur l’état du système.
- Un Minion Server central qui accepte les tâches et les découpe en sous-tâches
- Une base de données PostgreSQL utilisée pour suivre l’état des tâches, selon 01net
- Un Minion Executor sur chaque Mac inscrit, chargé d’exécuter localement le travail GPU
- Un Minion Watchdog qui détecte les défaillances et réalloue les tâches interrompues
Si cette description est exacte, cette architecture laisse penser qu’Apple a retenu un schéma de plan de contrôle assez classique pour piloter un parc d’appareils très hétérogène et instable. Les Mac de bureau ne sont pas des serveurs dédiés : ils peuvent se déconnecter, se mettre en veille, être repris par leurs utilisateurs ou devenir indisponibles sans avertissement. Dans ce contexte, le découpage des tâches, le suivi persistant de leur état et l’existence d’un processus de supervision ne sont pas des raffinements accessoires, mais des exigences fondamentales. Cette architecture implique aussi que Minions est optimisé d’abord pour la disponibilité distribuée et la gestion des pannes, avant de l’être pour le débit brut maximal.
Ce que Minions semble chercher à optimiser
Les deux sources vont dans le même sens sur la stratégie générale. Minions n’est pas présenté comme une tentative de rivaliser avec des clusters GPU centralisés de type Nvidia pour les plus grands modèles de pointe. L’accent est plutôt mis sur la récupération de ressources sous-exploitées déjà présentes sur les bureaux, puis sur leur mise à disposition pour des tâches d’inférence au sein de l’entreprise. 01net indique explicitement que l’objectif est la disponibilité plutôt que la puissance brute, et que le système est conçu pour redistribuer à des équipes qui en manquent une capacité déjà présente sur le réseau interne.
Ce positionnement correspond à la formulation limitée mais claire employée par Apple dans son propre résumé. L’entreprise insiste sur la capacité à exploiter du matériel existant sans achat additionnel de GPU et replace à plusieurs reprises le système dans des environnements où les ressources GPU centralisées sont contraintes. Autrement dit, la proposition de valeur consiste moins à surpasser en performances un cluster de centre de données conçu à cet effet qu’à réduire le gaspillage de matériel inactif tout en fluidifiant l’accès aux ressources de calcul pour les utilisateurs internes.
Les contraintes font partie intégrante du sujet
Les mêmes sources indiquent aussi clairement que cette architecture s’accompagne de contraintes importantes. D’abord, Minions est évoqué dans le cadre de charges d’inférence, et non d’un entraînement à grande échelle. Ensuite, le système dépend d’appareils macOS Apple Silicon laissés inactifs, ce qui signifie que l’offre de capacité varie selon le comportement des employés et l’usage de leurs machines. Un pool distribué construit à partir de postes utilisateurs est, par nature, dynamique : des nœuds peuvent disparaître, les performances peuvent varier d’un modèle de Mac à l’autre, et le système doit tolérer les défaillances comme une condition de fonctionnement normale.
Troisièmement, les surcoûts liés au stockage et à l’orchestration sont probablement au cœur de la conception. L’usage rapporté d’un serveur central, d’une base de données et d’un stockage de résultats de type S3 montre que la coordination des tâches et les mouvements de données constituent des paramètres importants. L’inférence distribuée peut tirer parti de nombreux GPU, mais tous les modèles ni toutes les tâches ne se prêtent aisément au découpage. Cela aide à comprendre pourquoi la tolérance aux pannes et la souplesse de planification sont mises en avant dans le résumé d’Apple, alors que des affirmations de performances extrêmes ne le sont pas.
01net rapporte également que de récents Mac mini et Mac Studio peuvent être associés via du RDMA sur Thunderbolt 5, afin de combiner mémoire et calcul pour charger un modèle trop volumineux pour une seule machine. Il s’agit d’un détail marquant, mais, dans les sources fournies ici, il n’apparaît que dans l’article de 01net, et non dans le court résumé d’Apple cité plus haut. Il faut donc le lire comme une capacité rapportée, et non comme un point établi par les deux sources. Si cette mise en œuvre correspond bien à ce qui est décrit, elle répondrait à l’un des goulots d’étranglement les plus évidents de l’inférence sur Mac à partir d’un seul appareil : la taille du modèle face aux limites de mémoire locale.
Ce qu’Apple dit — et ce qu’Apple ne dit pas
Le résumé de recherche d’Apple se distingue par sa retenue. Il affirme que Minions peut transformer des Mac inactifs en une plateforme pratique d’inférence GPU distribuée, et que le système fournit une exécution flexible des tâches, une tolérance aux pannes et une utilisation efficace des ressources. En revanche, il ne dit pas, dans le texte source disponible ici, que cette approche remplace les clusters centralisés, qu’elle prend largement en charge des modèles géants, ni qu’elle convient à toutes les charges de travail en IA. Ces absences sont instructives. Elles suggèrent que Minions constitue une réponse interne ciblée à un goulot d’étranglement précis : la rareté d’un accès partagé à des GPU pour des tâches d’inférence pouvant être réparties sur un ensemble volatil d’appareils Apple Silicon.
Pour les entreprises francophones, l’enseignement concret n’est pas que les ordinateurs portables et de bureau du bureau peuvent simplement remplacer les GPU de centre de données. Il est plutôt que, lorsque la capacité centralisée dédiée à l’inférence est limitée, un ensemble soigneusement administré de Mac inactifs appartenant aux employés peut offrir une couche interne complémentaire pour des charges adaptées — à condition de savoir gérer l’orchestration, les pannes, la disponibilité inégale des appareils et le périmètre plus étroit qu’impliquent des tâches orientées inférence plutôt que les plus lourdes charges d’entraînement.
Sources
- Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon DevicesApple Machine Learning Research · 1 octobre 2026
- À court de cartes graphiques, Apple réquisitionne les Mac de ses employés01net · 15 octobre 2026