苹果称可利用员工闲置 Mac 构建分布式 AI 推理 GPU 资源池
苹果表示,其已在公司内部利用闲置的 Apple Silicon Mac 搭建出一个分布式 GPU 云,用于在集中式 GPU 容量紧张时承接 AI 推理任务。不过,从现有表述来看,这一设计的目标和边界都相当明确。
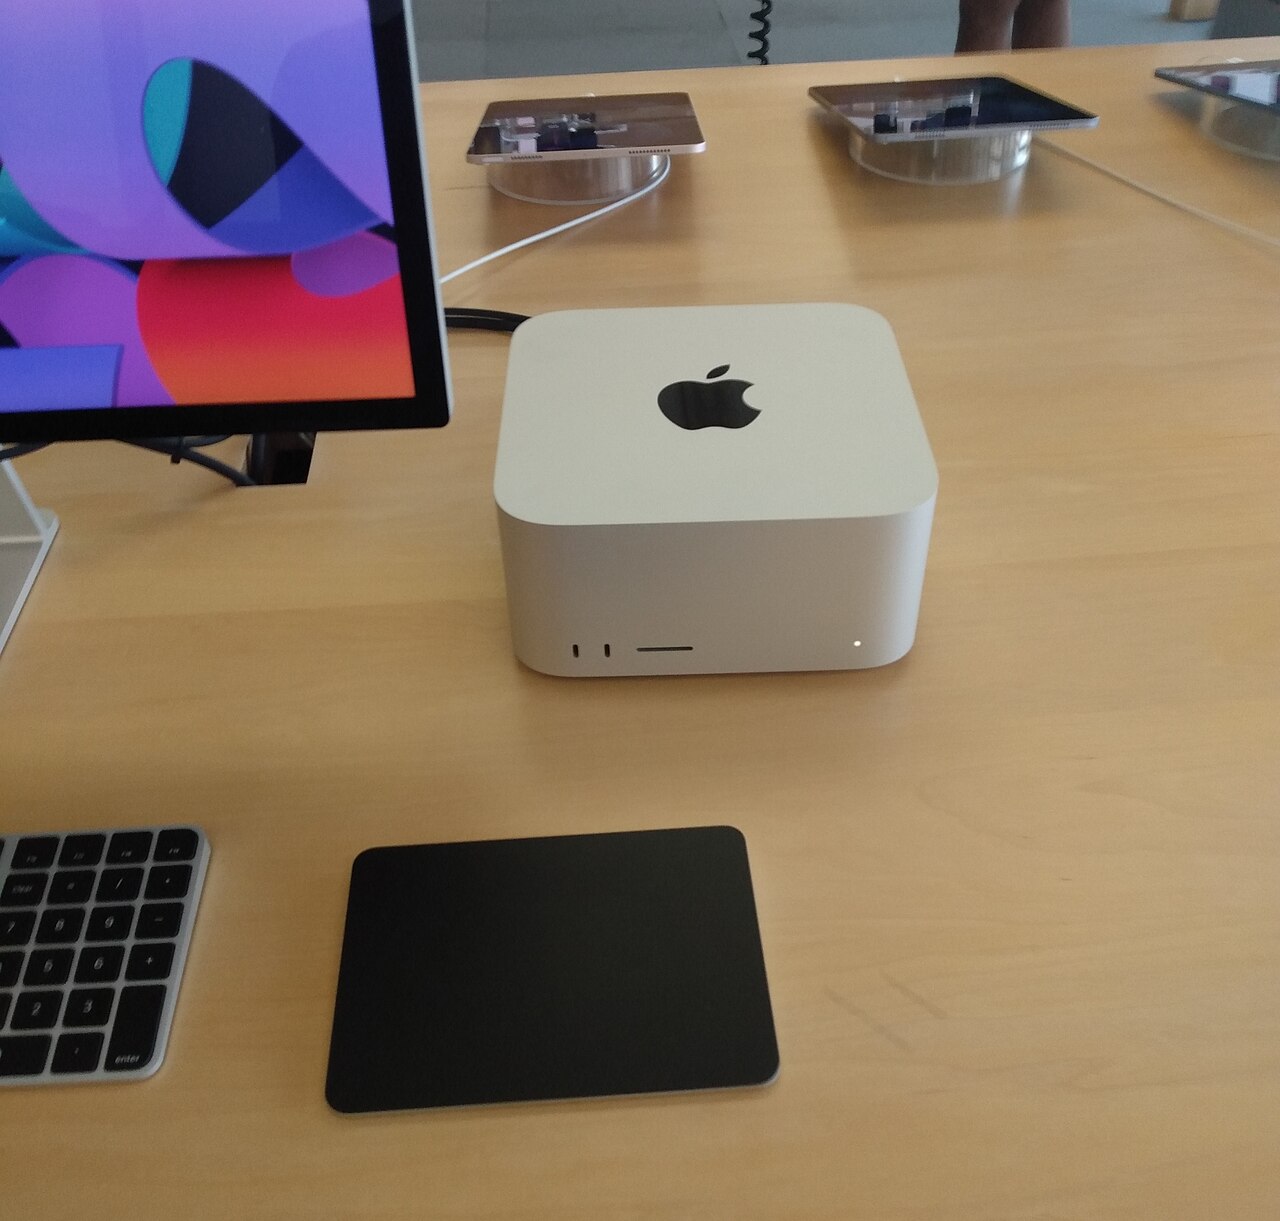
苹果介绍了一套名为 Minions 的内部系统:它会汇聚搭载 Apple Silicon 的 macOS 设备上未被使用的 GPU 资源,并将其转化为可供机器学习推理使用的分布式计算能力。根据 Apple Machine Learning Research 发布的一份研究摘要,苹果将 Minions 描述为一种“动态的、分布式的虚拟 GPU 云”,其核心思路是把多台 Mac 上处于空闲状态的 GPU 聚合起来,执行大规模推理工作负载。苹果给出的目标相当务实:当集中式 GPU 资源吃紧时,优先利用公司内部已经存在的硬件,而不是额外采购更多 GPU。
这份论文摘要在范围界定上相当克制。它将问题表述为:一方面,依赖 GPU 加速的推理需求持续增长;另一方面,集中式 GPU 基础设施又存在明显限制,包括成本高、弹性有限,以及在资源稀缺时需要长时间排队等待。苹果研究人员认为,现代 Apple Silicon Mac 本身已经配备了性能不弱的 GPU,但在日常办公使用中,这些 GPU 往往大部分时间处于闲置状态。他们的观点是,如果把这些沉睡资源组织起来,就能为那些需要算力、却又无法稳定及时获得中心集群资源的团队,提供一个有实际价值的推理平台。
由办公室 Mac 组成的虚拟 GPU 云
按照苹果研究页面的说法,Minions 的设计目标是推理,而不是通用型的 AI 训练。这个区别非常关键。与大规模模型训练相比,推理任务通常更容易被拆分,也更适合做灵活调度。苹果称,该系统能够提供灵活的 GPU 推理任务执行、容错能力以及高效的资源利用率。就这里提供的原始材料而言,苹果的摘要并没有给出详细的基准测试表格,但它确实表示,公司的实践经验显示,在集中式 GPU 资源受限的环境中,闲置的 macOS 设备可以成为一个切实可行的分布式 GPU 推理平台。
法国媒体 01net 的另一篇报道补充了一些架构与运行层面的细节,以及若干操作效果上的说法,而这些内容并未在苹果的简短摘要中被明确展开。由于这些细节来自二手报道,因此更合适的表述应是“据报道”,而不能视为已由苹果摘要本身在此得到独立确认。01net 称,此前某些内部 AI 任务会因集中式 GPU 不可用而在队列中等待数小时,而 Minions 将其中许多任务的启动时间缩短到了几分钟。这是一个颇为显著的说法,但在没有直接核对底层论文的前提下,它仍应被视为报道中的主张。
据称的架构:四个关键组成部分
01net 将 Minions 描述为由四个主要组件构成。按照该报道的说法,位于中心位置的 Minion Server 负责接收来自各团队的请求,并把任务拆分成多个子任务;这些子任务的状态据称会被记录在 PostgreSQL 数据库中。随后,每台加入资源池的 Mac 都会运行一个 Minion Executor,在本地 GPU 上处理分配到的那部分工作,将结果上传到 S3 存储,并把状态回报给服务器。另有一个独立的 Minion Watchdog 用于监管整个平台中的设备,如果某台机器停止响应,就会重新分配相关工作。报道还称,系统配有仪表盘,可实时展示整体运行状态。
- 一个中心化的 Minion Server,负责接收任务并将其拆分为子任务
- 据 01net 报道,一个用于跟踪任务状态的 PostgreSQL 数据库
- 部署在每台已加入 Mac 上的 Minion Executor,在本地执行 GPU 工作负载
- 一个 Minion Watchdog,用于检测故障并重新分配被中断的任务
如果这一描述准确,那么它表明苹果针对一个高度异构、且稳定性天然不足的设备池,采用了相当经典的控制平面模式。办公室里的 Mac 不是专用服务器:它们可能断开连接,可能进入睡眠状态,可能被员工随时重新占用,也可能在没有预警的情况下临时不可用。在这种背景下,任务拆分、持久化状态跟踪以及 watchdog 监控进程,并不是锦上添花的附加项,而是系统能正常运作的基础条件。这一架构也意味着,Minions 的优化方向,很可能首先是提升分布式可用性和故障处理能力,其次才是追求绝对的原始吞吐量。
Minions 看起来究竟在优化什么
从策略层面看,两处来源都指向了同一个方向。Minions 并不是被当作一种用来挑战集中式、类似 Nvidia 风格 GPU 集群的大模型基础设施。相反,重点在于把那些已经摆在员工桌面上、但尚未被充分使用的资源回收起来,重新提供给公司内部的推理任务。01net 甚至明确表示,系统追求的目标是可用性,而不是纯粹的蛮力;它旨在把公司内部网络中已经存在、却分散在各处的容量重新分配给缺乏算力的团队。
这种定位与苹果自家摘要中有限但清晰的措辞是吻合的。苹果强调的是:在不额外采购 GPU 的前提下,利用既有硬件;并且多次把这一系统放在“集中式 GPU 资源受限”的场景中来讨论。换句话说,它的价值主张并不是在性能上击败专门建设的数据中心集群,而是减少闲置硬件浪费,同时让内部用户获得更平滑、更及时的算力访问体验。
这些限制本身也是故事的一部分
同样,这些来源也明确表明,这一架构伴随着不可忽视的约束。首先,Minions 被讨论的语境始终是推理工作负载,而不是完整的大规模训练。其次,它依赖的是处于空闲状态的 Apple Silicon macOS 设备,这就意味着供给会随着员工行为和设备使用情况而波动。由用户机器构成的分布式资源池,天然是动态变化的:节点可能随时消失,不同型号 Mac 的性能表现可能并不一致,系统也必须把故障视为一种常态化运行条件来加以容忍。
第三,存储与编排开销很可能是这套设计中的核心因素。报道中提到的中心服务器、数据库以及类 S3 的结果存储,都说明任务协调与数据移动在其中占据重要位置。分布式推理确实可能从大量 GPU 中获益,但并不是每一种模型或每一个任务都能被干净利落地拆分。这也有助于解释,为什么苹果在摘要中强调的是容错能力和调度灵活性,而不是极限性能表现。
01net 还报道称,较新的 Mac mini 与 Mac Studio 系统可以通过基于 Thunderbolt 5 的 RDMA 方式关联在一起,从而合并内存与算力,加载一台机器单独无法容纳的大模型。这是一个相当引人注目的细节,但在这里提供的来源中,它只出现在 01net 的文章里,并未出现在上文所引的苹果简短摘要中。因此,更稳妥的理解方式,是把它视为“据报道具备的能力”,而不是两处来源共同确认的结论。如果这一实现方式确如报道所述,那么它将直接对应 Mac 单机推理里最显而易见的瓶颈之一:模型规模与本地内存上限之间的矛盾。
苹果说了什么,又没有说什么
苹果自己的研究摘要之所以值得注意,恰恰在于它的克制。它表示,Minions 能把闲置的 Mac 转化为一个实用的分布式 GPU 推理平台,并称系统具备灵活的任务执行、容错能力和高效的资源利用率。但在这里可见的原始文字中,苹果并没有声称这种方法可以取代集中式集群,也没有表示它能够广泛支持超大模型,更没有说它适用于所有 AI 工作负载。这些没有说出口的部分,同样具有信息量。它们暗示,Minions 更像是苹果为某个具体瓶颈准备的定向内部方案:当共享 GPU 资源稀缺时,为那些能够被分散到一组不稳定 Apple Silicon 设备上的推理任务提供补充性算力。
对于企业读者而言,更实际的启示并不是“办公室里的笔记本和台式机可以直接替代数据中心 GPU”。真正的结论是:如果集中式推理容量有限,那么在合适的工作负载条件下,经过精心管理的员工闲置 Mac 资源池,或许能够成为一种补充性的内部算力层。当然,前提是公司本身能够处理编排复杂度、节点故障、设备可用性不均,以及推理型任务所隐含的较窄适用范围,而不是把它误解为适合最大规模训练任务的通用解法。
信息来源
- Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon DevicesApple Machine Learning Research · 2026年10月1日
- À court de cartes graphiques, Apple réquisitionne les Mac de ses employés01net · 2026年10月15日