Apple, 직원들이 사용하지 않는 Mac을 묶어 분산형 AI 추론을 수행한다고 밝혀
Apple은 사용하지 않는 Apple Silicon Mac의 GPU를 모아 사내용 분산 GPU 클라우드를 구축했다고 설명했다. 공개된 설계는 중앙집중형 GPU 용량이 부족할 때 AI 추론을 보완하는 데 초점을 맞추며, 적용 범위와 한계도 분명히 제시한다.
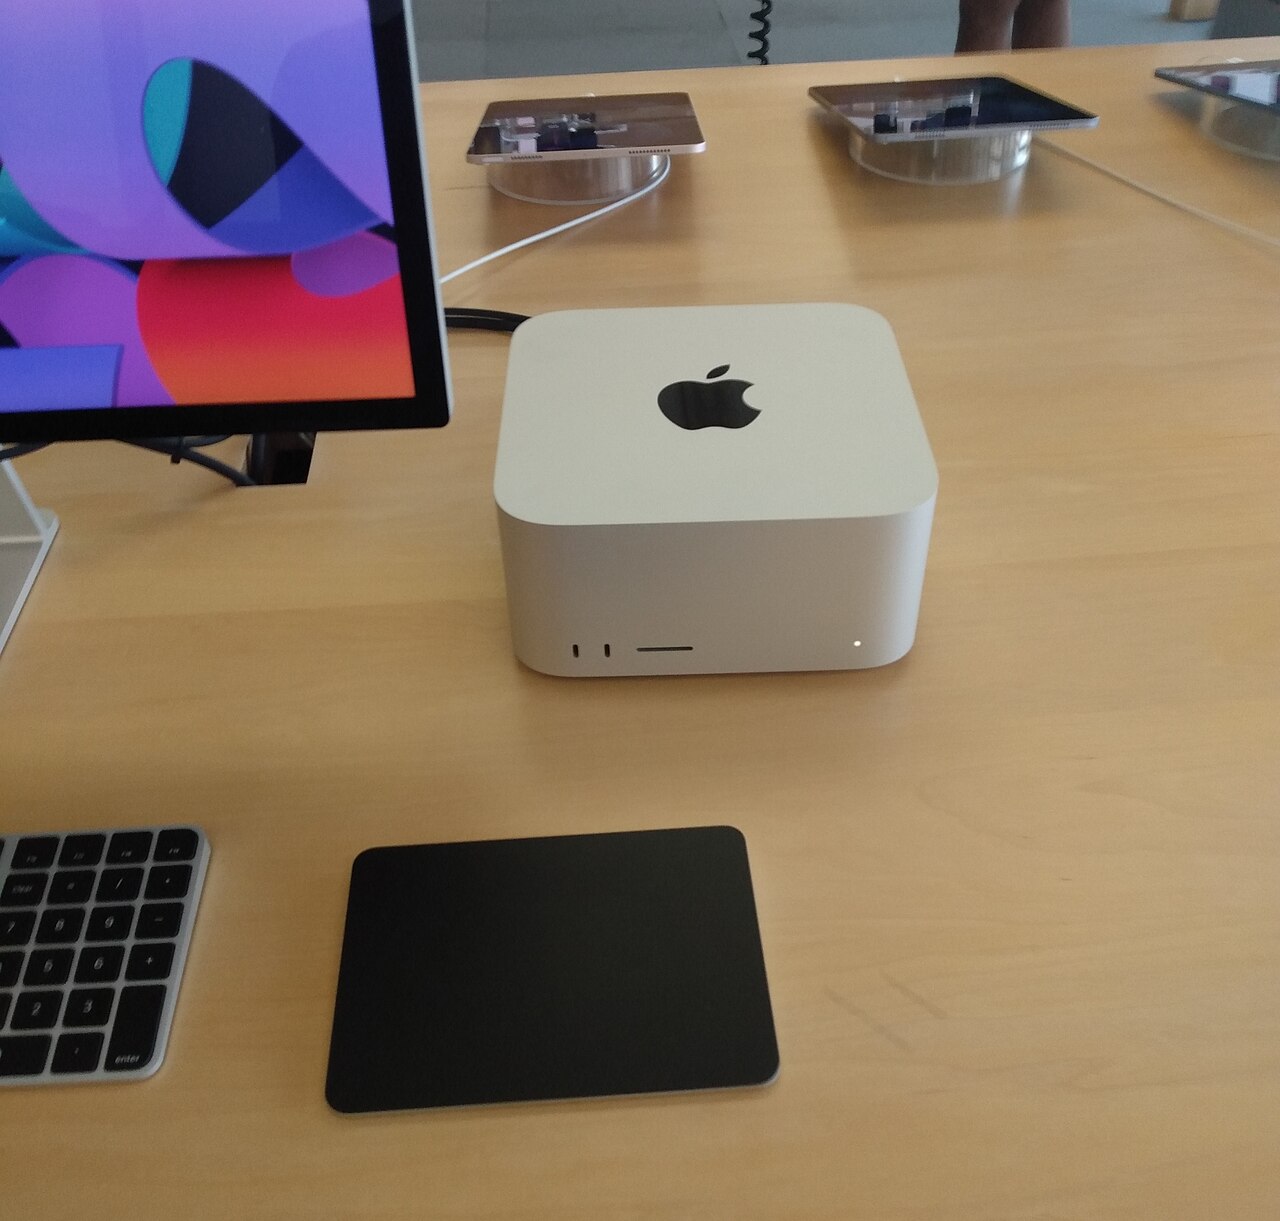
Apple은 Minions라는 사내 시스템을 소개하며, Apple Silicon 기반 macOS 기기에서 놀고 있는 GPU 자원을 모아 기계 학습 추론을 위한 분산 컴퓨팅 자원으로 전환한다고 설명했다. Apple Machine Learning Research에 게시된 연구 요약에서 회사는 Minions를 “동적이고 분산된 가상 GPU 클라우드”로 제시하며, 여러 Mac에 흩어져 있는 유휴 GPU를 집계해 대규모 추론 워크로드를 실행한다고 밝혔다. 회사가 내세우는 목표는 매우 실용적이다. 중앙집중형 GPU 여력이 빠듯할 때 추가 GPU를 새로 조달하기보다, 회사 내부에 이미 존재하는 하드웨어를 활용하겠다는 것이다.
논문 요약은 범위를 신중하게 한정한다. 문제를 GPU 가속 추론 수요의 증가와, 이에 대비되는 중앙집중형 GPU 인프라의 한계로 규정한다. 여기에는 비용, 제한된 탄력성, 자원이 부족할 때 길어지는 대기 시간이 포함된다. Apple 연구진은 최신 Apple Silicon Mac이 이미 강력한 GPU를 탑재하고 있지만, 일반적인 업무 환경에서는 그 성능이 상당 부분 놀고 있는 경우가 많다고 본다. 이들의 주장은 이러한 잠재 자원을 조직화하면, 연산이 필요하지만 중앙 클러스터에 제때 접근하지 못하는 팀을 위해 유용한 추론 플랫폼으로 바꿀 수 있다는 것이다.
사무실의 Mac으로 만든 가상 GPU 클라우드
Apple의 연구 페이지에 따르면 Minions는 범용 AI 학습이 아니라 추론을 위해 설계됐다. 이 구분은 중요하다. 추론 워크로드는 대규모 모델 학습보다 더 유연하게 나누고 스케줄링할 수 있는 경우가 많으며, Apple은 이 시스템이 유연한 GPU 추론 작업 실행, 장애 허용성, 효율적인 자원 활용을 제공한다고 말한다. 여기 제공된 원문에는 자세한 벤치마크 표가 포함되어 있지 않지만, 회사는 자사의 경험상 유휴 상태의 macOS 기기들이 중앙집중형 GPU 자원이 제약되는 환경에서 실용적인 분산 GPU 추론 플랫폼이 될 수 있다고 설명한다.
프랑스 매체 01net의 별도 보도는 Apple의 짧은 요약문에는 구체적으로 적시되지 않은 아키텍처 세부 사항과 운영상 주장들을 덧붙인다. 다만 이 내용은 2차 보도에서 나온 것이므로, 여기서는 Apple 요약문 자체로부터 독립적으로 확인된 사실이라기보다 보도된 설명으로 받아들이는 것이 타당하다. 01net에 따르면 일부 사내 AI 작업은 중앙 GPU를 사용할 수 없어 이전에는 수 시간 동안 대기열에 머물렀고, Minions는 이런 작업 다수의 시작 시간을 몇 분 수준으로 줄였다고 한다. 눈길을 끄는 주장인 것은 분명하지만, 기저 논문을 직접 확인하기 전까지는 어디까지나 해당 보도의 주장으로 남는다.
전해진 아키텍처: 네 가지 핵심 구성 요소
01net은 Minions가 네 가지 주요 구성 요소를 중심으로 동작한다고 설명한다. 그 보도에 따르면 중앙의 Minion Server가 각 팀의 요청을 받아 이를 여러 하위 작업으로 분할한다. 그리고 각 작업의 상태는 PostgreSQL 데이터베이스에서 추적된다고 전해진다. 등록된 각 Mac은 Minion Executor를 실행해 자신에게 할당된 부분을 로컬 GPU에서 처리하고, 결과를 S3 스토리지에 업로드한 뒤 상태를 다시 서버에 보고한다. 별도의 Minion Watchdog는 전체 장치 집합을 감시하며, 어떤 기기가 응답을 멈추면 작업을 재할당한다고 한다. 또한 대시보드는 시스템 상태를 실시간으로 보여준다고 전해진다.
- 작업을 받아 하위 작업으로 나누는 중앙 Minion Server
- 01net 보도에 따르면 작업 상태를 추적하는 데 사용되는 PostgreSQL 데이터베이스
- 등록된 각 Mac에서 로컬로 GPU 작업을 수행하는 Minion Executor
- 장애를 감지하고 중단된 작업을 다시 배분하는 Minion Watchdog
이 설명이 정확하다면, Apple은 매우 이질적이고 안정적이지 않은 장치 풀을 다루기 위해 비교적 전형적인 제어 평면 패턴을 택한 셈이 된다. 사무실의 Mac은 전용 서버가 아니다. 네트워크에서 분리될 수 있고, 절전 상태로 들어갈 수 있으며, 직원이 다시 사용하기 위해 가져갈 수도 있고, 예고 없이 사용할 수 없게 될 수도 있다. 이런 맥락에서 작업 분할, 영속적인 상태 추적, 감시 프로세스는 있으면 좋은 부가 기능이 아니라 필수 요건에 가깝다. 이 아키텍처는 또한 Minions가 최대의 순수 처리량을 끌어내는 것보다, 분산된 가용성과 장애 처리에 먼저 최적화되어 있음을 시사한다.
Minions가 최적화하는 것으로 보이는 지점
두 출처는 전략 측면에서 같은 방향을 가리킨다. Minions는 최전선의 초대형 모델을 위해 중앙집중형 Nvidia 스타일 GPU 클러스터와 경쟁하려는 시도로 제시되지 않는다. 대신 초점은 이미 책상 위에 놓여 있지만 충분히 활용되지 않는 자원을 회수해, 회사 내부의 추론 작업에 사용할 수 있도록 만드는 데 있다. 01net은 목표가 절대적인 연산 능력이 아니라 가용성이라고 명시적으로 설명하며, 이 시스템이 내부 네트워크에 이미 존재하는 용량을 그것이 부족한 팀에 재분배하기 위한 것이라고 전한다.
이런 위치 설정은 Apple 자체 요약문의 제한적이지만 분명한 표현과도 들어맞는다. 회사는 추가 GPU 조달 없이 기존 하드웨어를 활용할 수 있다는 점을 강조하고, 중앙집중형 GPU 자원이 제약되는 환경이라는 맥락을 반복해서 제시한다. 다시 말해, 이 시스템의 가치 제안은 성능 면에서 목적에 맞게 설계된 데이터센터 클러스터를 능가하는 데 있다기보다, 놀고 있는 하드웨어를 낭비하지 않도록 하고 내부 사용자들이 연산 자원에 더 원활하게 접근할 수 있게 한다는 데 더 가깝다.
제약 자체가 이야기의 핵심이다
같은 출처들은 이 아키텍처에 의미 있는 제약이 따른다는 점도 분명히 보여준다. 첫째, Minions는 전체 규모의 학습이 아니라 추론 워크로드를 전제로 논의된다. 둘째, 이 시스템은 유휴 상태의 Apple Silicon macOS 기기에 의존하므로, 공급량은 직원들의 행동과 기기 사용 패턴에 따라 흔들린다. 사용자 기계로 구성된 분산 풀은 본질적으로 동적이다. 노드는 사라질 수 있고, 성능은 서로 다른 Mac 모델에 따라 달라질 수 있으며, 시스템은 장애를 예외가 아니라 일상적인 운영 조건으로 감내해야 한다.
셋째, 스토리지와 오케스트레이션 오버헤드는 설계의 중심 요소일 가능성이 크다. 중앙 서버, 데이터베이스, 그리고 S3 스타일 결과 저장소를 사용한다는 보도는 작업 조정과 데이터 이동이 중요한 고려 사항임을 시사한다. 분산 추론은 많은 GPU의 이점을 얻을 수 있지만, 모든 모델이나 작업이 깔끔하게 분할되는 것은 아니다. 이것은 Apple 요약문이 극단적인 성능 주장보다는 장애 허용성과 스케줄링 유연성을 강조하는 이유를 설명해 준다.
01net은 또 최신 Mac mini와 Mac Studio 시스템이 Thunderbolt 5를 통한 RDMA로 연결될 수 있으며, 이를 통해 메모리와 연산 자원을 결합해 단일 기계로는 올릴 수 없을 만큼 큰 모델을 적재할 수 있다고 전한다. 이는 매우 눈에 띄는 세부 사항이지만, 여기 제시된 출처들에서는 Apple의 짧은 요약문이 아니라 01net 기사에만 등장한다. 따라서 두 출처 모두가 확립한 사실이라기보다, 보도된 가능성으로 읽는 편이 맞다. 만약 보도된 그대로 구현되어 있다면, 이는 Mac에서 단일 기기 추론을 할 때 가장 분명한 병목 중 하나인 모델 크기와 로컬 메모리 한계의 충돌을 완화하는 데 도움이 될 것이다.
Apple이 말하는 것과 말하지 않는 것
Apple 자체의 연구 요약은 절제된 표현 때문에 오히려 눈에 띈다. 회사는 Minions가 유휴 Mac을 실용적인 분산 GPU 추론 플랫폼으로 바꿀 수 있으며, 이 시스템이 유연한 작업 실행, 장애 허용성, 효율적인 자원 활용을 제공한다고 말한다. 그러나 여기서 확인 가능한 원문 범위 안에서는, 이 접근법이 중앙 클러스터를 대체한다거나, 초대형 모델을 폭넓게 지원한다거나, 모든 AI 워크로드에 적합하다고 주장하지는 않는다. 이런 생략은 오히려 많은 것을 말해 준다. 즉 Minions는 Apple Silicon 기기의 변동성이 큰 풀에 작업을 분산할 수 있는 추론 업무를 대상으로, 부족한 공용 GPU 접근성이라는 특정 병목에 대응하기 위해 내부적으로 고안된 해법이라는 뜻으로 읽힌다.
기업 독자 관점에서의 구체적인 시사점은 사무실의 노트북과 데스크톱이 데이터센터용 GPU를 손쉽게 대체할 수 있다는 것이 아니다. 보다 정확한 해석은 중앙집중형 추론 용량이 제한된 환경에서, 적절히 관리된 유휴 직원용 Mac 풀은 알맞은 워크로드에 한해 보조적인 내부 계층이 될 수 있다는 점이다. 다만 이를 위해서는 오케스트레이션, 장애 처리, 고르지 않은 기기 가용성, 그리고 초대형 학습 작업이 아니라 추론 중심 업무라는 보다 좁은 적용 범위를 기업이 감당할 수 있어야 한다.
출처
- Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon DevicesApple Machine Learning Research · 2026년 10월 1일
- À court de cartes graphiques, Apple réquisitionne les Mac de ses employés01net · 2026년 10월 15일