Google apresenta os chips TPU 8tx e 8i Max para agentes de IA
A Google revelou a 9 de novembro de 2026 dois chips TPU de oitava geração: o TPU 8tx, confidencial com CPU da AMD, e o TPU 8i Max, com o dobro de computação.
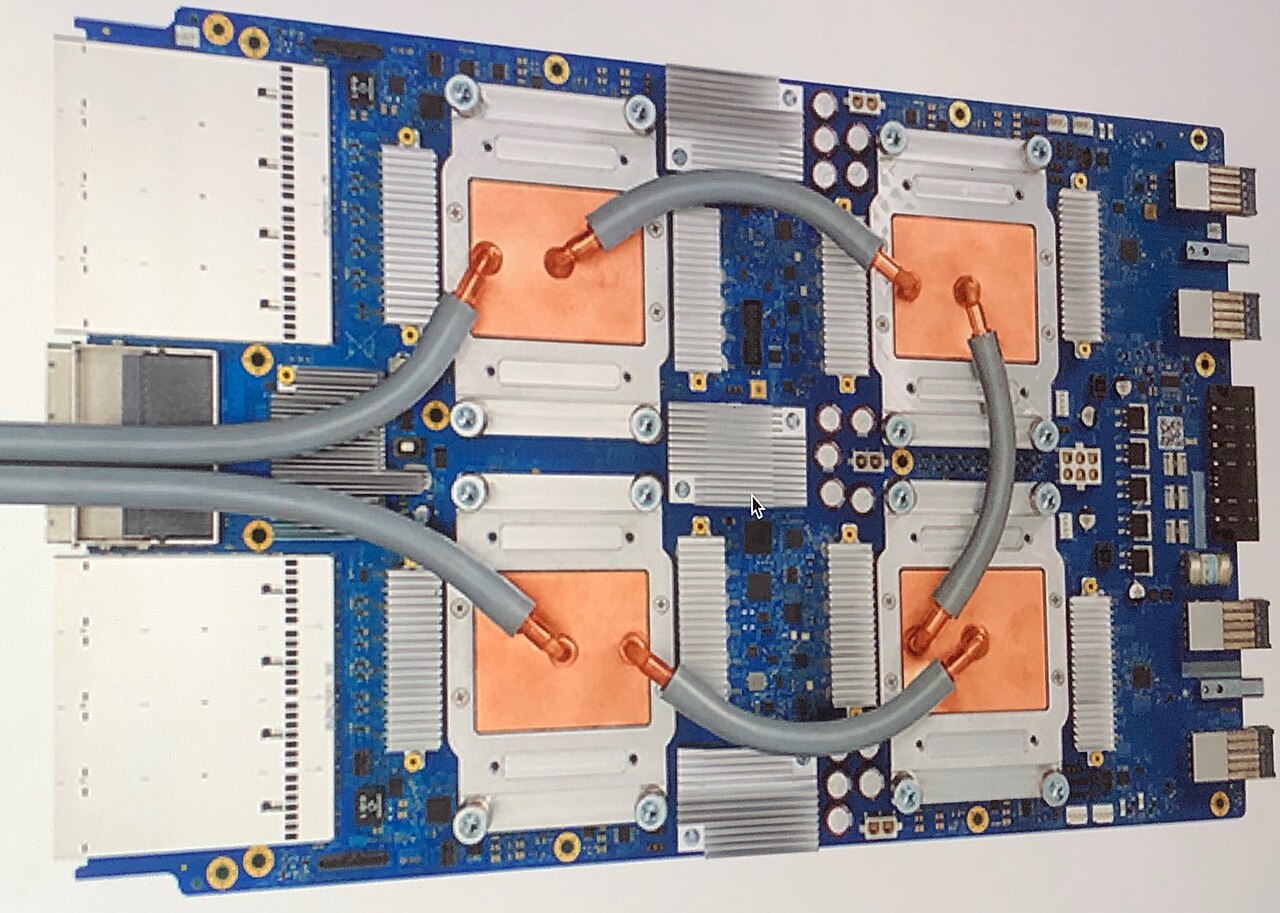
A 9 de novembro de 2026, a Google apresentou dois novos sistemas da sua oitava geração de TPU: o TPU 8tx e o TPU 8i Max. Segundo a Google, é a primeira vez que lança quatro sistemas TPU num único ano. De acordo com o Gigazine, o TPU 8tx é combinado com processadores da AMD para tratar dados confidenciais em segurança, enquanto o TPU 8i Max junta dois chips num só módulo para aumentar o desempenho.
Um TPU (Tensor Processing Unit) é um processador que a Google desenha para treinar e executar inteligência artificial. Em abril de 2026, no Google Cloud Next, a empresa já tinha apresentado o TPU 8t, para treino em grande escala, e o TPU 8i, para raciocínio em tempo real. Segundo a Google, oferecem até 2,7 vezes mais desempenho de treino e 80% mais relação preço-desempenho em inferência do que a geração anterior. Os dois novos sistemas juntam-se a este par.
TPU 8tx: proteger os dados enquanto são processados
Normalmente, os dados são cifrados quando armazenados ou enviados pela rede, mas têm de ser decifrados na memória enquanto o computador os processa. A computação confidencial procura proteger esses dados em utilização e também os pesos do próprio modelo de IA. Isto importa a empresas e governos que querem que agentes autónomos tratem informação sensível.
Segundo a Google, o TPU 8tx usa o mesmo silício do TPU 8t e é associado a anfitriões AMD EPYC de quinta geração. A segurança está integrada na camada de hardware, pelo que os dados e os pesos do modelo permanecem protegidos e isolados mesmo durante a utilização. O sistema adota ainda a Boardfly, a rede de baixa latência criada para o raciocínio em tempo real, que, segundo a Google, reduz a latência até metade face ao TPU 8t, com uma penalização de desempenho quase nula.
O TPU 8tx serve também para treino em pequena escala. As equipas podem afinar modelos com dados privados, destilar modelos grandes em modelos menores e treinar agentes por aprendizagem por reforço, sem mover dados sensíveis entre clusters diferentes. A Google destina-o a empresas reguladas e a governos que executam modelos de fronteira ou proprietários junto dos seus dados mais sensíveis.
TPU 8i Max: derrubar o muro da memória
A quantidade de informação que uma IA consegue consultar de uma só vez chama-se janela de contexto. Quando dezenas de agentes trabalham sobre todo um código-fonte ou sobre horas de vídeo, a largura de banda da memória torna-se rapidamente o estrangulamento. A Google chama-lhe o muro da memória.
Para o contornar, o TPU 8i Max combina dois chips TPU 8i de baixa latência num único módulo. A Google afirma que oferece o dobro de computação, o dobro de SRAM e o dobro de largura de banda HBM do TPU 8i. Como cabe o dobro de silício no espaço de um bastidor atual, os centros de dados podem instalar mais capacidade por metro quadrado e por watt.
- Anúncio: 9 de novembro de 2026 (blogue da Google)
- Quatro sistemas TPU de oitava geração: 8t (treino), 8i (inferência), 8tx (confidencial), 8i Max (contexto alargado)
- TPU 8tx: latência até metade da do 8t, penalização de desempenho quase nula (Google)
- TPU 8i Max: computação, SRAM e largura de banda HBM duplicadas face ao 8i (Google)
Um sistema novo, não um chip novo
A Google distingue desenhar um chip, processo de vários anos, de construir um sistema, que reorganiza computação, rede, armazenamento, encapsulamento e segurança em torno do chip. Esta modularidade, diz, permite entregar máquinas especializadas em meses e não em anos. Segundo o Gigazine, o presidente executivo Sundar Pichai explicou que a conceção conjunta com investigadores da Google DeepMind permite continuar a inovar para os clientes sem esperar pelo ciclo habitual dos semicondutores.
No software, a Google diz que o TorchTPU, aberto no mês passado, permite executar código PyTorch e modelos da Hugging Face nativamente em TPU, sem reescrita. Existem também backends de TPU para motores de inferência como o vLLM e o SGLang. Um novo conjunto de agentes de código aberto, em pré-visualização, liga-se a ferramentas de programação como Claude Code, Cursor e Google Antigravity para automatizar a adoção dos TPU. A Google afirma ter quase 100 clientes de TPU, entre laboratórios de ponta, empresas de trading, retalhistas e universidades.
O que ainda não se sabe
As datas de disponibilidade e os preços do TPU 8tx e do TPU 8i Max não eram conhecidos quando o Gigazine redigiu o artigo. Todos os números de desempenho vêm da Google e as fontes lidas não incluem medições independentes. Alguns meios, como o coreano AI Times, apresentam os chips como uma perseguição à Nvidia, mas as duas fontes que conseguimos ler não os comparam diretamente com os GPU da Nvidia. A rivalidade é contexto de mercado, não um resultado medido.
O que isto muda para as empresas portuguesas
Para empresas portuguesas da banca, da saúde ou do setor público que ponderam agentes de IA, o anúncio alarga o leque de opções: afinar ou destilar um modelo com dados privados sem os retirar de um ambiente protegido é um argumento para equipas preocupadas com fugas de dados. Enquanto datas e preços não forem divulgados, é prudente aguardar informação oficial antes de planear uma implementação. A compatibilidade anunciada com o PyTorch dá, por seu lado, a quem já tem equipas de IA uma primeira medida do esforço de migração.
Fontes
- Googleが新型AIチップ「TPU 8tx」「TPU 8i Max」を発表、AMD製CPUを採用した機密情報保護モデルと処理性能2倍のモデルが登場GIGAZINE · 10 de novembro de 2026
- Our newest TPUs: 8tx and 8i Max, built for the agentic eraGoogle (The Keyword) · 9 de novembro de 2026