Google stellt KI-Chips TPU 8tx und 8i Max für KI-Agenten vor
Google hat am 9. November 2026 zwei TPU-Chips der 8. Generation vorgestellt: den vertraulichen TPU 8tx mit AMD-CPU und den TPU 8i Max mit doppelter Rechenleistung.
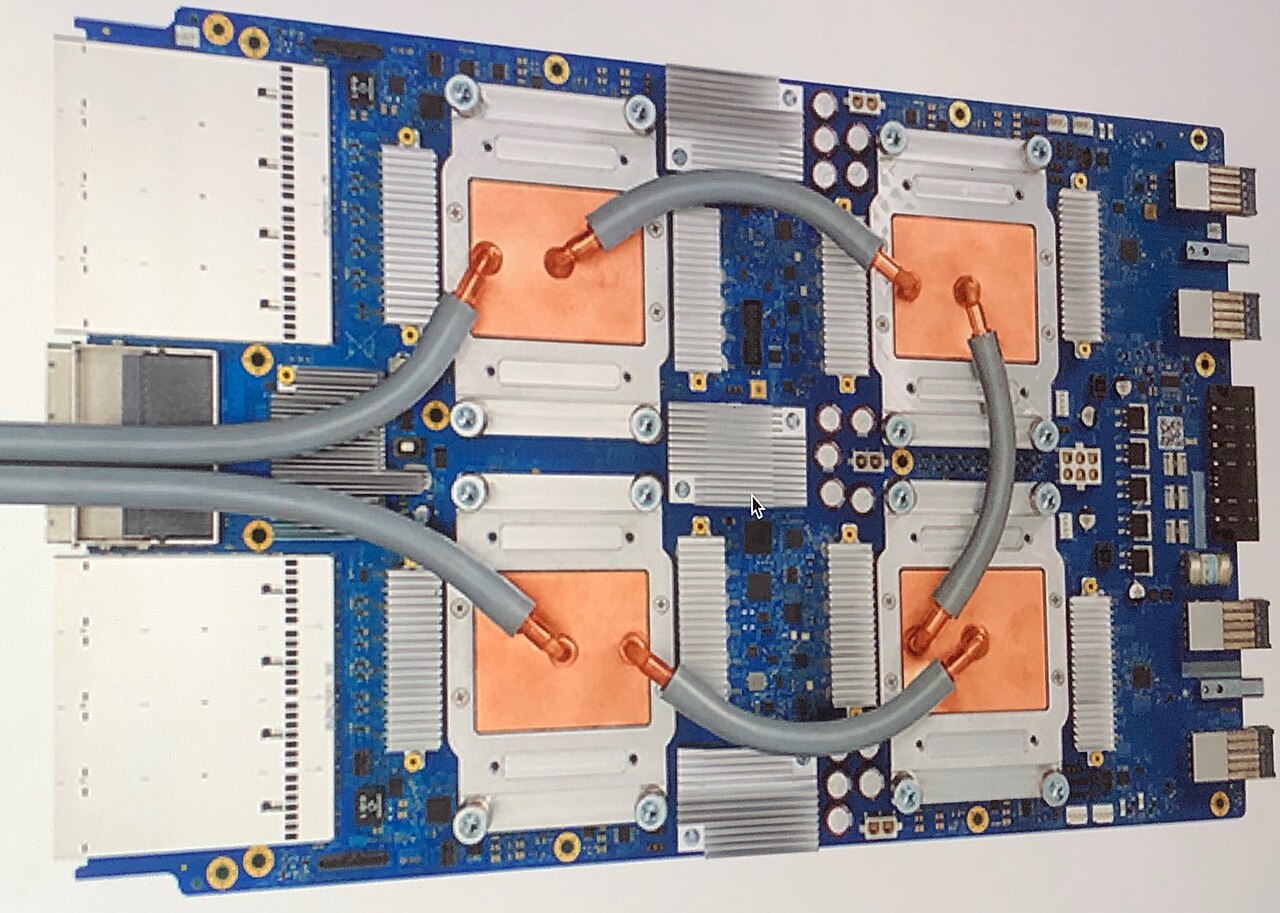
Google hat am 9. November 2026 zwei neue Systeme seiner achten TPU-Generation vorgestellt: den TPU 8tx und den TPU 8i Max. Nach Angaben von Google bringt das Unternehmen damit erstmals vier TPU-Systeme innerhalb eines Jahres auf den Markt. Wie Gigazine berichtet, wird der TPU 8tx mit AMD-Prozessoren kombiniert, um vertrauliche Daten sicher zu verarbeiten, während der TPU 8i Max zwei Chips in einem Gehäuse bündelt, um die Rechenleistung zu steigern.
Eine TPU (Tensor Processing Unit) ist ein Prozessor, den Google für das Training und den Betrieb künstlicher Intelligenz entwickelt. Im April 2026 hatte das Unternehmen auf der Google Cloud Next bereits den TPU 8t für Training im großen Maßstab und den TPU 8i für Echtzeit-Schlussfolgern vorgestellt. Laut Google bieten sie gegenüber der Vorgängergeneration bis zu 2,7-mal bessere Trainingsleistung beziehungsweise 80 Prozent besseres Preis-Leistungs-Verhältnis bei der Inferenz. Die beiden neuen Systeme ergänzen dieses Paar.
TPU 8tx: Daten schützen, während sie verarbeitet werden
Daten werden üblicherweise verschlüsselt gespeichert und übertragen, müssen aber im Arbeitsspeicher entschlüsselt werden, während ein Computer sie verarbeitet. Vertrauliches Rechnen (Confidential Computing) soll diese Daten in Verwendung schützen, ebenso die Gewichte des KI-Modells selbst. Für Unternehmen und Behörden, die autonome Agenten mit sensiblen Informationen arbeiten lassen wollen, ist das ein reales Problem.
Laut Google basiert der TPU 8tx auf demselben Silizium wie der TPU 8t und wird mit AMD-EPYC-Host-CPUs der fünften Generation kombiniert. Die Sicherheit ist in die Hardware-Ebene eingebaut, sodass sensible Daten und Modellgewichte auch während der aktiven Nutzung geschützt und isoliert bleiben. Außerdem nutzt das System Boardfly, das für Echtzeit-Schlussfolgern entwickelte Netzwerk mit niedriger Latenz, das laut Google die Latenz gegenüber dem TPU 8t um bis zu die Hälfte senkt, bei nahezu null Leistungseinbuße.
Der TPU 8tx eignet sich auch für Training im kleinen Maßstab. Teams können Modelle mit privaten Daten feinabstimmen, große Modelle in kleinere destillieren und Agenten per Reinforcement Learning trainieren, ohne sensible Daten zwischen getrennten Clustern zu verschieben. Google richtet ihn an regulierte Unternehmen und Regierungen, die Spitzen- oder eigene Modelle neben ihren sensibelsten Daten betreiben.
TPU 8i Max: die Speichermauer durchbrechen
Die Informationsmenge, die eine KI auf einmal berücksichtigen kann, heißt Kontextfenster. Wenn Dutzende KI-Agenten gemeinsam an einer ganzen Software-Codebasis oder an stundenlangem Videomaterial arbeiten, wird die Speicherbandbreite schnell zum Engpass. Google nennt das die Speichermauer.
Um sie zu überwinden, kombiniert der TPU 8i Max zwei latenzarme TPU-8i-Chips in einem Gehäuse. Laut Google liefert er gegenüber dem TPU 8i doppelte Rechenleistung, doppelt so viel SRAM und doppelte HBM-Bandbreite. Weil doppelt so viel Silizium in den vorhandenen Rack-Platz passt, können Rechenzentren mehr Leistung pro Quadratmeter und pro Watt einsetzen.
- Ankündigung: 9. November 2026 (Google-Blog)
- Vier TPU-Systeme der 8. Generation: 8t (Training), 8i (Inferenz), 8tx (vertraulich), 8i Max (großer Kontext)
- TPU 8tx: bis zu halbe Latenz gegenüber dem 8t, nahezu keine Leistungseinbuße (Google)
- TPU 8i Max: Rechenleistung, SRAM und HBM-Bandbreite jeweils doppelt so hoch wie beim 8i (Google)
Ein neues System, kein neuer Chip
Google unterscheidet zwischen dem Entwurf eines Chips, einem mehrjährigen Prozess, und dem Bau eines Systems, das Rechenwerk, Netzwerk, Speicher, Gehäuse und Sicherheit um den Chip herum neu zusammenstellt. Diese Modularität erlaube es, spezialisierte Maschinen in Monaten statt Jahren zu liefern. Laut Gigazine sagte CEO Sundar Pichai, die gemeinsame Entwicklung mit Forschern von Google DeepMind erlaube es, für Kunden weiter zu innovieren, ohne den üblichen Halbleiterzyklus abzuwarten.
Bei der Software sagt Google, TorchTPU, seit dem vergangenen Monat Open Source, lasse PyTorch-Code und Hugging-Face-Modelle ohne Umschreiben nativ auf TPUs laufen. Auch für Inferenz-Engines wie vLLM und SGLang gibt es TPU-Backends. Eine neue Open-Source-Agentensammlung für TPUs, derzeit als Vorschau, lässt sich in Coding-Werkzeuge wie Claude Code, Cursor und Google Antigravity einbinden und automatisiert den TPU-Einstieg. Google nennt fast 100 TPU-Kunden, darunter Spitzenlabore, Handelsfirmen, Einzelhändler und Universitäten.
Was noch unklar ist
Verfügbarkeitstermine und Preise für TPU 8tx und TPU 8i Max waren bei Gigazines Artikel nicht bekannt. Alle genannten Leistungszahlen stammen von Google; unabhängige Messungen enthalten die gelesenen Quellen nicht. Einige Medien, etwa das koreanische AI Times, stellen die Chips als Aufholjagd gegen Nvidia dar, doch die beiden Quellen, die wir lesen konnten, vergleichen sie nicht direkt mit Nvidia-GPUs. Die Rivalität ist Marktkontext, kein gemessenes Ergebnis.
Was das für deutsche Unternehmen ändert
Für Unternehmen aus Banken, Gesundheitswesen oder öffentlichem Sektor, die KI-Agenten erwägen, erweitert die Ankündigung die Auswahl: Ein Modell mit privaten Daten feinzustimmen oder zu destillieren, ohne die Daten aus einer geschützten Umgebung zu holen, ist ein Argument für Teams, die Datenabflüsse fürchten. Solange Termine und Preise nicht veröffentlicht sind, ist es ratsam, offizielle Informationen abzuwarten, bevor ein Einsatz geplant wird. Die angekündigte PyTorch-Kompatibilität gibt Teams, die bereits KI entwickeln, einen ersten Maßstab für den Migrationsaufwand.
Quellen
- Googleが新型AIチップ「TPU 8tx」「TPU 8i Max」を発表、AMD製CPUを採用した機密情報保護モデルと処理性能2倍のモデルが登場GIGAZINE · 10. November 2026
- Our newest TPUs: 8tx and 8i Max, built for the agentic eraGoogle (The Keyword) · 9. November 2026