Google onthult TPU 8tx en 8i Max, chips voor AI-agenten
Google presenteerde op 9 november 2026 twee TPU-chips van de achtste generatie: de vertrouwelijke TPU 8tx met AMD-cpu en de TPU 8i Max met verdubbelde rekenkracht.
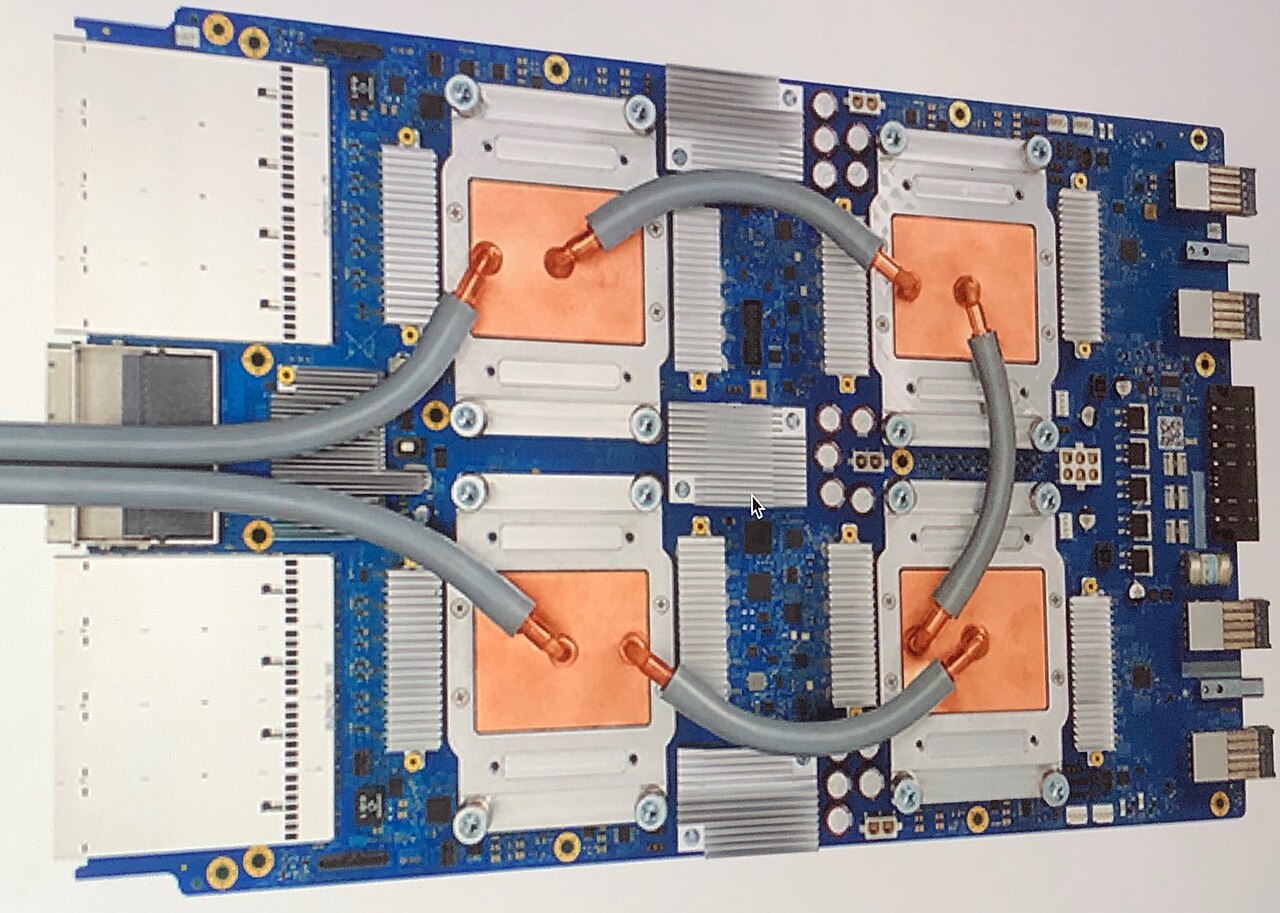
Google heeft op 9 november 2026 twee nieuwe systemen uit zijn achtste TPU-generatie gepresenteerd: de TPU 8tx en de TPU 8i Max. Volgens Google brengt het bedrijf voor het eerst vier TPU-systemen in één jaar uit. Gigazine meldt dat de TPU 8tx wordt gecombineerd met AMD-processors om vertrouwelijke gegevens veilig te verwerken, terwijl de TPU 8i Max twee chips in één behuizing combineert om de rekenprestaties te verhogen.
Een TPU (Tensor Processing Unit) is een processor die Google ontwerpt voor het trainen en draaien van kunstmatige intelligentie. In april 2026 had het bedrijf op Google Cloud Next al de TPU 8t voor grootschalige training en de TPU 8i voor redeneren in realtime gepresenteerd. Volgens Google leveren ze tot 2,7 keer betere trainingsprestaties en 80 procent betere prijs-prestatieverhouding bij inferentie dan de vorige generatie. De twee nieuwe systemen vullen dit duo aan.
TPU 8tx: gegevens beschermen terwijl ze worden verwerkt
Gegevens worden meestal versleuteld opgeslagen en verzonden, maar moeten in het geheugen worden ontsleuteld terwijl een computer ze verwerkt. Confidential computing wil die gegevens tijdens gebruik beschermen, net als de gewichten van het AI-model zelf. Dat is een reëel vraagstuk voor bedrijven en overheden die autonome agenten met gevoelige informatie willen laten werken.
Volgens Google is de TPU 8tx gebouwd op hetzelfde silicium als de TPU 8t en gekoppeld aan AMD EPYC-hostprocessors van de vijfde generatie. De beveiliging zit in de hardwarelaag, zodat gevoelige gegevens en modelgewichten beschermd en geïsoleerd blijven, ook tijdens actief gebruik. Het systeem gebruikt bovendien Boardfly, het netwerk met lage latentie dat is ontwikkeld voor redeneren in realtime, en dat volgens Google de latentie tot de helft verlaagt ten opzichte van de TPU 8t, met een vrijwel nul prestatieverlies.
De TPU 8tx is ook geschikt voor kleinschalige training. Teams kunnen modellen finetunen op privégegevens, grote modellen destilleren tot kleinere en agenten trainen met reinforcement learning, zonder gevoelige gegevens tussen afzonderlijke clusters te verplaatsen. Google richt het systeem op gereguleerde bedrijven en overheden die geavanceerde of eigen modellen draaien naast hun gevoeligste gegevens.
TPU 8i Max: dwars door de geheugenmuur
De hoeveelheid informatie die een AI in één keer kan raadplegen heet het contextvenster. Wanneer tientallen AI-agenten samen werken aan een complete softwarecodebase of aan uren video, wordt de geheugenbandbreedte snel de bottleneck. Google noemt dat de geheugenmuur.
Om die te omzeilen combineert de TPU 8i Max twee TPU 8i-chips met lage latentie in één behuizing. Volgens Google levert dat tweemaal de rekenkracht, tweemaal het SRAM en tweemaal de HBM-bandbreedte van de TPU 8i. Omdat er twee keer zoveel silicium in de bestaande rackruimte past, kunnen datacenters meer rekenkracht per vierkante meter en per watt inzetten.
- Aangekondigd: 9 november 2026 (Google-blog)
- Vier TPU-systemen van de achtste generatie: 8t (training), 8i (inferentie), 8tx (vertrouwelijk), 8i Max (grote context)
- TPU 8tx: tot de helft van de latentie van de 8t, vrijwel geen prestatieverlies (Google)
- TPU 8i Max: rekenkracht, SRAM en HBM-bandbreedte elk verdubbeld ten opzichte van de 8i (Google)
Een nieuw systeem, geen nieuwe chip
Google maakt onderscheid tussen het ontwerpen van een chip, een proces van meerdere jaren, en het bouwen van een systeem, waarbij rekenkracht, netwerk, opslag, verpakking en beveiliging rond de chip opnieuw worden samengesteld. Door die modulariteit kunnen gespecialiseerde machines in maanden in plaats van jaren worden geleverd, aldus het bedrijf. Volgens Gigazine zei ceo Sundar Pichai dat het gezamenlijke ontwerp met onderzoekers van Google DeepMind het mogelijk maakt voor klanten te blijven vernieuwen zonder de gebruikelijke halfgeleidercyclus af te wachten.
Op softwaregebied zegt Google dat TorchTPU, sinds vorige maand open source, PyTorch-code en Hugging Face-modellen zonder herschrijven native op TPU's laat draaien. Ook voor inferentie-engines als vLLM en SGLang bestaan TPU-backends. Een nieuwe open-source agentensuite voor TPU's, nu in preview, koppelt aan programmeertools als Claude Code, Cursor en Google Antigravity om de ingebruikname van TPU's te automatiseren. Google noemt bijna 100 TPU-klanten, waaronder toonaangevende AI-laboratoria, handelsbedrijven, retailers en universiteiten.
Wat nog onbekend is
Beschikbaarheidsdata en prijzen van de TPU 8tx en TPU 8i Max waren niet bekend toen Gigazine zijn artikel schreef. Alle genoemde prestatiecijfers komen van Google; onafhankelijke metingen staan niet in de gelezen bronnen. Sommige media, zoals het Koreaanse AI Times, presenteren de chips als een inhaalslag op Nvidia, maar de twee bronnen die wij konden lezen vergelijken ze niet rechtstreeks met Nvidia-gpu's. De rivaliteit is marktcontext, geen gemeten resultaat.
Wat dit verandert voor Nederlandse bedrijven
Voor bedrijven in de bank-, zorg- of publieke sector die AI-agenten overwegen, vergroot de aankondiging het aanbod aan opties: een model finetunen of destilleren op privégegevens zonder die uit een beschermde omgeving te halen is een argument voor teams die datalekken vrezen. Zolang data en prijzen niet bekend zijn, is het verstandig officiële informatie af te wachten voordat een uitrol wordt gepland. De aangekondigde PyTorch-compatibiliteit geeft teams die al met AI werken een eerste maatstaf voor de migratie-inspanning.
Bronnen
- Googleが新型AIチップ「TPU 8tx」「TPU 8i Max」を発表、AMD製CPUを採用した機密情報保護モデルと処理性能2倍のモデルが登場GIGAZINE · 10 november 2026
- Our newest TPUs: 8tx and 8i Max, built for the agentic eraGoogle (The Keyword) · 9 november 2026