Google presenta los chips TPU 8tx y 8i Max para agentes de IA
Google presentó el 9 de noviembre de 2026 dos chips TPU de octava generación: el TPU 8tx, confidencial con CPU de AMD, y el TPU 8i Max, con el doble de cómputo.
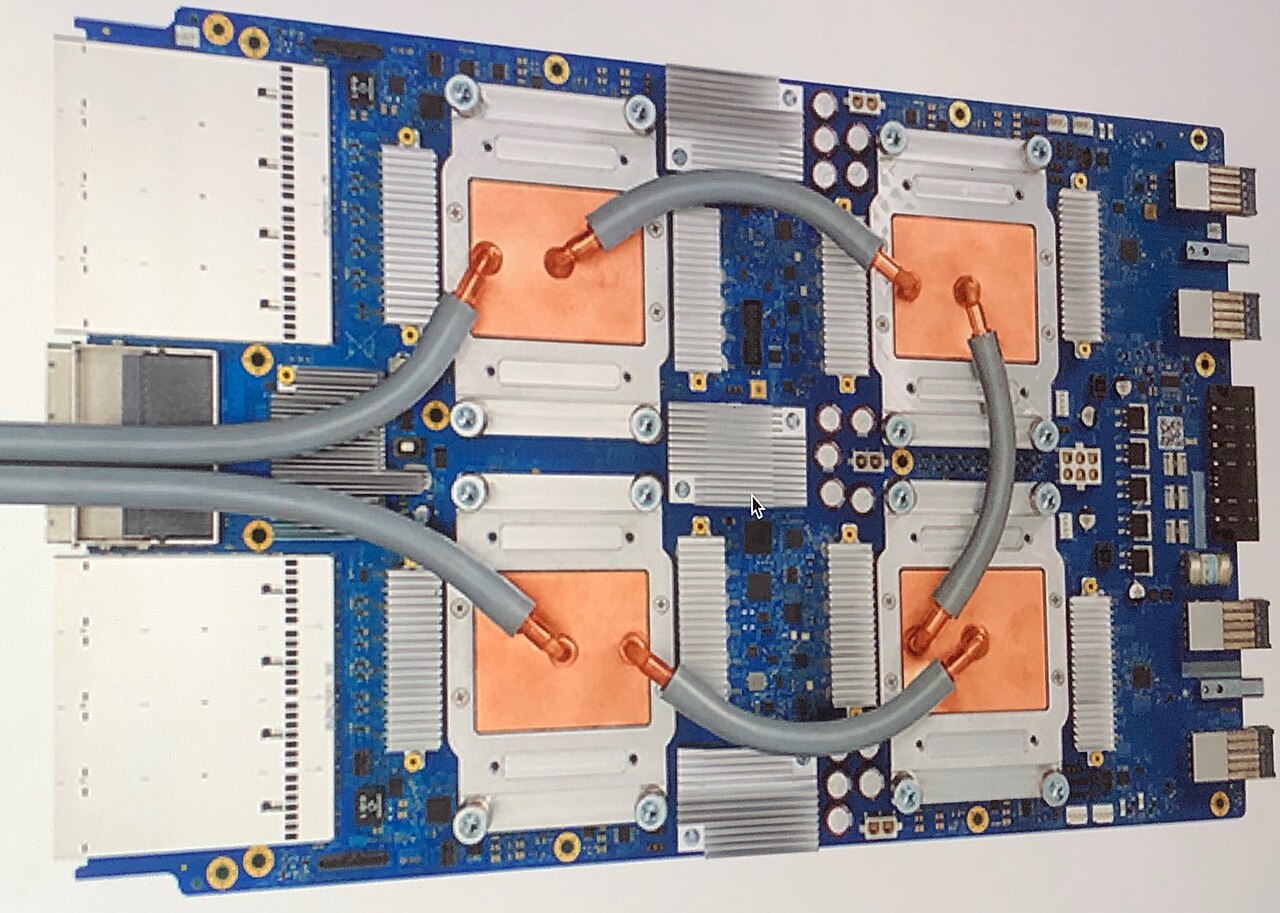
El 9 de noviembre de 2026, Google presentó dos nuevos sistemas de su octava generación de TPU: el TPU 8tx y el TPU 8i Max. Según Google, es la primera vez que lanza cuatro sistemas TPU en un solo año. De acuerdo con Gigazine, el TPU 8tx se combina con procesadores de AMD para tratar datos confidenciales de forma segura, mientras que el TPU 8i Max reúne dos chips en un mismo paquete para elevar el rendimiento.
Un TPU (Tensor Processing Unit) es un procesador que Google diseña para entrenar y ejecutar inteligencia artificial. En abril de 2026, durante Google Cloud Next, la compañía ya había presentado el TPU 8t, para entrenamiento a gran escala, y el TPU 8i, para razonamiento en tiempo real. Según Google, ofrecen hasta 2,7 veces más rendimiento de entrenamiento y un 80 % más de relación precio-rendimiento en inferencia que la generación anterior. Los dos sistemas nuevos se suman a esa pareja.
TPU 8tx: proteger los datos mientras se procesan
Los datos suelen cifrarse cuando se almacenan o se envían por la red, pero deben descifrarse en la memoria mientras un equipo los procesa. La computación confidencial busca proteger esos datos en uso y también los pesos del propio modelo de IA. Es un asunto clave para empresas y gobiernos que quieren que agentes autónomos manejen información sensible.
Según Google, el TPU 8tx utiliza el mismo silicio que el TPU 8t y se empareja con procesadores host AMD EPYC de quinta generación. La seguridad está integrada en el hardware, de modo que los datos y los pesos del modelo siguen protegidos y aislados incluso durante su uso. El sistema adopta además Boardfly, la red de baja latencia creada para el razonamiento en tiempo real, que según Google reduce la latencia hasta a la mitad frente al TPU 8t con una penalización de rendimiento casi nula.
El TPU 8tx también sirve para entrenamientos de pequeña escala. Los equipos pueden ajustar modelos con datos privados, destilar modelos grandes en otros más pequeños y entrenar agentes mediante aprendizaje por refuerzo, sin trasladar datos sensibles entre clústeres distintos. Google lo dirige a empresas reguladas y gobiernos que ejecutan modelos de frontera o propios junto a sus datos más delicados.
TPU 8i Max: derribar el muro de la memoria
La cantidad de información que una IA puede consultar de una vez se llama ventana de contexto. Cuando decenas de agentes trabajan sobre todo un código de software o sobre horas de vídeo, el ancho de banda de la memoria se convierte enseguida en el cuello de botella. Google lo llama el muro de la memoria.
Para superarlo, el TPU 8i Max combina dos chips TPU 8i de baja latencia en un único paquete. Google afirma que ofrece el doble de cómputo, el doble de SRAM y el doble de ancho de banda HBM que el TPU 8i. Como cabe el doble de silicio en el espacio de un rack actual, los centros de datos pueden desplegar más potencia por metro cuadrado y por vatio.
- Anuncio: 9 de noviembre de 2026 (blog de Google)
- Cuatro sistemas TPU de octava generación: 8t (entrenamiento), 8i (inferencia), 8tx (confidencial), 8i Max (contexto amplio)
- TPU 8tx: latencia hasta la mitad que el 8t, penalización de rendimiento casi nula (Google)
- TPU 8i Max: cómputo, SRAM y ancho de banda HBM duplicados respecto al 8i (Google)
Un sistema nuevo, no un chip nuevo
Google distingue entre diseñar un chip, un proceso de varios años, y construir un sistema, que reorganiza el cómputo, la red, el almacenamiento, el empaquetado y la seguridad alrededor del chip. Esa modularidad, asegura, permite entregar máquinas especializadas en meses y no en años. Según Gigazine, el consejero delegado Sundar Pichai explicó que el diseño conjunto con los investigadores de Google DeepMind permite seguir innovando para los clientes sin esperar al ciclo habitual de los semiconductores.
En software, Google asegura que TorchTPU, de código abierto desde el mes pasado, permite ejecutar código PyTorch y modelos de Hugging Face de forma nativa en TPU sin reescribirlos. También hay backends para motores de inferencia como vLLM y SGLang. Un nuevo conjunto de agentes de código abierto, en versión preliminar, se conecta a herramientas de programación como Claude Code, Cursor y Google Antigravity para automatizar la puesta en marcha de los TPU. Google dice contar con cerca de 100 clientes de TPU, entre ellos laboratorios de frontera, firmas de trading, minoristas y universidades.
Lo que aún no se sabe
Las fechas de disponibilidad y los precios del TPU 8tx y el TPU 8i Max no se conocían cuando Gigazine redactó su artículo. Todas las cifras de rendimiento proceden de Google y las fuentes leídas no incluyen mediciones independientes. Algunos medios, como el coreano AI Times, presentan los chips como una persecución de Nvidia, pero las dos fuentes que pudimos leer no los comparan directamente con las GPU de Nvidia. La rivalidad es contexto de mercado, no un resultado medido.
Qué cambia para las empresas
Para empresas de banca, salud o sector público que estudian agentes de IA, el anuncio amplía el abanico de opciones: ajustar o destilar un modelo con datos privados sin sacarlos de un entorno protegido es un argumento para los equipos que temen fugas de datos. Mientras no se publiquen fechas y precios, conviene esperar la información oficial antes de planificar un despliegue. La compatibilidad anunciada con PyTorch sí da a los equipos que ya trabajan con IA una primera medida del esfuerzo de migración.
Fuentes
- Googleが新型AIチップ「TPU 8tx」「TPU 8i Max」を発表、AMD製CPUを採用した機密情報保護モデルと処理性能2倍のモデルが登場GIGAZINE · 10 de noviembre de 2026
- Our newest TPUs: 8tx and 8i Max, built for the agentic eraGoogle (The Keyword) · 9 de noviembre de 2026