Processo do NYT expõe documentos internos da Microsoft e OpenAI sobre coleta massiva de dados
Memos internos não censurados da Microsoft e OpenAI foram apresentados no caso de direitos autorais liderado pelo NYT, rotulando a extração de conteúdo como roubo sem precedentes e alertando sobre um ciclo de receita destrutivo.
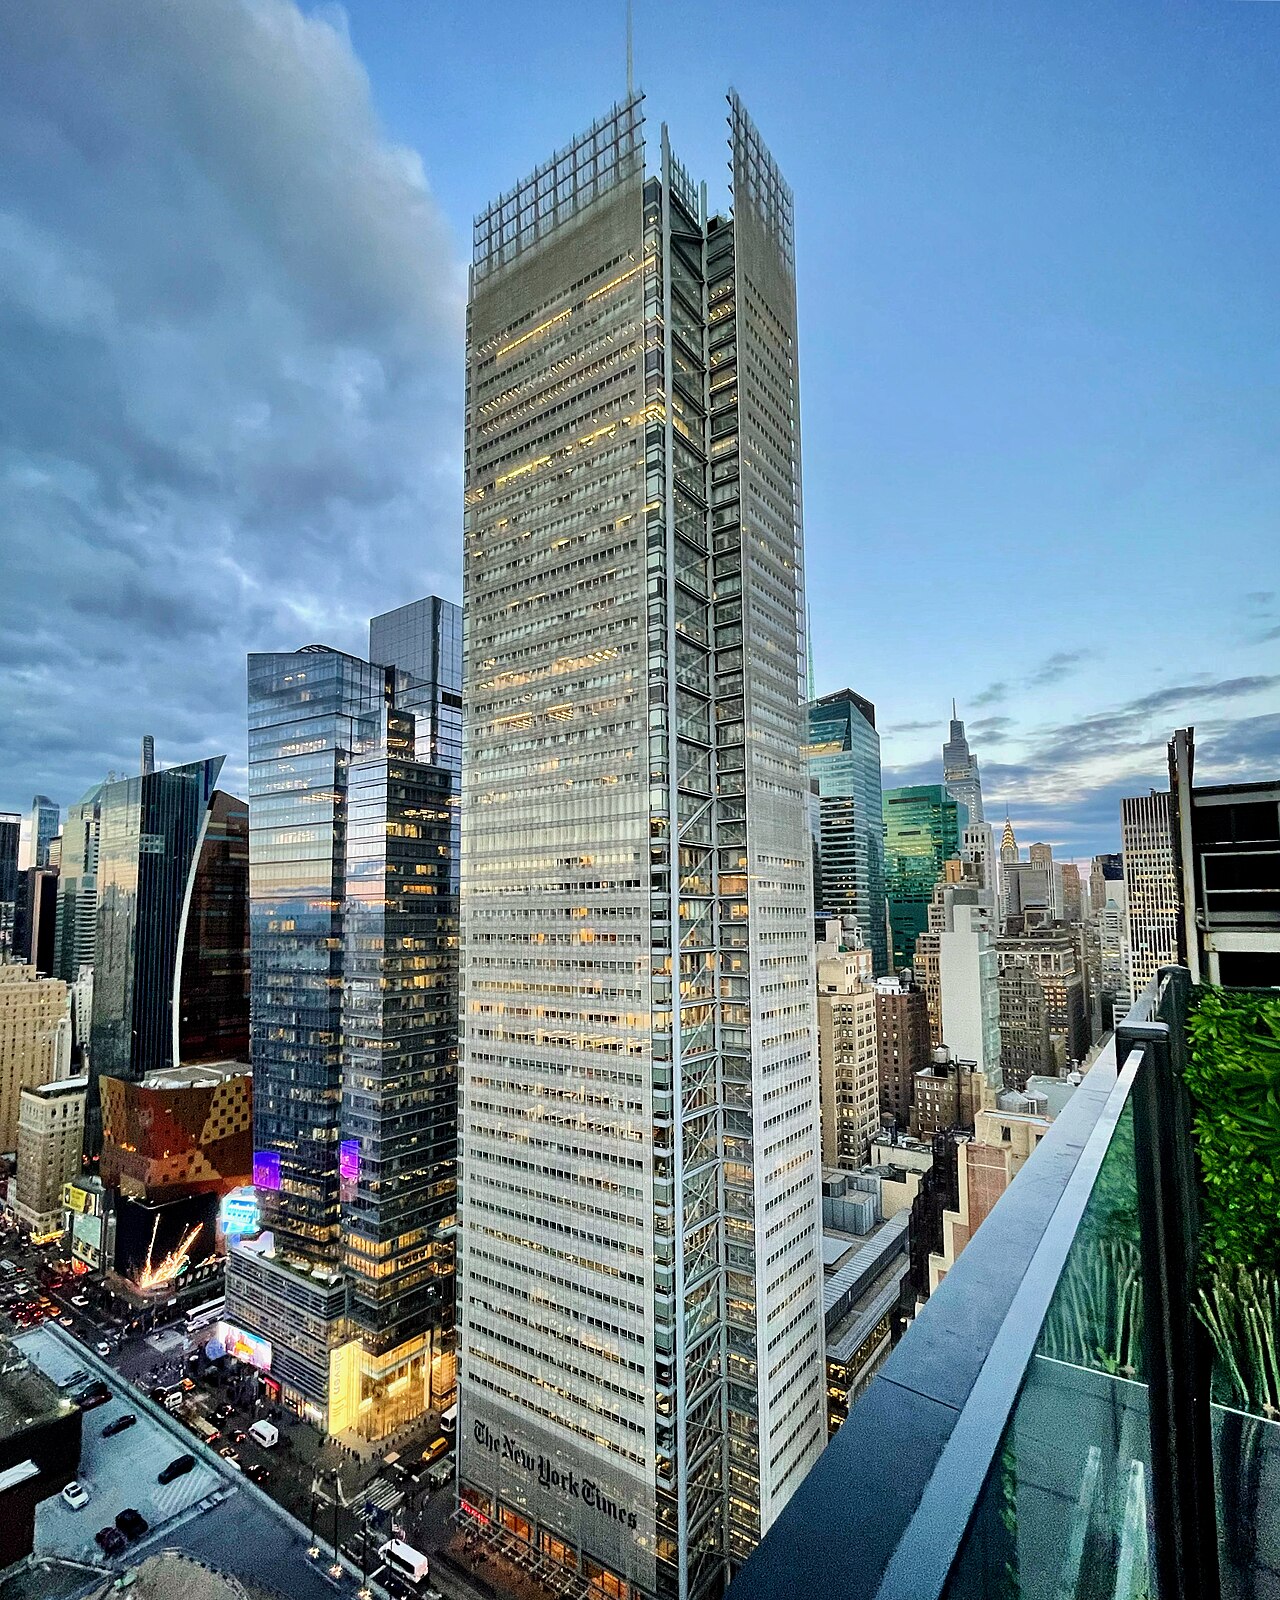
No processo de direitos autorais movido pelo The New York Times e por outros grandes editores contra a Microsoft e a OpenAI, os autores da ação apresentaram documentos internos que não foram anonimados, revelando de forma detalhada como as duas gigantes da tecnologia encaram a prática de coleta em larga escala de material protegido por direitos autorais para treinar seus modelos generativos de inteligência artificial.
Os autos do caso incluem e‑mails, memorandos e relatórios internos que foram inseridos no registro judicial sem qualquer censura prévia, conforme noticiado pela Ars Technica em 17 de setembro de 2026 e pela Golem.de em 18 de setembro de 2026, oferecendo ao tribunal um panorama completo das discussões internas sobre a estratégia de dados.
Linguagem executiva enquadra a prática como roubo sem precedentes
Um memorando interno citou Brent Hecht, diretor de ciências aplicadas da Microsoft, descrevendo a coleta massiva de conteúdo como "o maior roubo de trabalho da história da humanidade" e apontando que ele questionou, em nível interno, a dependência da empresa na defesa de argumentos de uso justo para justificar a extração de textos protegidos.
O comentário de Hecht, que foi apresentado nos autos, não constitui uma análise jurídica formal, mas reflete um ponto de vista pessoal; a Microsoft ressaltou posteriormente em sua resposta pública que tal opinião não representa a posição legal oficial da empresa.
Risco de ciclo econômico destrutivo
Um documento interno da Microsoft alertou para um "ciclo destrutivo": produtos de IA que utilizam conteúdo protegido podem reduzir a receita dos produtores originais, o que, por sua vez, diminui a quantidade de material disponível para futuros treinamentos, ameaçando a saúde a longo prazo do ecossistema editorial e editorialista.
Evidências de queda de tráfego e comportamento do usuário
Os autores da ação apresentaram dados internos que mostram quedas nas taxas de cliques de 83 % a 93 % para determinadas manchetes e de 51 % a 94 % para outras, depois que respostas geradas por IA foram exibidas em vez dos artigos originais, oferecendo esses números como evidência, embora não sejam ainda fatos julgados pelo tribunal.
Mensagens internas da OpenAI revelam que alguns funcionários acreditavam que os usuários seriam menos propensos a clicar em um link quando a resposta já era fornecida pela IA, reforçando a alegação dos editores de que há uma redução significativa de tráfego para os sites de origem.
- Brent Hecht chamou a raspagem "o maior roubo de trabalho da história da humanidade"
- Microsoft alertou sobre um ciclo de receita destrutivo para produtores de conteúdo
- Satya Nadella testemunhou que assistentes de IA podem substituir a visita ao site ao entregar a informação diretamente
- Equipe da OpenAI esperava taxas de cliques menores quando as respostas eram pré‑geradas
Satya Nadella, CEO da Microsoft, declarou sob juramento que assistentes de IA poderiam efetivamente substituir a visita do usuário à fonte original ao fornecer a informação solicitada diretamente, alinhando‑se às preocupações internas sobre perda de tráfego e impacto econômico nos editores.
Os autores também alegam que foi descoberta uma técnica de contorno de paywall, permitindo que um fornecedor externo obtivesse cerca de 1,8 milhão de artigos do New York Times sob restrições de uso comercial, os quais foram posteriormente usados para treinar os modelos de linguagem da OpenAI.
A Microsoft respondeu que as declarações citadas refletem a perspectiva de um funcionário individual e não constituem a posição legal oficial da empresa; tanto Microsoft quanto OpenAI continuam argumentando que seu uso de material protegido está dentro dos limites do uso justo, tese que ainda não foi julgada pelos tribunais.
Para organizações brasileiras, a divulgação desses documentos internos indica um aumento do risco regulatório para empresas que dependem de conteúdo gerado por IA, uma vez que as dúvidas internas sobre uso justo e as perdas de tráfego quantificadas sugerem que futuras ações judiciais podem impor requisitos de licenciamento mais rígidos, exigir transparência na origem dos dados e elevar os custos de implantação de grandes modelos de linguagem que utilizam textos protegidos.
Implicações para o mercado brasileiro de IA
Especialistas do Brasil apontam que o caso pode servir de precedente para demandas semelhantes no país, onde a legislação de direitos autorais ainda está se adaptando às tecnologias emergentes, e alertam que empresas locais precisarão rever suas práticas de coleta de dados para evitar litígios e possíveis sanções regulatórias.
Fontes
- Microsoft exec called AI scraping the largest theft of labor in human historyArs Technica · 17 de setembro de 2026
- Ungeschwärzte Dokumente belasten Microsoft und OpenAIGolem.de · 18 de setembro de 2026