Nvidia, 로컬 AI 에이전트와 모델 실행을 위해 64 GB DGX Spark를 4,999 USD에 출시
Nvidia는 2026년 10월 2일에 통합 메모리 64 GB를 탑재한 DGX Spark 플랫폼의 새로운 버전을 발표했으며, 10월 23일부터 여러 하드웨어 제조사를 통해 기본 가격 4,999 USD에 제공한다고 밝혔다.
발표 및 출시 일정
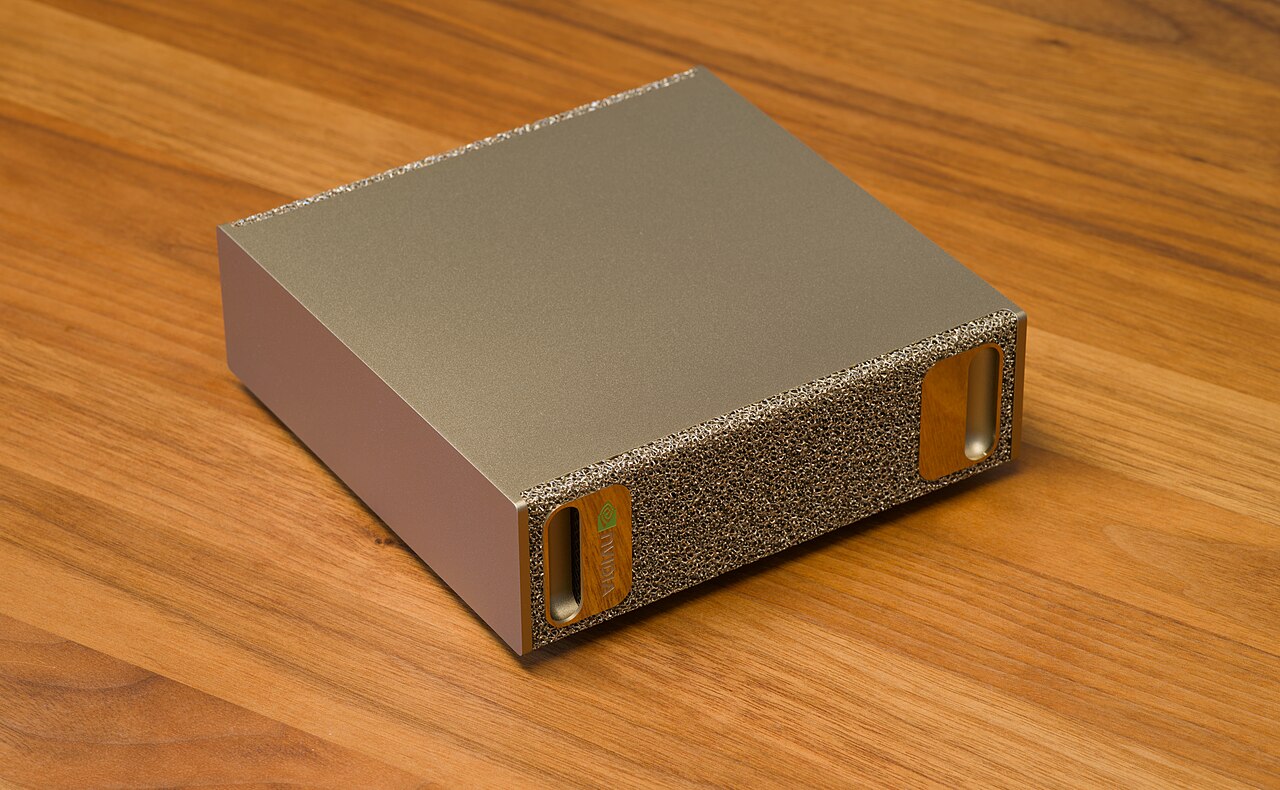
2026년 10월 2일, Nvidia는 DGX Spark 제품군에 새로운 구성을 추가한다는 공식 발표를 진행했습니다. 이 구성은 "DGX Spark 64 GB"라는 명칭으로, 통합 메모리 64 GB를 탑재하고 있다는 점이 핵심 특징입니다. 판매 시작일은 2026년 10월 23일로 정해졌으며, 기본 가격은 4,999 USD로 책정되었습니다. 주요 채널 파트너인 Acer, ASUS, Dell, Gigabyte, HP, MSI 등은 각각 레퍼런스 모델을 제공하고 있어, 고객은 자신의 기존 인프라와 요구 사항에 가장 적합한 모델을 선택할 수 있습니다. Nvidia는 이 모델을 클라우드에 전적으로 의존하지 않고도 AI 에이전트를 실행하고 모델 파인튜닝을 수행할 수 있는 가장 저렴한 옵션으로 포지셔닝하고 있으며, 이를 통해 비용 효율성을 강조하고 있습니다.
아키텍처 측면에서 DGX Spark 64 GB는 128 GB 버전과 동일한 GB10 Grace Blackwell 슈퍼칩을 사용합니다. 이 슈퍼칩은 페타플롭 수준에 근접하는 연산 능력을 제공하며, 고성능 연산을 필요로 하는 로컬 AI 워크로드에 적합하도록 설계되었습니다. 시스템에는 DGX OS 운영체제와 ConnectX‑7 네트워크 인터페이스, 그리고 CUDA 개발 스택이 기본으로 포함되어 있어, 소프트웨어와 하드웨어 간의 최적화된 통합을 지원합니다. 통합 메모리는 RAM과 VRAM을 하나의 주소 공간으로 결합하여 CPU와 GPU 간 데이터 이동을 단순화하고, 프로그래머가 별도의 메모리 전송 코드를 작성할 필요가 없도록 설계되었습니다. 이러한 설계는 메모리 관리 오버헤드를 감소시키고, 데이터 접근 지연 시간을 최소화함으로써 전체 시스템 효율성을 높이는 데 기여합니다.
모델 용량 및 성능
Nvidia는 단일 DGX Spark 64 GB 유닛이 최대 100,000백만 파라미터, 즉 100억 파라미터 규모의 모델을 실행할 수 있다고 주장합니다. 두 대의 유닛을 200 GbE 네트워크로 연결하면 총 메모리가 128 GB로 늘어나 모델 용량이 200,000백만 파라미터(200억 파라미터)까지 두 배로 증가합니다. 내부 테스트에서는 Qwen 3.8 27B 모델을 사용한 벤치마크에서 두 대 구성 시 단일 유닛 대비 약 1.7배의 성능 향상이 관찰되었습니다. 이러한 결과는 멀티노드 구성이 높은 부하의 워크로드에서도 효율적으로 확장될 수 있음을 시사합니다. 다만, 이러한 수치는 Nvidia가 자체 제공한 데이터에 기반한 것이며, 실제 운영 환경에서의 성능은 워크로드 특성 및 시스템 구성에 따라 달라질 수 있습니다.
용량 및 성능에 대한 수치는 모두 Nvidia가 자체 제공한 데이터에 기반합니다. MarkTechPost 사이트에서는 해당 기사가 스폰서 콘텐츠이며, 제시된 수치는 공급업체의 진술일 뿐 제3자가 검증한 결과가 아니라는 점을 명시하고 있습니다. 이러한 고지는 독립적인 하드웨어 평가를 원하는 독자들에게 중요한 정보를 제공합니다. 따라서 독자는 제시된 수치를 참고하되, 자체 테스트나 타사 평가 자료와 비교하여 최종 결정을 내리는 것이 바람직합니다.
예상 사용 사례
Nvidia에 따르면 DGX Spark 64 GB는 지속적으로 동작하는 AI 에이전트 실행, 실시간 추론, 모델 파인튜닝, 그리고 데이터 사이언스 워크플로 전체를 클라우드에 지속적으로 연결하지 않고 수행하도록 설계되었습니다. 로컬에서 처리함으로써 지연 시간이 감소하고 데이터 프라이버시가 향상되는 점이 의료, 금융, 제조 등 기밀성과 즉시성이 중요한 산업 분야에서 핵심적인 장점으로 부각됩니다. 예를 들어, 병원에서는 환자 데이터를 외부 서버로 전송하지 않고 현장에서 바로 분석함으로써 진단 속도를 높일 수 있고, 금융 기관에서는 거래 데이터의 실시간 위험 평가를 내부에서 수행함으로써 보안 위험을 최소화할 수 있습니다.
하지만 64 GB 통합 메모리 용량에는 한계가 있어 모델이 처리할 수 있는 컨텍스트 크기와 동시에 처리 가능한 요청 수에 제약이 있습니다. 광범위한 컨텍스트나 높은 동시성을 요구하는 애플리케이션에 대해서는 Nvidia가 여러 유닛을 상호 연결해 스케일 아웃할 것을 권장하고 있습니다. 이 방법은 성능을 향상시키지만 동시에 도입 비용과 인프라 복잡성도 증가시킨다는 점을 유념해야 합니다. 따라서 조직은 예상 워크로드와 성장 계획을 고려하여 단일 유닛으로 충분한지, 아니면 초기부터 멀티노드 구성을 염두에 두고 투자할지를 판단해야 합니다.
경쟁 제품과의 비교
로컬 AI용 하드웨어 시장에서는 소비자용 GPU나 특수 가속기를 기반으로 한 솔루션이 존재하지만, 가격이 더 높거나 소프트웨어 스택 통합도가 낮은 경우가 많습니다. DGX Spark는 고성능 하드웨어와 DGX OS, CUDA와 같은 최적화된 소프트웨어 스택을 결합해 제공함으로써 개발 팀이 시스템 통합에 소요되는 시간을 단축할 수 있는 가능성을 제공합니다. 4,999 USD라는 시작 가격은 일반적으로 8,000 USD를 초과하는 레퍼런스 시스템보다 낮은 가격대에 위치하지만, 실제 성능 비교는 워크로드의 특성에 따라 달라집니다. 따라서 구매 결정 시에는 단순히 가격만이 아니라, 제공되는 소프트웨어 지원, 업데이트 정책, 그리고 전체적인 생태계와의 호환성을 함께 평가하는 것이 중요합니다.
한국의 기업과 연구기관에게 DGX Spark 64 GB의 등장은 클라우드 서비스에 전적으로 의존하지 않고도 고급 AI 프로젝트를 실행할 수 있는 새로운 선택지를 제공합니다. 민감한 데이터를 자체 데이터센터에 보관함으로써 데이터 전송 비용을 절감하고, 데이터 트래픽에 따른 탄소 배출량을 낮출 수 있습니다. 또한 노드를 추가함으로써 단계적으로 확장할 수 있는 아키텍처는 예산과 리소스에 맞춘 유연한 도입 계획을 가능하게 하며, 핵심 비즈니스 프로세스에 AI 에이전트를 빠르게 통합하는 속도를 가속화할 것입니다. 이러한 장점은 특히 규제가 엄격한 분야에서 데이터 주권을 유지하면서도 최신 AI 기술을 활용하려는 조직에 큰 의미를 가집니다.
출처
- NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AINVIDIA · 2026년 10월 2일
- NVIDIA Announces DGX Spark 64GBMarkTechPost · 2026년 10월 2일