غوغل تطلق TPU Sync مفتوحة المصدر لنقل ذاكرة KV بين المعالجات
مكتبة TPU Sync مفتوحة المصدر من غوغل تنقل ذاكرة KV، أي ذاكرة العمل لنموذج اللغة، بين وحدات TPU وذاكرة المضيف، وتخفض زمن النقل بأكثر من 90%.
ذاكرة KV (ذاكرة المفتاح والقيمة) هي ذاكرة العمل التي يبنيها نموذج اللغة أثناء قراءة الطلب: فعن كل رمز (توكن) سبقت معالجته يحتفظ النموذج بقيم وسيطة حتى لا يعيد حسابها عند توليد كل كلمة جديدة. وكلما طالت المحادثة أو الوثيقة كبرت هذه الذاكرة، وهي توجد عادة في الذاكرة عالية النطاق الترددي (HBM) النادرة والمكلفة داخل شريحة المسرّع.
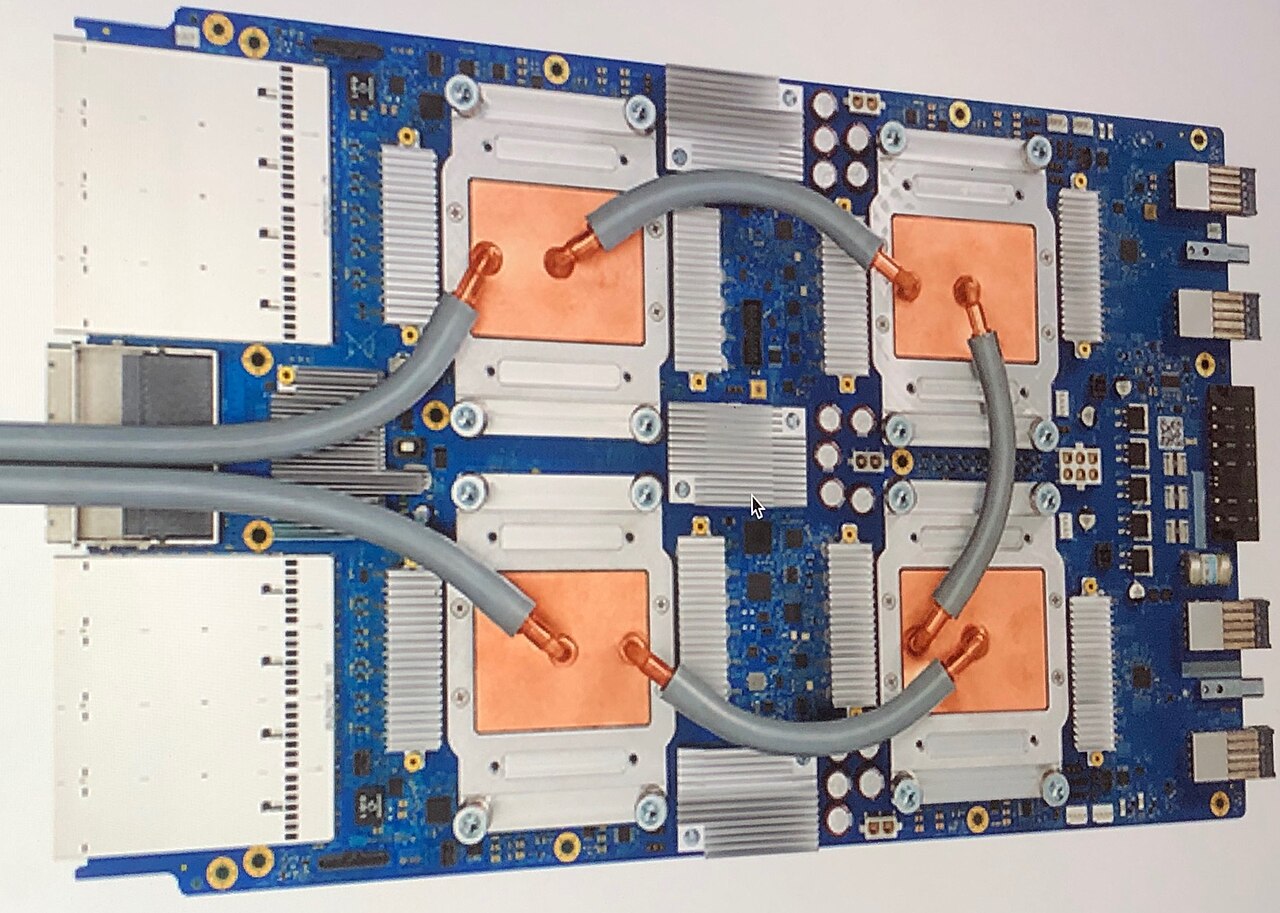
أطلقت غوغل الآن TPU Sync، وهي مكتبة أصلية بلغة C++ مفتوحة المصدر صُممت لنقل هذه الذاكرة وإدارتها بين معالجاتها TPU (وحدات معالجة التنسور). وبحسب موقع TechBytes الذي يلخّص تدوينة على مدونة Google Cloud كتبها المهندسان Fenghui Zhang وWeiren Yu، تزامن المكتبة أيضًا معاملات النماذج في مسارات التعلم المعزز. وتذكر SemiAnalysis أن TPU Sync كانت تُسمى سابقًا TPU-raiden، ويقدّم موقع Open Source For You المشروع باسم TPU Raiden تحت رخصة Apache 2.0.
لماذا تحتاج ذاكرة KV إلى الانتقال أصلًا؟
يمر استدلال نموذج اللغة بمرحلتين، كما يشرح Open Source For You: مرحلة الملء المسبق (prefill) التي يقرأ فيها النموذج الطلب كاملًا، ومرحلة فك الترميز (decode) التي يولّد فيها الإجابة رمزًا بعد رمز. ويشغّل الخدمة المفككة هاتين المرحلتين على مجموعتين منفصلتين من العتاد، ولذلك يجب إرسال ذاكرة KV بعد الملء المسبق إلى الشرائح المسؤولة عن فك الترميز. وتشير SemiAnalysis إلى أنه من دون مكتبة نقل تقتصر الخدمة الخارجية على TPU على النمط المجمّع، مع أن غوغل تمارس التفكيك داخليًا مع Gemini منذ سنوات.
والحاجة الثانية هي التفريغ. فحين لا تتسع HBM في شريحة لذاكرة جميع المستخدمين، تشرح SemiAnalysis أن البيانات يجب أن تنتقل من HBM إلى ذاكرة DRAM في المضيف ثم تعود. وقال مارك لوهماير، نائب الرئيس والمدير العام للبنية التحتية للذكاء الاصطناعي والحوسبة في غوغل، في مؤتمر هاتفي بحسب موقع The Next Platform بتاريخ 9 نوفمبر 2026، إن وحدات TPU في أحمال الوكلاء تبقى خاملة غالبًا جزءًا كبيرًا من الوقت. وأوضح أن TPU Sync تنقل ذاكرة العمل خارج الشريحة حين يتوقف الوكيل مؤقتًا وتعيدها حين يستأنف، فيتحرر المسرّع لمهام أخرى وتنخفض كلفة كل حمل وكيلي. ويضيف The Next Platform أن غوغل، لأن TPU Sync برمجية، تستطيع نقلها إلى أجيال أقدم من TPU.
ما الأداء الذي تعلنه غوغل؟
الأرقام التالية مصدرها TechBytes بتاريخ 9 نوفمبر 2026، وهو ينسبها إلى مدونة Google Cloud. لم نتمكن من قراءة تدوينة غوغل نفسها، ولذلك فهي أرقام أعلنتها الشركة المصنّعة ونقلها وسيط ثانوي.
- ينخفض زمن نقل المفتاح والقيمة بأكثر من 90% على نماذج Mixture of Experts مفتوحة الأوزان بين 235 و480 مليار معامل، بحسب TechBytes.
- ينخفض زمن الوصول إلى أول رمز (TTFT)، أي الانتظار قبل ظهور أول كلمة من الإجابة، بنسبة 90% في المتوسط في اختبارات التخزين المؤقت للبادئات والخدمة المفككة مقارنة بالإعدادات القياسية، بحسب TechBytes.
- يصل المكوّن raw_transfer إلى 223 جيجابايت في الثانية من الإنتاجية المجمّعة بين الجهاز والمضيف في الاتجاهين على مضيفات Ironwood TPU v7x، مقابل حد فيزيائي لواجهة PCIe Gen5 قدره 256 جيجابايت في الثانية، بحسب TechBytes.
- وعبر شبكة مركز البيانات، تحافظ البرمجية على نحو 192 جيجابت في الثانية على بطاقة شبكة واحدة سعتها 200 جيجابت و350 جيجابت في الثانية على بطاقتين مع توزيع واعٍ بـ NUMA، بحسب TechBytes.
كيف تعمل TPU Sync من الداخل؟
بحسب TechBytes، تعتمد TPU Sync على عمليات نقل بالوصول المباشر إلى الذاكرة (DMA، آلية عتادية تنسخ الذاكرة دون إشراك المعالج) تحافظ على تخطيط البيانات، مقرونة بتسمية مستعارة للمخازن في مكانها. وتتجنب المكتبة التسلسل في بايثون والنسخ الوسيطة بالعمل مباشرة مع مخازن PJRT في JAX وتنسورات PyTorch، وتجري عمليات النقل خارج رسم الترجمة في XLA. وتصف SemiAnalysis الفكرة نفسها بأنها عمليات نقل بلا نسخ تُنجز باستخراج واصفات العتاد الأصلية لمخازن PJRT.
ووفق TechBytes تتألف بيئة التشغيل من ثلاث وحدات. مخزن عام للمفتاح والقيمة يعمل كسجل يربط بصمات الطلبات بكتل تخزين فعلية ويدير إخلاء الأقل استخدامًا مؤخرًا. ومتحكم عنقودي يتولى التخطيط وإدارة عقود الاستخدام. ومدير ذاكرة محلي يتتبع حالة كتل الجهاز ويدير ذاكرة المضيف المثبتة ويحتفظ بنسخة إقلاع سريع في الذاكرة المشتركة تحت /dev/shm. ويمتد هرم الذاكرة من HBM إلى DRAM المثبتة في المضيف ثم أقراص SSD المحلية وGoogle Cloud Managed Lustre.
وعلى صعيد التكامل، يذكر TechBytes ارتباطات رسمية لـ PyTorch عبر TorchTPU ولـ JAX، وموصلًا لمحركات الخدمة vLLM وSGLang وllm-d، ودوال منخفضة المستوى لمسارات Pathways وJAX متعدد المتحكمات.
ما الحدود وما مستوى النضج؟
يقول TechBytes إن عمليات النقل بين HBM وDRAM في المضيف جاهزة للإنتاج، بينما لا يزال التخزين المتدرج نحو أنظمة مشتركة مثل Managed Lustre وخلفيات POSIX الخارجية قيد التحقق التجريبي. ووحدة مزامنة الأوزان للتعلم المعزز تجريبية أيضًا، وبلوغ أقصى إنتاجية للشبكة يتطلب بطاقتي شبكة سعة 200 جيجابت مضبوطتين بتوزيع واعٍ بـ NUMA. أما Open Source For You، ومقاله بلا تاريخ، فيذهب أبعد ويصف المشروع بأنه لا يزال قيد التطوير النشط وغير مخصص بعد للاستخدام العام في الإنتاج، فصورة النضج تختلف بين المصادر.
وتضيف SemiAnalysis زاوية تنافسية. فمعاينتها لمقياس InferenceX تقارن TPU v7 المجمّعة بشريحتي Nvidia B200 وB300 المجمّعتين، وتقول إن نظامي GB200 وGB300 NVL72 من Nvidia يتصدران حاليًا جزءًا من المنحنى في الخدمة المفككة. ومقارنة مع TPU v7 المفككة مقررة بعد تحسين التفكيك القائم على TPU-Sync في المنظومة الخارجية، وتتوقع SemiAnalysis أن يُبنى دعم Mooncake Store على TPU فوق دوال TPU-Sync.
ماذا يتغير بالنسبة إلى شركة في المنطقة؟
بالنسبة إلى شركة عربية تشغّل أو تستأجر مساعدين ووكلاء بسياق طويل على Google Cloud، يصبح نقل ذاكرة KV أمرًا يُضبط بدل أن يُبنى. والخطوات العملية هي اختبار الموصل مع vLLM أو SGLang على طلباتها الخاصة، وقياس الزمن حتى أول رمز قبل التفعيل وبعده، والتحقق من الطبقات التي لا تزال موسومة بأنها تجريبية قبل الاعتماد عليها. وعلى الفرق التي تدرّب بالتعلم المعزز أن تتحقق من وحدة مزامنة الأوزان على طوبولوجيات المدرّبين والمُعاينين لديها. ولا يغني أي من الأرقام المنشورة عن اختبار على حمل العمل الخاص بكم.
المصادر
- Google introduces TPU Sync: Fast KV cache and weight transferTechBytes · ٩ نوفمبر ٢٠٢٦
- Google Rejiggers TPU Accelerators For Broader AI Inference WorkThe Next Platform · ٩ نوفمبر ٢٠٢٦
- What Is TPU-Sync?SemiAnalysis InferenceX
- Library Optimises TPU InferenceOpen Source For You