安全とリスク韓国
Project Lily:ChatGPT 会話を人間が検閲するリスクとプライバシーへの影響
OpenAI は内部文書と外部報道に基づき、数百人の契約社員が ChatGPT の実際の会話を評価する「Project Lily」プログラムを運用していることが明らかになった。本稿ではその仕組みとプライバシー上の懸念を整理する。
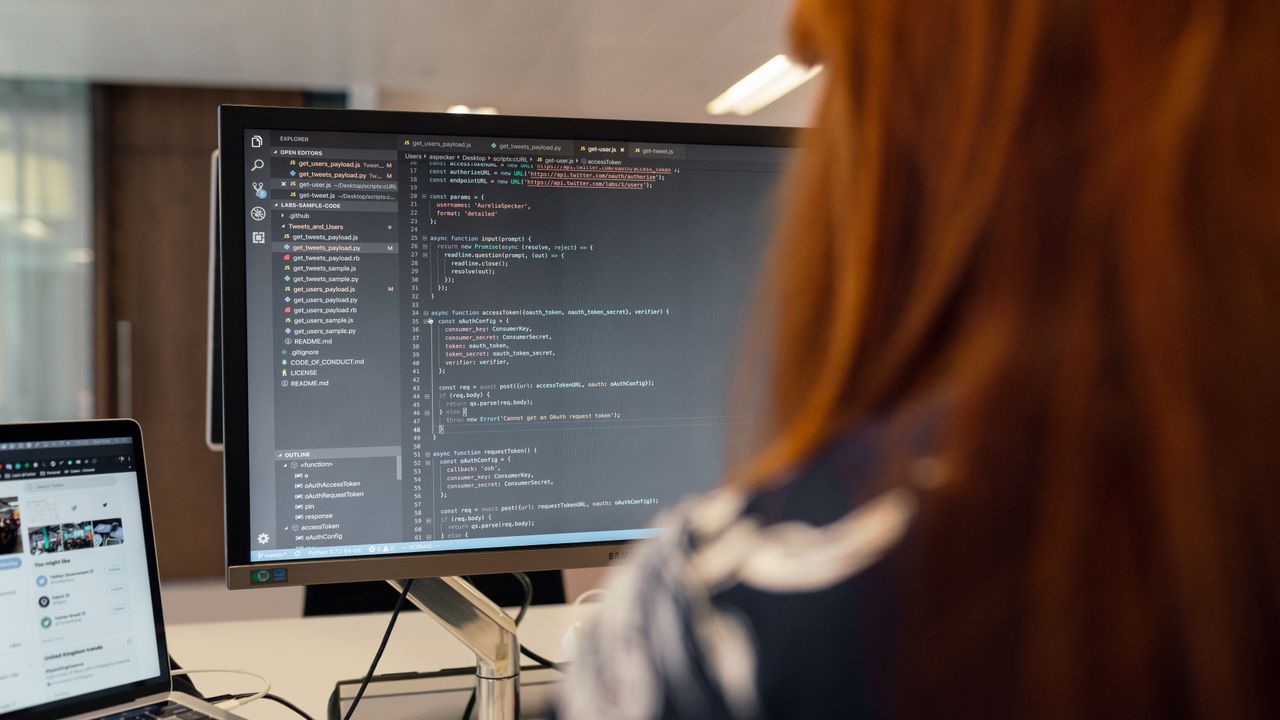
Project Lily の概要 OpenAI は 2026 年 9 月 14 日付けの 404 Media の報道によれば、数百人規模の契約社員を雇用し、実際のユーザーリクエストと生成された回答を閲覧・評価するプログラムを実施している。評価者はユーザーの意図を要約し、複数の回答を点数化・批評することで、モデルの自然さや過剰な擬人化を抑制する指針に従う。
データ処理の流れとフィルタリング OpenAI はユーザー名を除去し、会話テキストを「Privacy Filter」と呼ばれるフィルタに通すと説明している。しかし、フィルタは個人情報や機密情報を完全に除去できる保証はなく、職場のプロジェクト名や居住地域といった感度の高い情報が残る可能性が指摘されている。
人間評価の具体的作業 評価者は以下の手順で作業を行う。 1. 原文リクエストと全会話履歴を閲覧 2. ユーザーの意図を簡潔に要約 3. 各回答の適切性、自然さ、リスクを点数付け 4. 改善点や問題点をコメントとして記録 このプロセスは、モデル改善のためのデータとして内部に蓄積される。
- **擬似匿名化**:名前は削除されても、文脈情報から個人を特定できる場合がある。
- **完全匿名化の欠如**:フィルタはデータ最小化を目指すが、機密情報が通過するケースが報告されている。
- **同意の不明確さ**:ユーザーはデフォルトでデータ共有に同意しているが、オプトアウト手段は限定的。
- **人間の介在**:自動化されたフィルタだけでなく、実際に人がテキストを読むことでプライバシー侵害のリスクが増大する。
設定とオプトアウトの現状 Tom's Guide の報道によれば、個人向けアカウント(Free、Plus、Pro)はデフォルトで「モデル改善」に参加している。一方、Enterprise、Business、Edu アカウントはデフォルトでオフとなっている。設定画面の「Improve the model for everyone」オプションは、将来の会話にのみ適用され、過去に送信されたデータは除外されない。
法的・倫理的観点からの考察 プライバシー保護の観点で重要なのは、**匿名化**と**擬似匿名化**の違いを明確に認識することだ。匿名化は個人識別が不可能になるが、擬似匿名化は再識別の可能性が残る。OpenAI が提供するフィルタは後者に該当し、完全な匿名化を保証しない。また、ユーザーが明示的に同意したかどうかは設定画面の説明に依存し、情報提供の透明性が問われる。
- アカウント設定で「Improve the model for everyone」をオフにする。
- 機密情報や個人情報を含む質問は避け、一般的な質問に留める。
- 企業や教育機関は Enterprise / Business アカウントを利用し、データ共有を制限する。
- 定期的にプライバシーポリシーの更新情報を確認し、変更点を把握する。
今後の展望と課題 OpenAI はフィルタリング技術の改善と人間評価の透明性向上を掲げているが、実際にどの程度の情報が残っているかは外部からは測りにくい。業界全体で「データ最小化」と「人間の介在」のバランスをどう取るかが、AI 安全性とプライバシー保護の鍵となるだろう。
Project Lily の実態は、AI の性能向上とユーザーのプライバシー保護の間にあるジレンマを浮き彫りにしている。利用者は設定を見直し、機密情報の取り扱いに注意を払うことで、リスクを最小限に抑えることができる。
出典
- Inside ‘Project Lily’: The Humans Reading Your ChatGPT Chats404 Media · 2026年9月14日
- OpenAI paid contractors to read ChatGPT conversations — here's how to protect yourselfTom's Guide · 2026年9月14日