ذكاء اصطناعي من برينستون يتعلم آلاف الكلمات من تسجيلات الأطفال
نُشرت في مجلة «ساينس» بتاريخ 5 نوفمبر 2026 دراسة من برينستون دربت ذكاءً اصطناعياً لكل طفل على نحو 1000 يوم من التسجيلات المنزلية، وكانت الإعادة الليلية هي المفتاح.
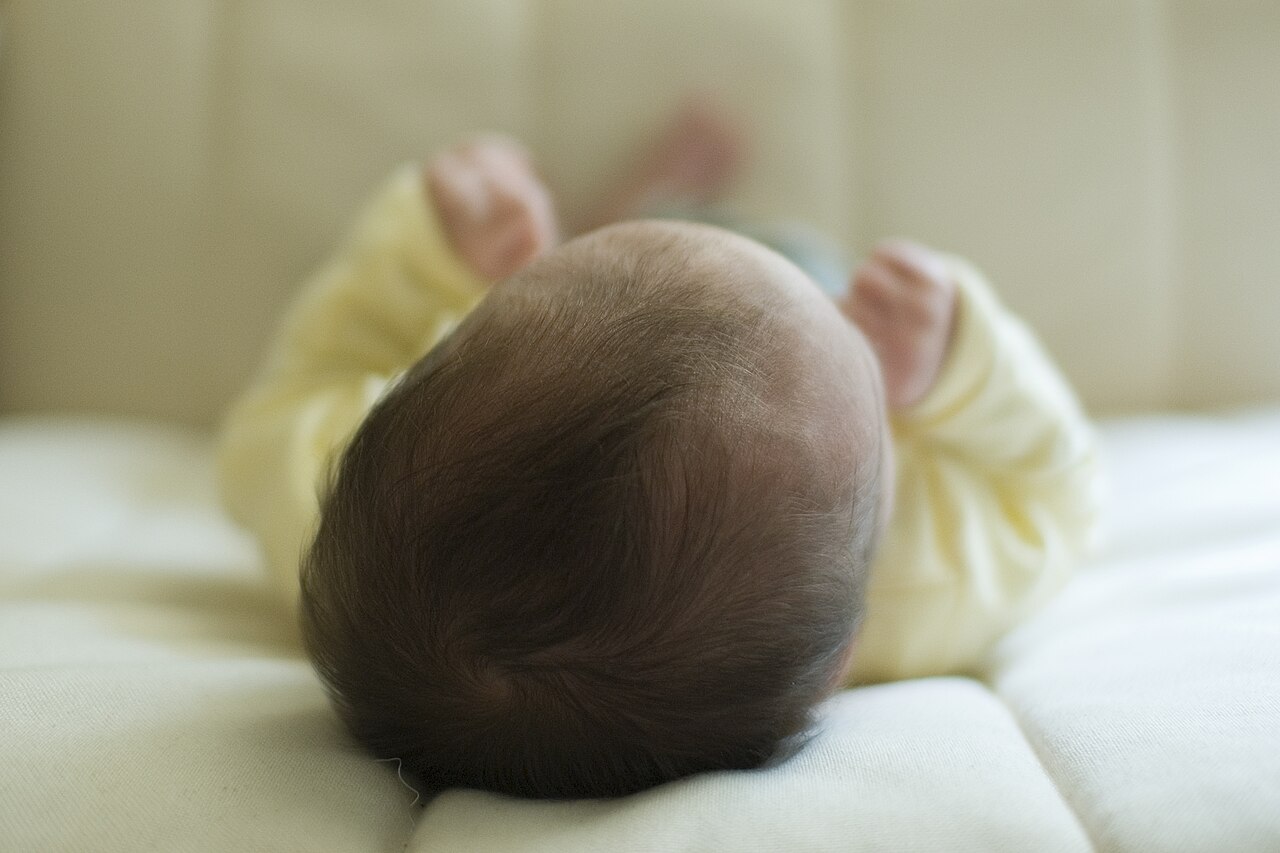
درّب باحثون في جامعة برينستون نماذج ذكاء اصطناعي على تعلّم الكلمات المنطوقة كما يفعل الأطفال: يوماً بعد يوم، من الكلام الذي يُسمع في البيت. وبحسب بيان صحفي لبرينستون وزّعه موقع EurekAlert، نُشرت الدراسة في مجلة «ساينس» (Science) في 5 نوفمبر 2026، وتتابع نحو الأيام الألف الأولى من حياة أطفال سُجّلوا في منازلهم. وتناولها موقع SingularityHub في 12 نوفمبر، وتناولها الموقع البرتغالي Pplware في 14 نوفمبر.
النموذج هنا هو شبكة عصبية: برنامج مكوَّن من طبقات من وحدات حسابية بسيطة تُضبط الروابط بينها أثناء التدريب. والإعادة (replay) هي التقنية التي تقع في قلب الدراسة. ففي نهاية كل يوم محاكى، يسمع النموذج من جديد عيّنة من الكلام الذي سمعه من قبل، وهي فكرة مستوحاة من الطريقة التي يُعتقد أن النوم يثبّت بها الذكريات في الدماغ، بحسب SingularityHub.
ما البيانات التي جمعها الباحثون؟
بحسب برينستون، سُجّل 17 رضيعاً من 15 أسرة في ولاية نيوجيرسي خلال سنواتهم الثلاث الأولى، وتشمل التحليلات 8 من هؤلاء الأطفال. ويذكر EurekAlert أن 1.2 مليون ساعة من البيانات جُمعت على مدى نحو 1000 يوم. ويضيف SingularityHub أن في كل منزل ما بين 4 و14 جهازاً تعمل نحو 12 ساعة يومياً، وأن الآباء احتفظوا بحق سحب التسجيلات أو حذفها ضمن إطار أخلاقي صممه الفريق.
وبعد إزالة الضوضاء وفترات الصمت الطويلة والمحادثات المتداخلة، احتفظ الفريق بما يصل إلى 6600 ساعة من الصوت لكل طفل لتدريب نموذج خاص به، بحسب SingularityHub. وللمقارنة، يشير الموقع نفسه إلى أن نماذج اللغة الكبيرة، وهي الأنظمة التي تقف خلف روبوتات الدردشة، تحتاج إلى مليارات الكلمات من النصوص.
لماذا احتاج النموذج إلى ليلة من الإعادة؟
بحسب SingularityHub، بدأ كل نموذج من الصفر: بلا قائمة بأصوات اللغة الإنجليزية، وبلا أي إشارة إلى أين تنتهي الكلمة وأين تبدأ التي تليها. وكان يتألف من جزأين: مرمّز صوتي يقطّع الكلام إلى شرائح مدة كل منها 20 ملي ثانية، ومفكّك تنبؤي دُرّب على توقع الأصوات التالية. وتشرح برينستون أن النموذج تلقى كلام الطفل يوماً بيوم وبالترتيب، بدلاً من البيانات المخلوطة التي تُستخدم لبناء الشبكات العصبية المعتادة.
وكانت النتائج الأولى مخيبة للآمال. فقد قالت هداس راڤيڤ (Hadas Raviv)، عالمة الإدراك الحاسوبي في برينستون، إن تعريض النموذج لتدفق الكلام اليومي وحده لم يكن كافياً، بحسب SingularityHub. وغيّرت إضافة مرحلة إعادة في نهاية كل يوم محاكى النتيجة. وتلخّص برينستون ما يحتاج إليه النموذج: يوماً كاملاً من الكلام، يوماً بعد يوم، وليلة لإعادته.
ماذا تعلّم الذكاء الاصطناعي، وبأي سرعة؟
- بحسب SingularityHub، اكتسبت النماذج بفضل الإعادة أولاً الفونيمات، وهي وحدات الصوت الأساسية في اللغة، ثم الكلمات المتكررة.
- بحسب SingularityHub، تعلمت النماذج لدى الأطفال الثمانية نحو 37 فونيماً خلال 15 شهراً، وبدأت تتعرف على الكلمات قبل سن الثانية، بوتائر مختلفة جداً.
- بحسب SingularityHub وPplware، بلغ معجم النظير الاصطناعي لكل طفل آلاف الكلمات عند نحو 1000 يوم.
- بحسب برينستون عبر EurekAlert، حصل الفريق، بضبط معاملات مثل مقدار التكرار أثناء الإعادة وسرعة المعالجة، على مسارات لفهم الكلمات تطابق مسار كل طفل.
وتؤكد برينستون سبب أهمية ذلك: فعلم النفس اعتمد إلى حد بعيد على المتوسطات، ونموذج يتابع كل طفل على حدة يفتح الباب لدراسة النمو طفلاً طفلاً. ويضيف البيان أن النموذج تعلّم فهم اللغة في كل منزل رغم الفروق الكبيرة في الكلام الذي تعرّض له الأطفال.
ما حدود هذه الدراسة؟
يشدد الباحثون على أن الذكاء الاصطناعي لا يتعلم تماماً كما يتعلم الرضيع. فبحسب Pplware، يعتمد الأطفال أيضاً على الإشارات البصرية والإيماءات والتفاعل الاجتماعي. ويضيف SingularityHub أن النموذج تعلّم من الصوت وحده، ولا يعالج المعلومات بالطريقة المتوازية والموفّرة للطاقة التي تعمل بها الخلايا العصبية. أما أي سمات النموذج تعكس تعلّم الرضيع الحقيقي وأيها مجرد اختصارات حسابية فلا يزال أمراً يجب تمييزه، بحسب الموقع نفسه. كما تصف المصادر التي قرأناها عيّنة محدودة، هي 8 أطفال من منازل في نيوجيرسي، ولذلك لم يثبت تعميم النتيجة على لغات أو بيئات أخرى.
ما فائدة هذا البحث؟
بحسب EurekAlert، يريد فريق برينستون استخدام النموذج لاختبار أثر النوم الأكثر أو الأقل، أو أثر أنواع مختلفة من الكلام مثل التلفزيون، ويأمل في تشخيص صعوبات التعلم على نحو أفضل بفهم كيف يتعلم الدماغ المعتاد اللغة. وقالت راڤيڤ إن الهدف، خلافاً لكثير من الذكاء الاصطناعي الحديث الذي يسعى إلى أداء يفوق البشر، هو فهم كيف يتعلم البشر.
ويضيف Pplware وSingularityHub أن هذا النهج قد يلهم نماذج ذكاء اصطناعي أكثر كفاءة تتعلم من بيانات أقل. وهذه فرضية وليست نتيجة للدراسة: فلا يذكر أي من المصدرين توفيراً مقيساً في البيانات أو الطاقة. وكتبت زارا هارمون وكارولين رولاند من معهد ماكس بلانك للغويات النفسية، ولم تشاركا في الدراسة، أن مثل هذه الأعمال تتيح نمذجة التعلم في ظروف أكثر واقعية باطراد، بحسب SingularityHub.
ماذا يتغير بالنسبة إلى الشركات؟
بالنسبة إلى شركة في العالم العربي، لا شيء مما ورد هنا منتج بعد: فالنموذج أداة بحثية وليس خدمة. وثمة ثلاث نقاط تستحق الانتباه. أولاً، يمكن للفرق التي تبني مساعدات صوتية أو تطبيقات لتعلّم اللغات أو أدوات صحية تعتمد على الصوت أن تسجّل مبدأ الإعادة، الذي يوحي بالتدريب على تدفق متصل مع مراجعة دورية بدلاً من الاكتفاء بمدونات ضخمة مخلوطة؛ وهذا لا يزال بحاجة إلى التحقق خارج المختبر.
ثانياً، البيانات. فالتسجيلات المنزلية المتواصلة للأطفال الصغار تطلبت إطاراً يتيح للآباء سحب بياناتهم أو حذفها، وهو مرجع مفيد لأي شركة تعالج بيانات صوت الأطفال وفق قواعد حماية البيانات. ثالثاً، ما زالت الوعود بانخفاض استهلاك الطاقة غير مثبتة حالياً، ولا ينبغي إدخالها في دراسة جدوى قبل نشر نتائج مقيسة.
المصادر
- Princeton researchers train an AI model to learn language the way children doEurekAlert (Princeton University) · ٥ نوفمبر ٢٠٢٦
- This AI Learned Language From the Recordings of a Baby’s First 1,000 DaysSingularityHub · ١٢ نوفمبر ٢٠٢٦
- Esta IA aprendeu milhares de palavras apenas a ouvir um bebé durante 1000 diasPplware · ١٤ نوفمبر ٢٠٢٦