Vals lève 40 M$ en série A pour créer des benchmarks IA basés sur des tâches concrètes
Vals, créée en 2024, a levé 40 millions de dollars en série A menée par Andreessen Horowitz après un tour d’amorçage avec 8VC et Bloomberg Beta, et veut remplacer les anciens benchmarks publics par des évaluations confidentielles couvrant le droit, la finance, la programmation, la cybersécurité, la santé mentale, la biosécurité et le droit des conflits armés.
Vals sécurise une levée de fonds de série A de 40 millions de dollars pour redéfinir le benchmarking de l'IA
Au début de 2024, Vals a annoncé la clôture d'une levée de fonds de série A qui a permis de récolter 40 millions de dollars. Le tour a été mené par Andreessen Horowitz, à la suite d'une première levée de fonds seed organisée par 8VC et Bloomberg Beta. Cette injection de capital représente une étape importante pour une entreprise fondée seulement quelques mois auparavant, et elle fournit le socle financier nécessaire à l'ambition de la société de refondre la manière dont les systèmes d'intelligence artificielle sont évalués.
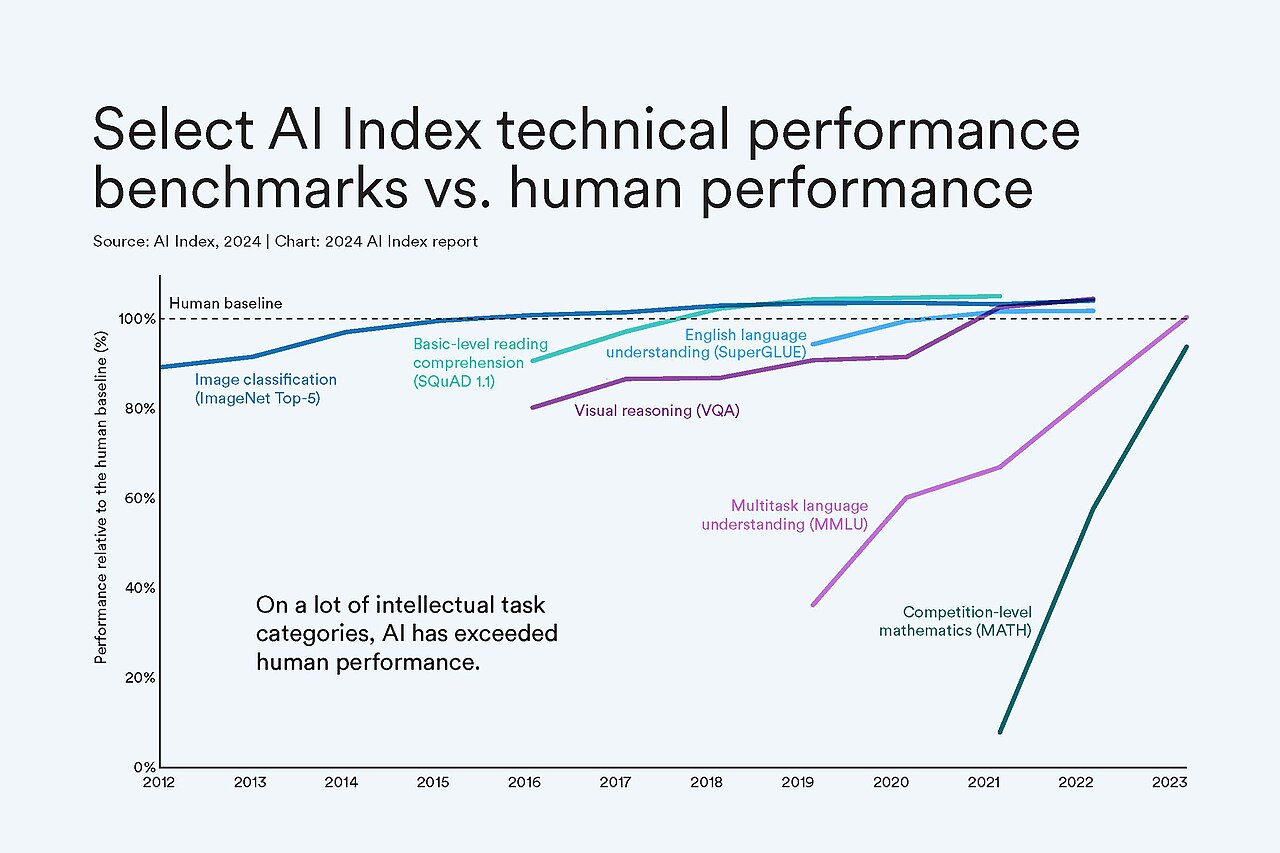
La motivation principale de la campagne de financement de Vals est de remplacer ce que l'entreprise qualifie d'« anciens benchmarks publics » par une nouvelle classe d'évaluations. Selon Vals, de nombreux benchmarks existants souffrent de contamination des données, c'est‑à‑dire que les jeux de données utilisés pour l'évaluation ont déjà pu être intégrés aux pipelines d'entraînement des modèles de pointe. En maintenant les matériaux d'évaluation confidentiels, Vals vise à créer un environnement de test isolé de ce type de fuite, offrant ainsi une image plus claire des véritables capacités d'un modèle.
Des examens abstraits aux tâches du monde réel
Rayan Krishnan, le fondateur de Vals, a formulé une philosophie précise concernant ce qui constitue un benchmark pertinent. Il soutient qu'un benchmark doit vérifier si un modèle peut produire un travail de qualité humaine dans un domaine concret, plutôt que de simplement réussir à un examen abstrait à choix multiples. Cette perspective oriente le choix des catégories de tâches que Vals mesure actuellement, parmi lesquelles le droit, la finance, la programmation, la cybersécurité, la santé mentale, la biosécurité et le droit des conflits armés.
Chacun de ces domaines représente un ensemble distinct de normes professionnelles et de cadres réglementaires. En se concentrant sur des tâches telles que la rédaction d'arguments juridiques, la réalisation d'analyses de risque financier, l'écriture de code de production, l'identification de menaces cybernétiques, la production de scripts de conseil en santé mentale, l'évaluation de protocoles de biosécurité ou l'interprétation du droit des conflits armés, Vals cherche à saisir des dimensions de performance directement pertinentes pour les utilisateurs finaux et les parties prenantes.
Modèle économique et adoption du marché
Vals fonctionne selon un modèle business‑to‑business où les développeurs de modèles d'IA paient la société pour faire évaluer leurs systèmes au regard de ses tâches propriétaires. Les scores ainsi obtenus sont ensuite mis à disposition des acheteurs potentiels, qui peuvent les utiliser pour comparer les systèmes concurrents selon des critères pertinents pour les déploiements réels. Cette structure à double face crée une incitation pour les fournisseurs de modèles à démontrer leur compétence sur les tâches de Vals tout en offrant aux acheteurs un outil de décision plus nuancé.
L'entreprise indique que son chiffre d'affaires a été multiplié par huit au cours de l'année écoulée, une affirmation qui coïncide avec l'expansion rapide de sa base de clients. Parallèlement, Vals a fait passer son effectif de huit à vingt‑cinq employés et a annoncé son intention de recruter dix à quinze personnes supplémentaires dans un avenir proche. Ces chiffres suggèrent une corrélation entre l'afflux de capitaux, l'adoption de ses services d'évaluation et la croissance organisationnelle.
Parmi les premiers adoptants des évaluations de Vals figurent plusieurs agences fédérales des États‑Unis. La société a lancé un programme d'évaluation dédié à ces agences, indiquant que sa méthodologie est envisagée dans des contextes d'appels d'offres officiels et de conformité. Cette évolution pourrait témoigner d'un intérêt gouvernemental plus large pour des métriques de performance d'IA standardisées et basées sur des tâches.
Transparence, indépendance et reproductibilité
Vals publie à la fois les résultats de ses évaluations et les méthodologies sous‑jacentes sur son site public. Cette démarche vise à offrir de la visibilité sur la manière dont les scores sont calculés et à permettre à des tiers d'examiner le processus. Toutefois, l'indépendance de l'entreprise doit encore être scrutée, notamment parce que les entités qui financent les évaluations sont aussi les sujets de ces évaluations.
Le potentiel conflit d'intérêts découle du fait que les développeurs de modèles paient Vals pour les tests, ce qui pourrait influencer la perception d'impartialité des résultats. Bien que Vals affirme que ses méthodes sont robustes, la reproductibilité de ses résultats par des chercheurs indépendants reste une question ouverte, les matériaux d'évaluation étant eux‑mêmes gardés confidentiels.
- Les matériaux de test confidentiels réduisent le risque de fuite de données d'entraînement
- Le modèle de revenu lie les frais d'évaluation aux développeurs de modèles
- Les résultats sont partagés avec les acheteurs pour une analyse comparative
- La divulgation publique des méthodes vise à renforcer la transparence
La confidentialité des jeux de test est une arme à double tranchant. D'une part, elle protège l'intégrité de l'évaluation en empêchant les modèles de sur‑ajuster des données déjà connues. D'autre part, elle limite la capacité des auditeurs tiers à reproduire les tests, ce qui pourrait affecter la confiance accordée aux scores rapportés.
Un autre point d'incertitude concerne la scalabilité de la suite de tâches de Vals. Si l'ensemble actuel de domaines couvre un large spectre d'activités professionnelles, étendre le cadre à d'autres secteurs — comme l'éducation, les transports ou la surveillance environnementale — pourrait nécessiter de nouvelles conceptions de tâches, une expertise disciplinaire supplémentaire et éventuellement des protocoles de confidentialité distincts.
L'expansion rapide du personnel de l'entreprise soulève également des questions sur la durabilité de son modèle opérationnel. Recruter dix à quinze employés supplémentaires suggère un besoin accru d'évaluateurs, d'ingénieurs de données et d'experts sectoriels, mais la demande à long terme pour de telles évaluations spécialisées dépendra de la mesure dans laquelle l'industrie adoptera le benchmarking basé sur les tâches.
En regardant vers l'avenir, l'approche de Vals pourrait influencer les normes plus larges du secteur. Si ses évaluations confidentielles et orientées tâches gagnent en acceptation tant auprès des entreprises privées que des agences publiques, elles pourraient devenir un point de référence pour de futurs cadres réglementaires cherchant à garantir que les systèmes d'IA atteignent des seuils de performance concrets.
Néanmoins, l'impact ultime de la méthodologie de Vals dépendra de plusieurs facteurs encore non résolus : la capacité des chercheurs indépendants à vérifier les résultats sans accès au contenu des tests, la volonté des développeurs de modèles de continuer à payer pour des évaluations propriétaires, et le degré d reliance des acheteurs sur ces scores dans leurs décisions d'achat. Chacune de ces variables pourrait déterminer si le modèle de Vals devient un paradigme dominant ou reste un service de niche pour des applications spécialisées.
Sources
- Vals, backed by Andreessen Horowitz, is looking to become the gold standard for AI benchmarkingTechCrunch · 19 septembre 2026
- Independent Evaluation, Unbiased BenchmarksVals AI · 21 septembre 2026