VN en Google lanceren Data Commons voor AI‑agents met eenduidige statistieken
Op 17 september 2026 onthulden de Verenigde Naties en Google de UN System Data Commons, een kennisgrafiek die statistieken van 26 VN‑agentschappen bundelt en AI‑analyse voor beleidsmakers en onderzoekers vereenvoudigt.
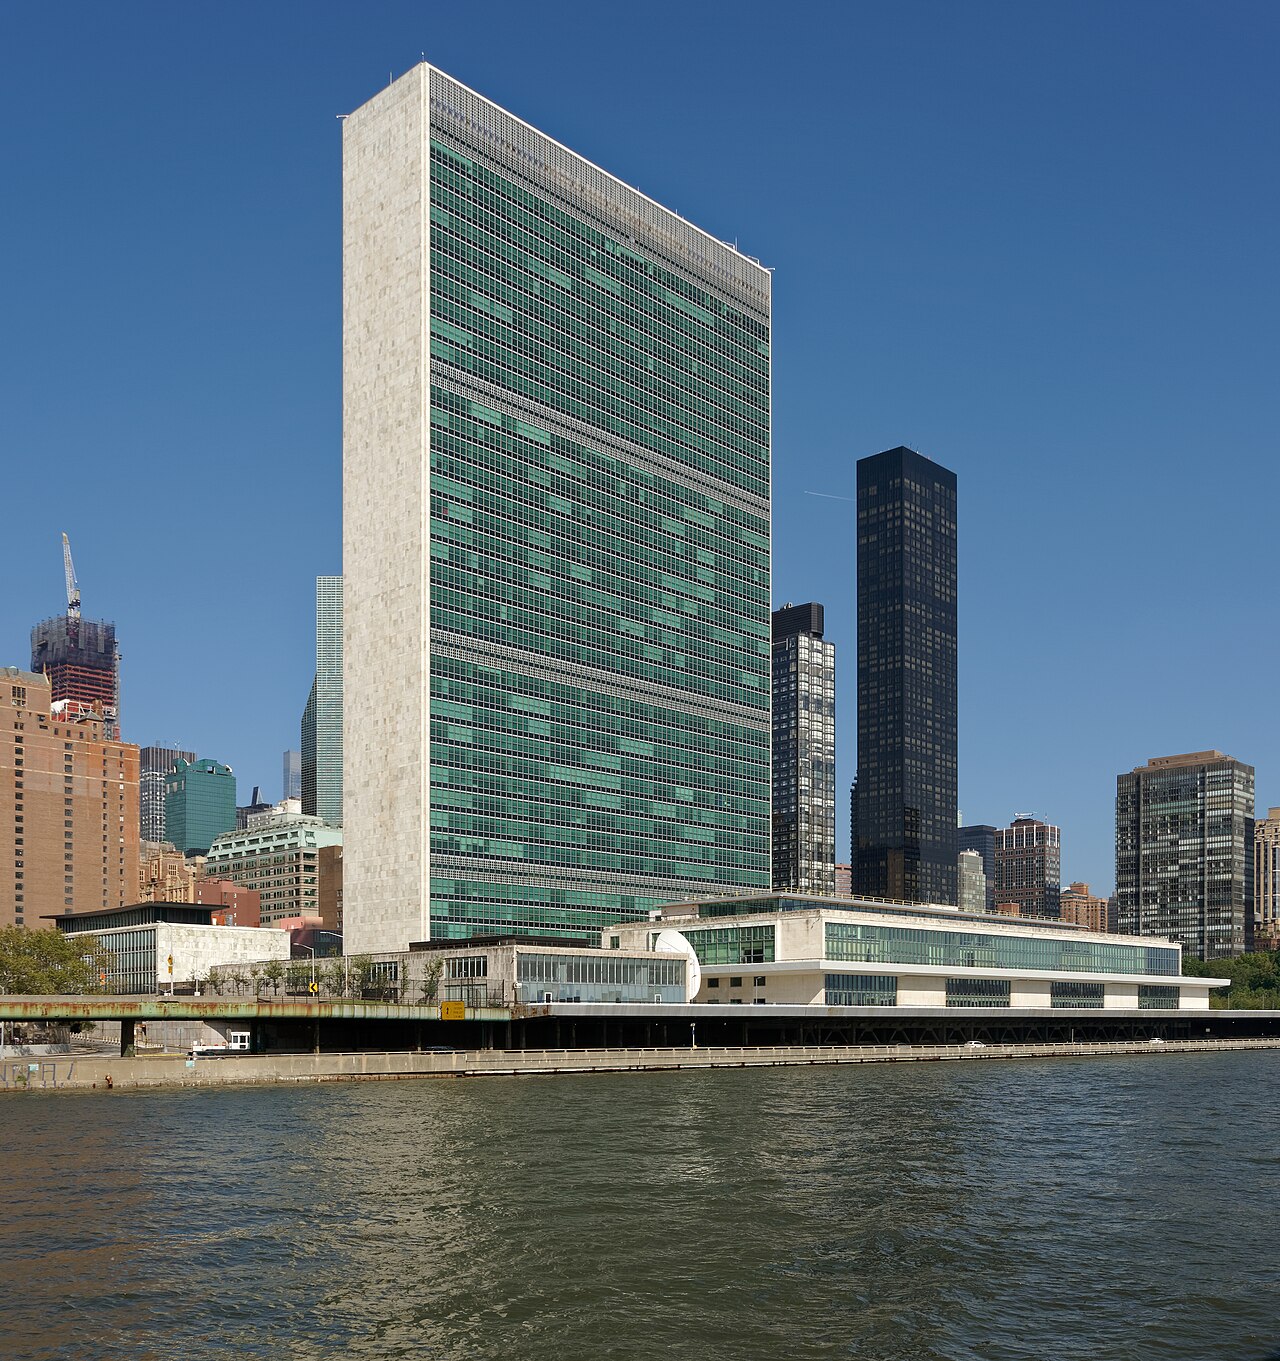
De UN System Data Commons ging op 17 september 2026 live, een gezamenlijk initiatief van de Verenigde Naties en Google om wereldwijde statistische gegevens direct toegankelijk te maken voor kunstmatige‑intelligentie‑agents.
Bij de lancering hadden ongeveer twintig van de zesentwintig deelnemende VN‑agentschappen al datasets bijgedragen, waardoor één doorzoekbare kennisgrafiek ontstond die de noodzaak elimineert om incompatibele spreadsheets handmatig te reconciliëren.
Gestandaardiseerde indicatoren, perioden en geografische eenheden
Alle indicatoren, rapportageperioden en geografische definities zijn gestandaardiseerd op het platform. Deze harmonisatie maakt het mogelijk dat een AI‑agent water‑toegangsstatistieken kan vergelijken met school‑aanwezigheidspercentages zonder handmatige data‑opschoning.
Het platform ondersteunt ook natuurlijke‑taalvragen, zodat gebruikers vragen kunnen stellen als “Wat is de gemiddelde levensverwachting in Sub‑Sahara Afrika in 2025?” en antwoorden ontvangen die rechtstreeks uit geverifieerde VN‑statistieken komen.
Interactieve verkenning en visualisatie
Naast tekstuele antwoorden biedt Data Commons thema‑gebaseerd browsen en locatie‑georiënteerde navigatie, aangevuld met interactieve visualisaties die in realtime worden bijgewerkt wanneer gebruikers hun zoekopdrachten verfijnen.
- Integratie van 80 % van de VN‑statistische datasets tegen 2027
- Uitbreiding van bijdragen van alle 26 VN‑agentschappen
- AI‑agents in staat stellen automatisch multidomein‑rapporten te genereren
- Handhaving van VN‑geleide governance en verdere ontwikkeling van het platform
De gestandaardiseerde structuur van de UN System Data Commons biedt een solide basis voor het automatiseren van analytische workflows, maar er blijven inherente beperkingen die voortvloeien uit de onderliggende data‑modelkeuze. Omdat alle indicatoren, tijdreeksen en geografische eenheden volgens een uniforme taxonomie worden gepresenteerd, kan een AI‑agent eenvoudig correlaties leggen tussen ogenschijnlijk ongerelateerde domeinen. Deze homogeniteit vereist echter dat elke bron zich strikt houdt aan de vooraf gedefinieerde metadata‑schema’s; afwijkingen of ontbrekende attributen leiden tot dataverlies of tot het genereren van incompleet geaggregeerde resultaten. Bovendien kan de abstractie die voortkomt uit een enkele kennisgrafiek de nuance van contextspecifieke definities onderdrukken, waardoor beleidsanalyses die sterk afhankelijk zijn van lokale interpretaties extra validatie‑stappen nodig hebben om de betrouwbaarheid te waarborgen.
Hoewel het platform natuurlijke‑taalvragen ondersteunt, moet de kwaliteit van de gegenereerde antwoorden voortdurend worden geverifieerd door menselijke experts. De AI‑agent interpreteert de semantiek van een vraag en zoekt naar de best passende dataset binnen de grafiek; fouten in de interpretatie kunnen leiden tot het selecteren van een onjuiste tijdsperiode of een verkeerd geografisch aggregatieniveau. Daarom is een systematisch verificatieproces onontbeerlijk: resultaten moeten worden getraceerd naar de bron‑datasets, en eventuele discrepanties moeten worden gemeld en gecorrigeerd. Deze audit‑trail is cruciaal om het vertrouwen van beleidsmakers te behouden, vooral wanneer de output wordt gebruikt voor besluitvorming op nationaal of regionaal niveau.
De real‑time visualisatie‑component versterkt de bruikbaarheid van de Data Commons, maar brengt ook technische uitdagingen met zich mee die de operationele stabiliteit kunnen beïnvloeden. Interactieve kaarten en grafieken worden dynamisch bijgewerkt op basis van de laatste query‑resultaten, wat betekent dat de onderliggende compute‑infrastructuur voldoende schaalbaar moet zijn om piekbelastingen te verwerken. Als de responstijd vertraagt, kan dit de gebruikerservaring aantasten en de adoptie van AI‑ondersteunde analyses belemmeren. Bovendien moeten visualisatie‑algoritmen zorgvuldig worden geconfigureerd om misleidende interpretaties te voorkomen; bijvoorbeeld, het kiezen van ongeschikte schaalverdelingen of kleurenschema’s kan de perceptie van trends vervormen, waardoor beleidsadviezen op een onjuiste basis worden gebouwd.
Een ander praktisch aspect betreft de integratie van bestaande workflows binnen onderzoeks‑ en beleidsinstellingen. De mogelijkheid om één natuurlijke‑taalvraag te stellen en direct een bruikbare dataset te ontvangen, vermindert de tijd die traditioneel wordt besteed aan data‑extractie en -sanitatie. Desondanks blijft er een leercurve voor gebruikers die gewend zijn aan conventionele data‑managementtools; zij moeten vertrouwd raken met de query‑syntaxis, de beperkingen van de gestandaardiseerde indicatoren en de manier waarop de AI‑agent ambiguïteit oplost. Training en documentatie moeten daarom worden geïntegreerd in de adoptiestrategie, zodat de efficiëntiewinst niet teniet wordt gedaan door onjuiste interpretaties of onvolledige queries.
De governance‑structuur die de VN heeft opgezet voor de Data Commons is bedoeld om de integriteit en transparantie van de gegevens te waarborgen, maar het vereist continue monitoring en periodieke evaluatie. Het platform moet voldoen aan de richtlijnen voor dataprivacy en -sovereignty, vooral wanneer gevoelige of subnationaal gesegmenteerde statistieken worden verwerkt. Een mechanisme voor externe audit, waarbij onafhankelijke entiteiten de algoritmische beslissingen van de AI‑agent kunnen beoordelen, versterkt de verantwoording. Bovendien moet er een feedback‑lus bestaan waarin gebruikers problemen kunnen melden, zodat verbeteringen systematisch kunnen worden doorgevoerd en de kwaliteit van de kennisgrafiek op lange termijn behouden blijft.
Ten slotte heeft de beschikbaarheid van een eenduidige, AI‑vriendelijke dataset verstrekkende praktische consequenties voor de beleidsvorming. Door de tijdsbesparing bij data‑voorbereiding kunnen onderzoekers zich meer richten op diepgaande analyse, scenario‑modellering en het formuleren van evidence‑based aanbevelingen. Dit versnelt de beleidscyclus en maakt het mogelijk om sneller te reageren op opkomende crises of trends. Echter, de afhankelijkheid van geautomatiseerde analyses brengt ook risico’s met zich mee: als de onderliggende data‑kwaliteit of de AI‑interpretatie niet adequaat wordt gecontroleerd, kunnen beleidsbeslissingen gebaseerd zijn op foutieve inzichten. Het is daarom essentieel om een evenwicht te vinden tussen de efficiëntie van AI‑ondersteunde processen en de noodzaak van rigoureuze, menselijke validatie om duurzame en betrouwbare beleidsresultaten te garanderen.
Voor Nederlandstalige organisaties betekent dit een enorme tijdsbesparing bij het verzamelen en opschonen van data. Onderzoekers kunnen één natuurlijke‑taalvraag stellen en direct een bruikbare dataset, visualisatie of concept‑analyse ontvangen, zodat ze zich kunnen richten op interpretatie en beleidsontwerp in plaats van op data‑preparatie.
Bronnen
- Making global data easier to exploreGoogle · 17 september 2026
- UN turns to Google to make its global data ready for AI agentsTechCrunch · 17 september 2026
- L'ONU ouvre ses statistiques officielles aux agents d'IAZDNET France · 18 september 2026