إطلاق Jina AI لنموذج jina-ocr-v1: محلل مستندات منخفض التكلفة بمعمارية MoE وتفكيك تكهني
أطلقت Jina AI، المتحالفة الآن مع Elastic، نموذج jina-ocr-v1 الذي يضم 3.4 مليار معلمة ويحوّل ملفات PDF والمسحات والجدول والفواتير إلى تنسيق Markdown منظم مع تقليل تكاليف الاستدلال على وحدات معالجة الرسومات ذات الميزانية المحدودة.
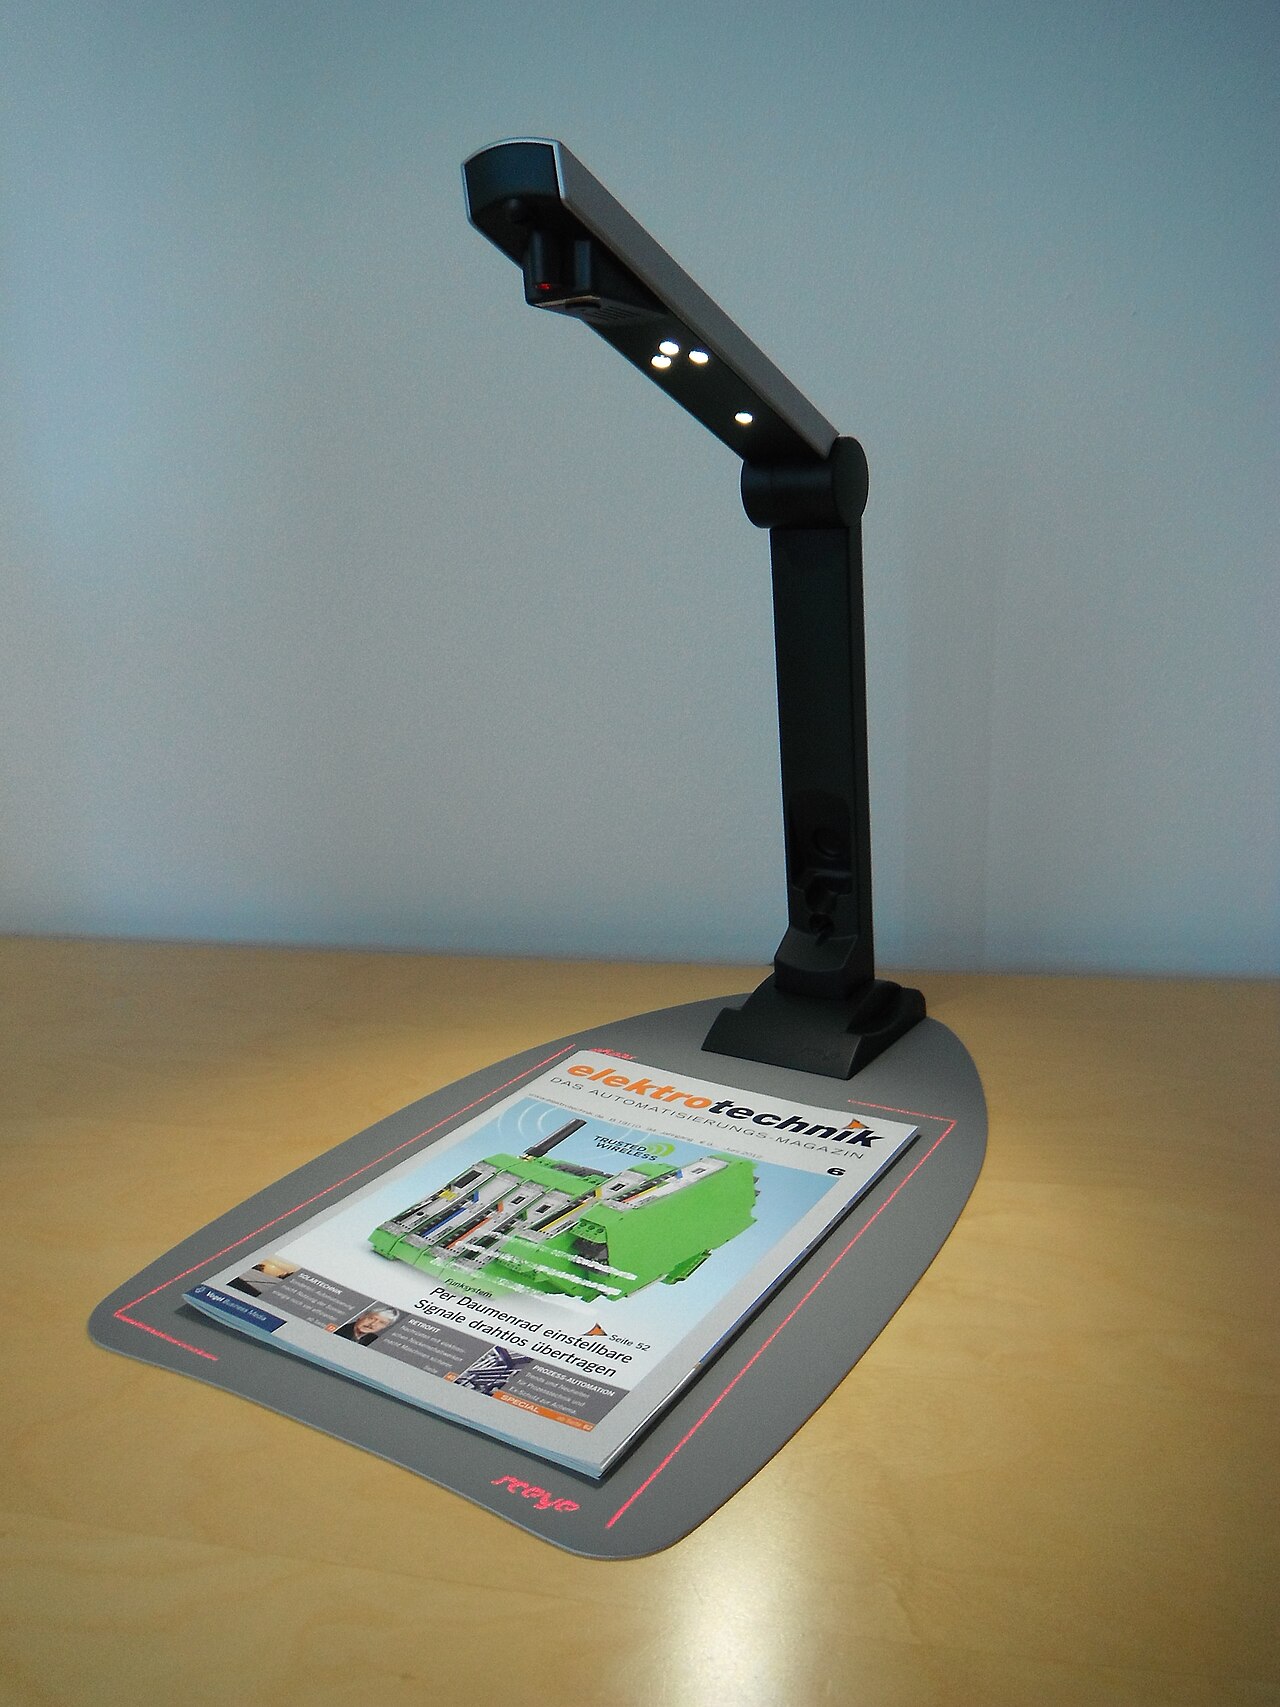
أعلنت Jina AI عن توفر نموذج jina-ocr-v1، وهو نموذج لتحليل المستندات يحول ملفات PDF والصور الممسوحة والجدول والرسوم البيانية والفواتير إلى تنسيق Markdown منظم. يُدمج النموذج كجزء من تكامل Jina مع Elastic، مما يسهل نشره ضمن خطوط البحث والتحليل القائمة.
يحتوي النموذج على 3.4 مليار معلمة، لكن بنية mixture‑of‑experts (MoE) تنشط نحو 570 مليون معلمة فقط لكل رمز. هذا التفعيل الانتقائي هو الآلية الأساسية التي تقلل من تكلفة الاستدلال على وحدات معالجة رسومات رخيصة.
ترميز بصري فعال
يقوم مشفر jina‑ocr‑v1 بضغط صفحة بحجم 1 024 × 1 024 بكسل إلى 256 رمزًا بصريًا. عند تفعيل الوضع الديناميكي، يمكن إضافة ما يصل إلى تسع مربعات محلية، مما يرفع عدد الرموز إلى حد أقصى 1 156. يتيح هذا الميزانية المرنة للرموز للنموذج الحفاظ على تفاصيل دقيقة في التخطيطات المعقدة دون استنزاف الذاكرة.
تفكيك تكهني باستخدام FastMTP
رأس تفكيك تكهني جديد، FastMTP، يتوقع ثلاثة رموز مسبقًا ويؤكدها بطريقة جشعة. يضمن هذا النهج أن الناتج النهائي يطابق ما ينتجه المفكك التقليدي مع تقليل عدد خطوات التفكيك بنحو النصف.
أظهرت اختبارات مجموعة OmniDocBench v1.6 أن jina‑ocr‑v1 حصل على درجة 91.14، ووصل إلى 83.4 في اختبار olmOCR‑Bench. رغم أن هذه الأرقام لا تجعله في صدارة تصنيفات الجودة الصرفة، فإن نقطة البيع الرئيسية للنموذج هي كفاءته في الإنتاجية مقابل التكلفة.
على وحدة معالجة رسومات Nvidia A100 بذاكرة 40 جيجابايت ومع تزامن يبلغ 32، سجل الفريق سرعة معالجة قدرها 2.57 صفحة في الثانية. كانت هذه الإنتاجية الأعلى بين الأنظمة الأربعة عشر التي قورنت في الدراسة الداخلية، مما يبرز كفاءة النموذج على الأجهزة المتقدمة.
عند تشغيله على وحدة Nvidia L4 واحدة، يرفع FastMTP معدل توليد الرموز من 42.7 إلى 83.1 رمزًا في الثانية في الوضع النشط، أي تحسين بنسبة 1.95×. يثبت ذلك أن وحدات معالجة الرسومات ذات الميزانية المحدودة يمكنها تحقيق تحليل مستندات شبه لحظي مع استراتيجية التفكيك المناسبة.
حجم النموذج والترخيص
تستغرق أوزان النموذج بصيغة BF16 حوالي 6.8 جيجابايت وتستضيف على منصة Hugging Face تحت ترخيص CC BY‑NC 4.0. يسمح الترخيص بالاستخدام الأكاديمي والبحثي دون تكلفة، بينما تتطلب النشرات التجارية اتفاقية منفصلة مع Jina AI.
- 3.4 مليار معلمة إجمالية
- ≈570 مليون معلمة نشطة لكل رمز
- 256‑إلى‑1 156 رمزًا بصريًا لكل صفحة
- تفكيك تكهني FastMTP مع توقع 3 رموز مسبقًا
يدعم jina‑ocr‑v1 108 لغات وفقًا لورقة النموذج الرسمية. ومع ذلك، يقر المطورون بأن المسحات المتدهورة بشدة لا تزال تشكل نقطة ضعف، ويوصون بإدخال خطوة مراجعة بشرية للوثائق الحرجة.
ماذا يعني هذا للمنظمات الناطقة بالعربية
بالنسبة للمؤسسات العربية التي تحتاج إلى معالجة كميات كبيرة من المستندات المتنوعة—مثل العقود القانونية والفواتير والأوراق البحثية—يوفر jina‑ocr‑v1 حلًا اقتصاديًا يمكن تشغيله على وحدات معالجة رسومات متوسطة مثل Nvidia L4. يجمع النموذج بين كفاءة معلمات MoE وتفكيك FastMTP التكهني لتوفير إنتاجية أعلى دون التضحية بدقة تحويل Markdown. وبالتالي يمكن للمنظمات أتمتة المرحلة الأولى من استخراج المستندات مقابل جزء صغير من فاتورة الحوسبة السحابية، وتخصيص المراجعة البشرية فقط للماسحات الأكثر إشكالية، ودمج المخرجات مباشرةً في بنى بحث أو تحليلات مبنية على Elastic.
sources”: [{"titre":"jina-ocr-v1","editeur":"Jina AI","url":"https://jina.ai/models/jina-ocr-v1/","date":"2026-09-14"},{"titre":"Jina AI Releases jina-ocr-v1: A 3.4B MoE Document Parser With Built-In Speculative Decoding for Low-Budget GPUs","editeur":"MarkTechPost","url":"https://www.marktechpost.com/2026/09/18/jina-ai-releases-jina-ocr-v1-a-3-4b-moe-document-parser-with-built-in-speculative-decoding-for-low-budget-gpus/","date":"2026-09-18"}],
motsCles”: ["Jina AI","jina-ocr-v1","Mixture of Experts","FastMTP","استدلال GPU"],
publieLe”: "2026-09-19T07:24:42.805Z",
يُظهر الاعتماد على بنية mixture‑of‑experts (MoE) في النموذج قدرة واضحة على تقليل استهلاك الموارد أثناء الاستدلال، إذ يتم تنشيط جزء صغير فقط من المعلمات لكل رمز يتم معالجته. هذا السلوك يُحد من الحاجة إلى بطاقات رسومية عالية الأداء، لكنه يفرض قيوداً على استقرار الأداء عندما تتغير طبيعة المستندات بشكل غير متوقع، لأن اختيار الخبراء النشطين يعتمد على آلية داخلية قد لا تكون شفافة تماماً للمستخدم النهائي. لذلك، من الضروري إجراء اختبارات استقرائية دورية لتقييم مدى تذبذب استهلاك الذاكرة وسرعة المعالجة عبر مجموعات بيانات متنوعة.
آلية التفكيك التكهني FastMTP تُضيف طبقة من التوقع المسبق للرموز، ما يقلل عدد خطوات التفكيك بنحو النصف ويُسرّع توليد الرموز. رغم الفعالية الظاهرة، فإن الاعتماد على توقع ثلاث رموز مسبقاً قد يُدخل أخطاءً في الحالات التي تكون فيها بنية المستند غير نمطية أو تحتوي على عناصر رسومية غير مألوفة. لذا، يُنصح بتطبيق آلية مراجعة تصحيحية تلقائية تُقارن المخرجات المتوقعة مع نماذج تفكيك تقليدية لتحديد الانحرافات قبل الاعتماد الكامل على النتائج.
تُظهر النتائج التجريبية على مجموعات OmniDocBench وolmOCR‑Bench أن النموذج يحقق درجات جيدة ولكن ليست في صدارة القمم. هذا يدل على أن الكفاءة في التكلفة لا تترافق دائماً مع أعلى مستويات الدقة، ما يستدعي من المنظمات تقييم أولوياتها بين السرعة والموثوقية. من الناحية العملية، يمكن توجيه النموذج للمهام التي لا تتطلب دقة مفرطة، مثل استخراج جداول أو فواتير ذات تنسيق ثابت، مع ترك الفحوصات الدقيقة للخطوات اللاحقة التي تُجرى يدويًا أو عبر نماذج أكثر تخصصاً.
عند تشغيل النموذج على بطاقات رسومية ذات سعة ذاكرة محدودة مثل Nvidia L4، يُظهر التحسن في معدل توليد الرموز بفضل FastMTP أن النموذج قادر على تحقيق تحليل شبه لحظي. ومع ذلك، يبقى الحد الأقصى للرموز المتاحة للصفحة (من 256 إلى 1 156) عاملاً حاسماً في استهلاك الذاكرة، ما يعني أن المستندات ذات التعقيد البصري العالي قد تتطلب تقليل عدد الرموز أو تقسيم الصفحات لتجنب تجاوز حدود الذاكرة، وهو ما قد يضيف تعقيداً في مرحلة ما قبل المعالجة.
الترخيص المفتوح CC BY‑NC 4.0 يسمح باستخدام النموذج في الأوساط الأكاديمية والبحثية دون تكلفة، لكنه يمنع الاستعمال التجاري المباشر ما لم تُبرم اتفاقية خاصة مع الجهة المطورة. هذا يخلق حاجزاً أمام الشركات التي ترغب في دمج النموذج في منتجات مدفوعة، ما يستلزم إما التفاوض على تراخيص تجارية أو البحث عن بدائل مفتوحة المصدر ذات خصائص مشابهة، وهو ما قد يؤثر على تبني التقنية في السوق التجاري.
من منظور المنظمات الناطقة بالعربية، يمكن الاستفادة من القدرة على تحويل المستندات إلى تنسيق Markdown لتسهيل الفهرسة والبحث داخل أنظمة Elastic. ومع ذلك، فإن ضعف الأداء على المستندات المتدهورة أو ذات جودة مسح منخفضة يتطلب إدخال خطوة مراجعة بشرية لتأكيد صحة التحويل، ما يعني أن الأتمتة لا يمكن أن تكون شاملة تماماً. لذلك، يُنصح بتطبيق خط أنابيب هجين يجمع بين التحليل السريع للنموذج وتدقيق يدوي للملفات التي تُظهر مؤشرات جودة منخفضة، لضمان توازن بين الكفاءة التشغيلية ودقة المخرجات.
traductionDe”: "jina-ocr-v1-document-parser-low-cost-gpus",
المصادر
- jina-ocr-v1Jina AI · ١٤ سبتمبر ٢٠٢٦
- Jina AI Releases jina-ocr-v1: A 3.4B MoE Document Parser With Built-In Speculative Decoding for Low-Budget GPUsMarkTechPost · ١٨ سبتمبر ٢٠٢٦